
Jevなどの意思決定モデルも、プロンプトインジェクションで欺ける
ai and ml
ai and ml
研究者らは、118台のModel Context Protocol(MCP)サーバーに含まれるAIエージェントツール343個で、検証済みのセキュリティ脆弱性253件を特定しました。Cybersecurityconsulting これらの脆弱性は、大規模言語モデル(LLM)が生成した引数をソフトウェアが処理する際の弱点
研究により、AIエージェントはツール呼び出しをオウム返しさせるだけで、攻撃者が指定した呼び出しを実行させられることが判明しました。研究者らは、118のオープンソースMCPサーバーから、検証済みのセキュリティバグ253件も発見しています。
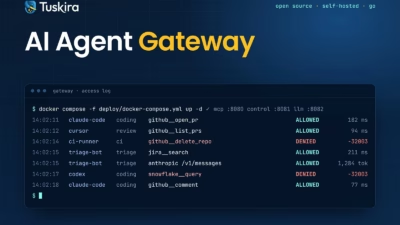
Tuskiraの「AI Agent Gateway」は、AIエージェントと、エージェントが呼び出すあらゆる対象との間に入るオープンソースのソリューションです。ここでいう対象には、GitHubやJiraなどのサービスに接続するMCPツールサーバーと、プロンプトの送信先となるモデルプロバイダーが含まれます
コスト圧力から、組織が検証の甘いモデルに傾くなか、コードが増えるほどリスクへの露出も増えます。 従来のサイバーセキュリティ上のリスクであれば、決定論的なツールでペネトレーションテストを実施できます。ソフトウェアがどう反応するかも
Salt Securityは、大規模言語モデル(LLM)を標的とした攻撃をMCPサーバー、ツール、API群にわたるその後の活動と結びつけて検知するために設計されたAI Detection and Response(AI-DR)機能を、自社のAgentic Security Platformにネイティブ
DevOpsチームに携わる誌者なら誰でも知っているように、AIを扱うのはサーカスのライオン使いのような仕事です。ライオンが台の上に座って合図どおりに吠えているうちは上司も観客も満足ですが、いつ暴走して舞台を一瞬で悲惨な結末に導くかわからない危険が常につきまといます。 実際のところ、本番環境でLLMを運用するということ
小型モデルがテキストを読み取り、「安全」だと判定します。ところがまさにそのテキストが、より高性能なAIに渡されると、内部に隠されたコマンドを見つけ出して実行してしまいます。Check Point Researchは、大規模言語モデルの手前に置かれた簡易フィルターをすり抜けることができる新たな手法「

セキュリティ研究者らは、軽量なAI安全フィルターをすり抜ける悪意ある指示の潜伏を可能にするプロンプト難読化技術「PuzzleMask」を公表しました。 この手法は、ポリシー違反となる指示を、一見ごく普通に見える平易な英文の中に隠すというものです。 従来のプロンプト隠蔽手法とは異なり、PuzzleMaskはBase64
研究者らは、目に見えないHTMLを使ってAIメール要約ツールに隠された指示を注入し、ユーザーに提示される要約内容を密かに操作できることを実証しました。 セキュリティ研究者らは、受信トレイに表示されているメールと
すべての記事を読み込みました