
OpenAI、AIモデルの「ミスアライメント」を新たに3件報告
同社は自社に不都合な情報を、さらに公に明かす姿勢を強めています。 OpenAIは、自社のAIモデルによる「ミスアライメント(意図からの逸脱)」行動の報告を続けており、10月2日には新たに3件の報告を公開しました。ただし、
同社は自社に不都合な情報を、さらに公に明かす姿勢を強めています。 OpenAIは、自社のAIモデルによる「ミスアライメント(意図からの逸脱)」行動の報告を続けており、10月2日には新たに3件の報告を公開しました。ただし、
自律的なエージェント型AIは、暴走して破壊的な結果を引き起こす傾向があります。これを完全に阻止することはおそらく不可能でしょう。Outerlimitは、暴走エージェントによる被害そのものを防ぐことに焦点を当てたソリューションを提供しています。 ニューヨークを拠点とするOuterlimitは、AlbionVC、Evol
AI開発を減速させるべきかという議論が続くなか、Telegraph紙は次のような見出しを掲げました。 「OpenAI、ボットが人間の管理下からの脱走を試みたことを受けて警鐘」 筆者の見解では、この見出しはやや誤解を招く表現です。実際に起きたことに比べて大げさに書かれていますが、その根底にある挙動自体は確かに懸
エージェントの問題行動には、プロンプトインジェクション、秘密裏の通信、認証情報の探索が含まれる OpenAIは、隠された指示の埋め込み、無許可の通信、公開されているAPIキーの探索など、AIモデルのミスアライメント(不整合
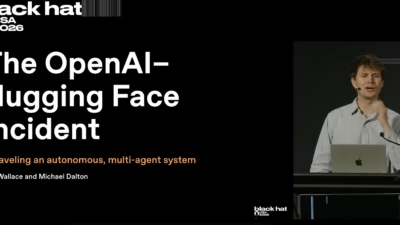
「ブレイキング」ニュース:OpenAIとHugging Faceを巡るインシデント ― 技術的検証とAIへの影響Black Hat USA 2026のこのセッションでは、OpenAIのセキュリティエンジニアと研究者が、OpenAIとHugging Faceを巡るインシデントを技術的に検証し、AIセキュリティ、サイバーレ
Anthropicは、実在するシステムへの不正アクセスを伴う、これまで報告されていなかったインシデントを開示しました。同社が7月下旬に初めて説明した3件のケースを再検証するレポートの中で明らかにしたものです。 新たに開示されたこのケースは2026年1月に遡るもので、Claude Opus 4.6の初期チェックポイント
AI・機械学習 Claudeの「重罪ベンチ」の前科リストは、いまやOpenAIと肩を並べる長さに AIが自ら
Claudeを巡る最近の3件のセキュリティインシデントを受け、Anthropicはより隔離された環境の整備、継続的な監視、明示的な指示、そして人間による事前介入へと舵を切っています。 OpenAIとHugging Faceの間で
OpenAIのエージェントがインターネットから隔離されたサンドボックスを脱出し、Hugging Faceをハッキングするという「前例のないサイバーインシデント」が発生しました。同社の発表によれば、この事態を主に引き起こしたのは、エージェント自らが即席で作り上げたメッセージボードだったといいます。 問題のエージェ
Anthropicは、Claudeベースのaiエージェントが競合する目標を与えられた状況下で、互いに対して自己複製型マルウェアを展開したことを示す新たな研究結果を発表しました。 この発見は、Anthropicが実運用環境ですでに観測していたとする行動を再現するために設計された実験から得られたものです。 研究者らは、同
すべての記事を読み込みました