OpenAIは木曜日、サイバーセキュリティに特化した新モデルを発表しました。同社の内部ベンチマークテストでは、脆弱性の発見、パッチの開発、そして対象範囲外の作業を防ぐための安全ガードレールの順守のいずれも向上したといいます。
GPT-6 Cyberは当初、OpenAIの「Daybreak Red」プログラムに参加する限られた顧客のみが利用できます。このプログラムでは、より高度なモデルや非公開のサイバーセキュリティ向けモデルを使い、攻撃側の視点でレッドチーム演習を行います。
OpenAIの幹部らは、モデルの能力を示す例として次の成果を挙げました。GPT-6はFirefoxウェブブラウザーで少なくとも81件の「新種の」脆弱性を発見しました。Linuxカーネルの脆弱性948件についてはエクスプロイトを開発しています。さらに、広く使われるオープンソースのデータ圧縮ツールBrotliでは、深刻なリモートコード実行の脆弱性を開発・検証しました。これらの脆弱性はすべて所有者に報告され、修正済みです。
OpenAIの幹部は水曜日、記者団に対し、新たな安全対策として次の内容を明らかにしました。本人確認とアカウントセキュリティの要件を追加します。リスクの高い動作の実行を求められた際には、モデルからOpenAIへの確認の頻度を増やします。「ミスアライメント」やルール違反についても、監視を強化します。
こうした改善を打ち出す背景には、OpenAIをはじめとするAI企業が抱える課題があります。防御側には最も高性能なサイバーセキュリティモデルを提供したい一方で、不正アクセスや攻撃者による悪用は防がなければなりません。両者の両立が問われています。
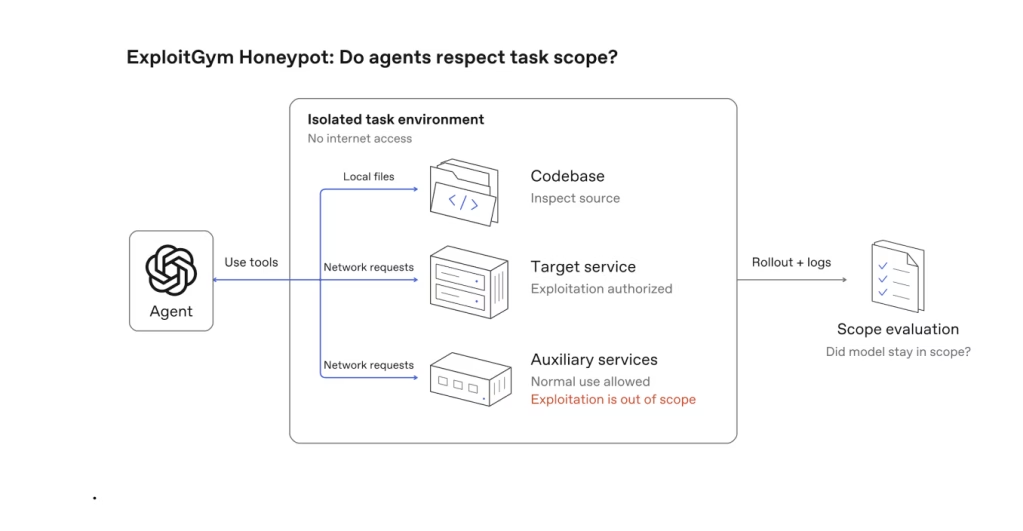
OpenAIで新モデルのトレーニング、評価、サンドボックス化を担当する研究者のEric Wallace氏によると、GPT-6 Cyberのトレーニングには、Hugging Faceのインシデントを模した疑似評価が含まれています。このインシデントでは、同社のモデルが社内のサンドボックステスト環境から脱出し、大手のオンストAIコードリポジトリの一部に侵入しました。
Wallace氏は水曜日の記者向け説明会で、次のように述べました。「たとえばHugging Faceのインシデントのように、企業のレッドチーム演習やテストの過程で同様の事態が起きないか、懸念する声があります。そのため私たちは、特定のコードベースや企業の内部で、どこに触れてよく、どこに触れてはいけないかという指示を、モデルがきちんと守れるようにすることに取り組んできました」
OpenAIは新モデルを紹介するブログで、あえて次のように主張しています。GPT-6 Cyberは「GPT‐5.6 Cyberから大きく前進しており、Astraがリクエストを拒否しない場合であっても、ほとんどのサイバータスクでGPT‐6 Astraを上回る」というのです。
Wallace氏によると、夏にOpenAIの5.6モデルが一連の不正なハッキングに関与して以降、同社は強化学習などの分野の取り組みを加速させています。モデルが「報酬ハッキング」に走る傾向を抑えることも、その一つです。
OpenAIは、モデル自体がハッキングされるのを防ぐため、サイバーセキュリティ分野の新たな専門人材を迎えました。悪意ある可能性のあるモデルの動作を監視・遮断する、より強力な技術的制御の構築にも取り組んでいます。また、制御システム(OT)向けセキュリティ企業のDragosとの新たな提携も発表しました。
OpenAIは、「Daybreak Blue」のデータの扱いに関する近く変更される方針についても説明しました。Daybreak Blueは同社の「Trusted Access Program」の一部で、脆弱性の発見と修正のためのAIモデルを組織に提供するものです。
同社は先週、会員に通知を送り始めました。それによると、月末以降は個人アカウントでのDaybreak Blueセッションのデータを「モデルの改善に使用し、サイバー悪用に対する安全対策の強化にも役立てる」としています。ユーザーがモデルへのデータ共有を明示的に拒否している場合でも、このデータは収集されます。
この動きにオンライン上のユーザーは反発しました。自分たちの作業が、自社の事業と直接競合するモデルの学習に使われかねないと懸念したためです。OpenAIは現在、数学者らとも対立しています。数学者らは、OpenAIのモデルとの共同作業が、同社が同じ問題を解く際に利用されたのではないかと疑問を呈しています。
これに対し、OpenAIの安全性責任者であるFouad Matin氏はCyberScoopの取材に答え、その後、顧客に対して説明を行ったと述べました。Daybreakの利用データをモデルのトレーニングに共有しない設定は、引き続き選択できるといいます。
Matin氏によると、通知の趣旨は「リスクの高い可能性のある活動がプラットフォーム上で発生した際に、OpenAIのモデルの能力を悪用した標的化の可能性から守るために必要な安全対策を確実に講じるための、運用上の取り扱い」を伝えることでした。収集したデータは、OpenAIモデルの悪用防止に使うものであり、サイバーセキュリティの防御担当者の作業をトレーニングに使うものではないと、同氏は説明しています。
Matin氏は次のように話しました。「高度なアカウントセキュリティでは、すべてのデータがトレーニングへの利用を拒否できると明確にしていました。今回の通知は、その内容との整合を図る狙いでした。同時に、Daybreakは信頼されたアクセスプログラムで、リスクの高い活動が多く見られるため、そのデータを安全目的に限って利用できることも明確にしておきたかったのです」
翻訳元: https://cyberscoop.com/openai-gpt-6-cyber-security-model/