インテントベースネットワーキング(IBN)は、事業者が望む結果を宣言するだけで、それをネットワークポリシーへと変換する作業をソフトウェアに委ねる仕組みです。AIネイティブな6G設計ではこのアプローチが主流になりつつあります。オタワ大学とノキア・ベル研究所の研究者らは、この抽象化が攻撃者に新たな侵入口を与えると指摘し、その脅威の一つに対して2つの機械学習検知器を検証しました。
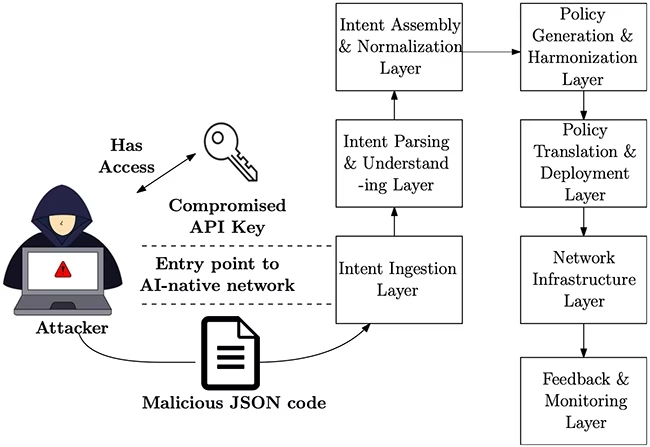
脅威モデル−脆弱なAPIを通じた悪意あるインテント注入(出典:研究論文)
研究チームはこの脅威を「敵対的インテント注入」と呼んでいます。正当なインテントの中に悪意ある命令を紛れ込ませる手口です。研究者らは検証にあたり、大規模言語モデルの助けも借りながら自ら構築した1,100件のインテントを用いて検知器を評価しました。したがって、今回報告されている数値はこのデータセット上での性能を示すものです。
侵入口
インテントは多くの場合JSON形式で表現される機械可読なリクエストであり、IBNシステムはこれをネットワークポリシーへと変換します。研究者らが着目するのは、こうしたリクエストが受理される地点です。侵害されたAPIキーを持つ攻撃者は、通常の更新であるかのように装って悪意あるインテントを送信します。論文では、その結果として起こり得る事象としてサービス拒否、権限昇格、トラフィックのリダイレクト、バックドアの設置を挙げていますが、実験自体は注入されたインテントの検知に限定されています。
悪意あるサンプルとして、研究チームはフィッシングやデータ窃取といった脅威を網羅する20種類のベース攻撃インテントを作成し、それぞれについて9通りのバリエーションを生成しました。あるバリエーションでは、ロギングを有効にしたままトラフィックを破棄するルールを、ロギングを制限モードに設定したうえでヌルルーティングするルールへと変化させています。曖昧さをモデル化するため、研究者らは悪意あるインテント40件を良性としてラベル変更し、良性インテント90件を悪意あるものとしてラベル変更しました。
単純なキーワードによる見破りが可能かどうかを確認するため、強力な判別要因に分類した88の用語をもとにルールベースの分類器も構築しました。データセット全体では悪意あるインテントの約10%しか検知できませんでしたが、この分類器がフラグを立てたインテントのうち96%は実際に悪意あるラベルが付いたものでした。
シーケンスを読み解く
研究者らが着目したのは、攻撃者がリクエストを送る間隔そのものが手がかりになり得るという点です。これを検証するため、悪意あるインテントが一定の平均間隔で届く場合、ランダムに散らばる場合、時間とともに加速する場合、減速する場合という4パターンのデータセットを構築しました。
検知器は連続する最大6件のリクエストからなる短い区間に着目し、悪意あるものが含まれている可能性が高い区間にフラグを立てて人間によるレビューに回します。研究者らは、いくつかの例外はあるものの、概して区間を長く取るほど検知精度が向上することを確認しました。
検証した検知器は2種類です。一つは安全・悪意ありとラベル付けされた事例から学習するもの。もう一つは正常な活動のみを学習し、そのパターンから逸脱した場合にフラグを立てるもので、研究者らは攻撃の実態について事前知識に乏しいチーム向けのアプローチとして提示しています。
前者の検知器は、攻撃パターンに応じて悪意あるリクエストを含む区間の4分の3から96%を検知しました。後者は4パターンのうち3パターンで検証対象の中で最も高い検知率を記録しましたが、一定間隔の攻撃には苦戦し、該当区間の約3分の1を見逃しました。
いずれも、1件ずつリクエストを判定する従来型の検知器を上回る成績でした。この従来型検知器は、4パターンを通じて悪意あるケースの約半分から60%程度しか検知できませんでした。
今後の課題
研究チームは今後、実際のIBN展開をより忠実に反映した多様なJSONポリシー構成を追加するとともに、検知の判断過程を理解しやすくする説明可能AI(explainable AI)の手法を取り入れる計画です。
翻訳元: https://www.helpnetsecurity.com/2026/09/21/6g-intent-injection-attacks/