OpenAIは、同社AIモデルの保護された内部推論を大規模に抽出しようとする組織的なキャンペーンを阻止しました。同社は、1万5000件を超えるユーザーアカウントに関連する活動に対処しました。
OpenAIはこの攻撃を、敵対的なモデル蒸留の試みと位置づけています。攻撃者は、別のAIシステムの再現、訓練、強化に役立つモデルの出力や推論の痕跡を、組織的に引き出そうとしていました。
1万5000件超のアカウントを遮断
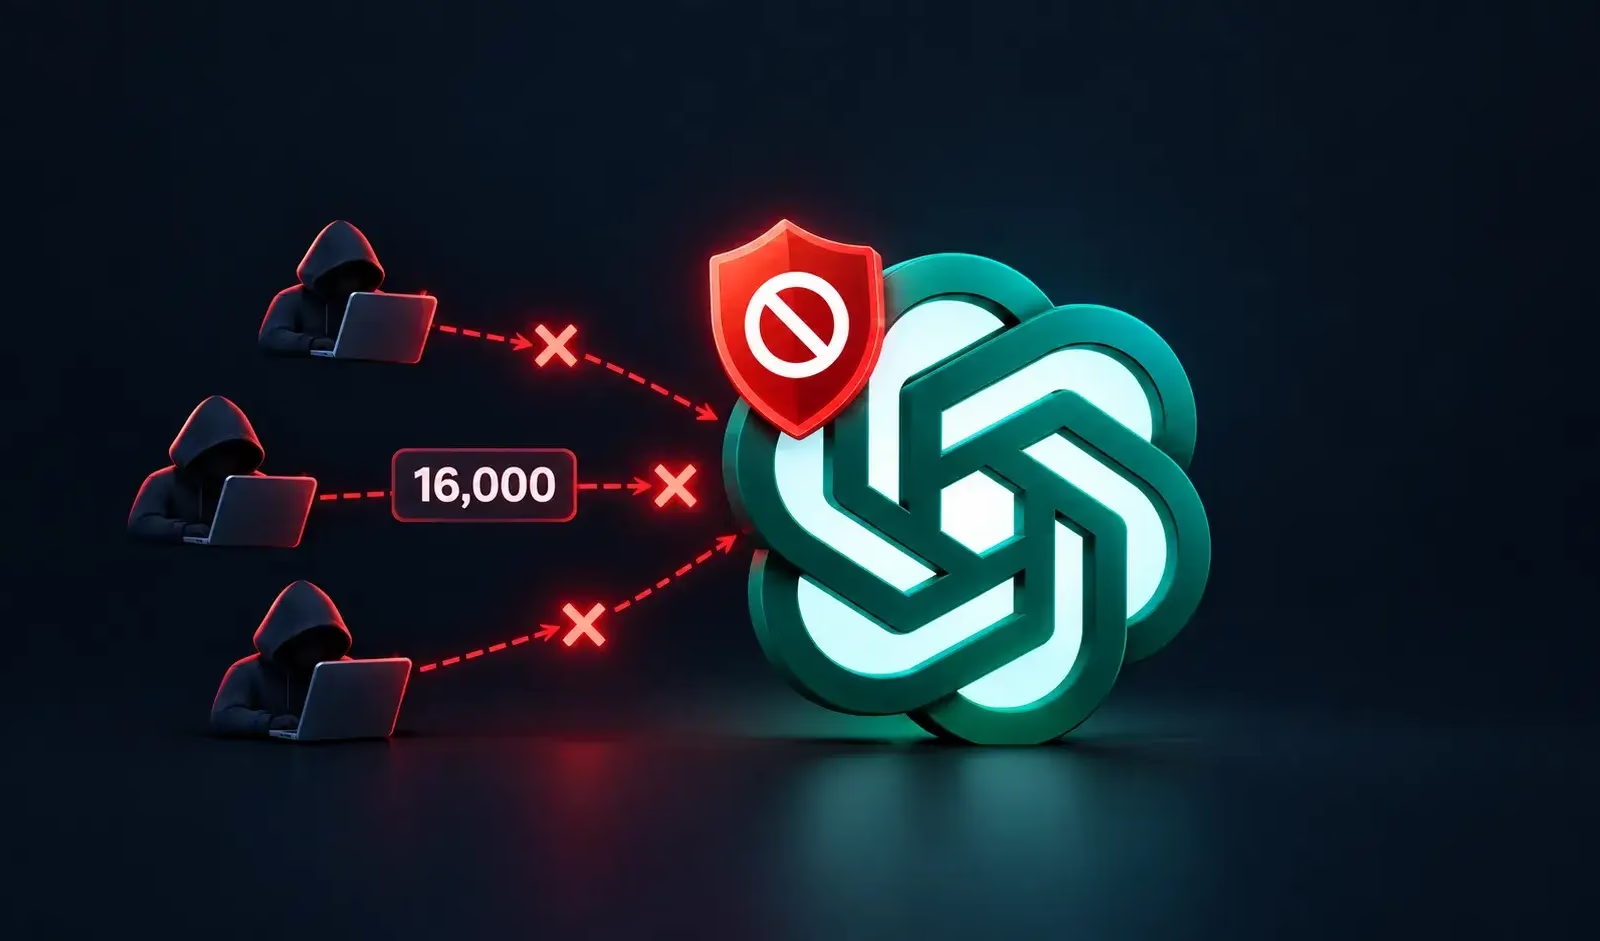
このキャンペーンの最初の活動が確認されたのは2026年7月の第1週で、当初は少量でした。しかし7月24日と25日に急増し、4,000人を超えるユーザーから、特定の抽出パターンを用いた約1万6000件のリクエストが送られました。
OpenAIは、これらの数字は推論抽出の「試行」を示すものであり、必ずしも成功した件数ではないと強調しています。調査を拡大した結果、1万5000件を超えるより広範なアカウント群で関連するプロンプトの挙動を特定しました。7月28日までにネットワーク全体を完全に遮断したということです。
従来型のセキュリティ侵害とは異なり、今回の活動では暗号の突破、内部データベースへのアクセス、保存された顧客の会話の侵害はありませんでした。
運営者は、モデルとのやり取りを操作し、本来は隠されている推論の成果物をリクエスト元から見える形で引き出していたとされます。確認された手口の一つは、ある会話から暗号化された推論をコピーして別の会話に投入し、隠された内容を復号して書き起こすよう指示するものでした。
保護された推論とは、モデルがユーザー向けの回答を生成する前に、タスクを処理するために用いる内部記録を指します。これを露出させると、最終的な回答からあえて省かれた情報が明らかになる可能性があります。
攻撃者がモデルの高度な能力を模倣する助けにもなりかねません。OpenAIは、この抽出行為は利用規約に違反するものであり、同社のプラットフォームに固有のセキュリティ問題ではないと説明しています。同様の手法が、他の最先端AIシステムにも影響しうると警告しました。
独立系のセキュリティ研究者も、責任ある開示を通じて関連する攻撃経路を報告しています。OpenAIはこれらの指摘を検証し、研究が広範な攻撃の類型を理解し、緩和策を加速させる助けになったと述べています。
Cross-sitescripting protection
今回の事案は、AIセキュリティで高まる懸念を浮き彫りにしました。攻撃者が制御するプロンプトや再利用可能なコンテキストによって、モデル間のやり取りが、意図しない情報を抜き出す経路になりうるという問題です。
OpenAIは、活動の相当部分がKimiの開発元であるMoonshot AIに関係する個人によるものだとしています。ただし、この期間に確認された運営者のすべてが単一の主体に属するかどうかは、断定できないと明言しました。Moonshot AIがキャンペーン全体を主導したとまでは主張していません。
緩和策と影響について、OpenAIは不正なアカウントを遮断または制限し、サインアップとインフラの管理を強化したと報告しています。関連するアカウントネットワークへの監視も拡大しました。
また、他のユーザーの暗号化された推論を持つ者がその内容にアクセスできてしまうリプレイ経路を塞ぎました。あわせて、隠された推論を露出しかねないストリーミング出力を検出して保留するチェックも追加しています。
今回の事案は、敵対的蒸留が知的財産の問題にとどまらない影響を持つことを示しています。保護されたモデルから抽出した推論は、元の開発者の安全対策を引き継がないまま高度な能力を移転しうるためです。デュアルユースの文脈では特に問題になります。
OpenAIによると、関連するインテリジェンスはFrontier Model Forumや政府の情報共有チャネルを通じて共有済みです。今後もツールの防御、分類器のカバレッジ、モデルの拒否動作、パートナーがホストする環境の保護を強化していく方針です。
SOCのアラート調査をすべて21分短縮。即座に得られるIOCのコンテキストでSOCを強化し、迅速に対応: SOCにTI Lookupを導入
翻訳元: https://gbhackers.com/openai-blocks-15000-requests/