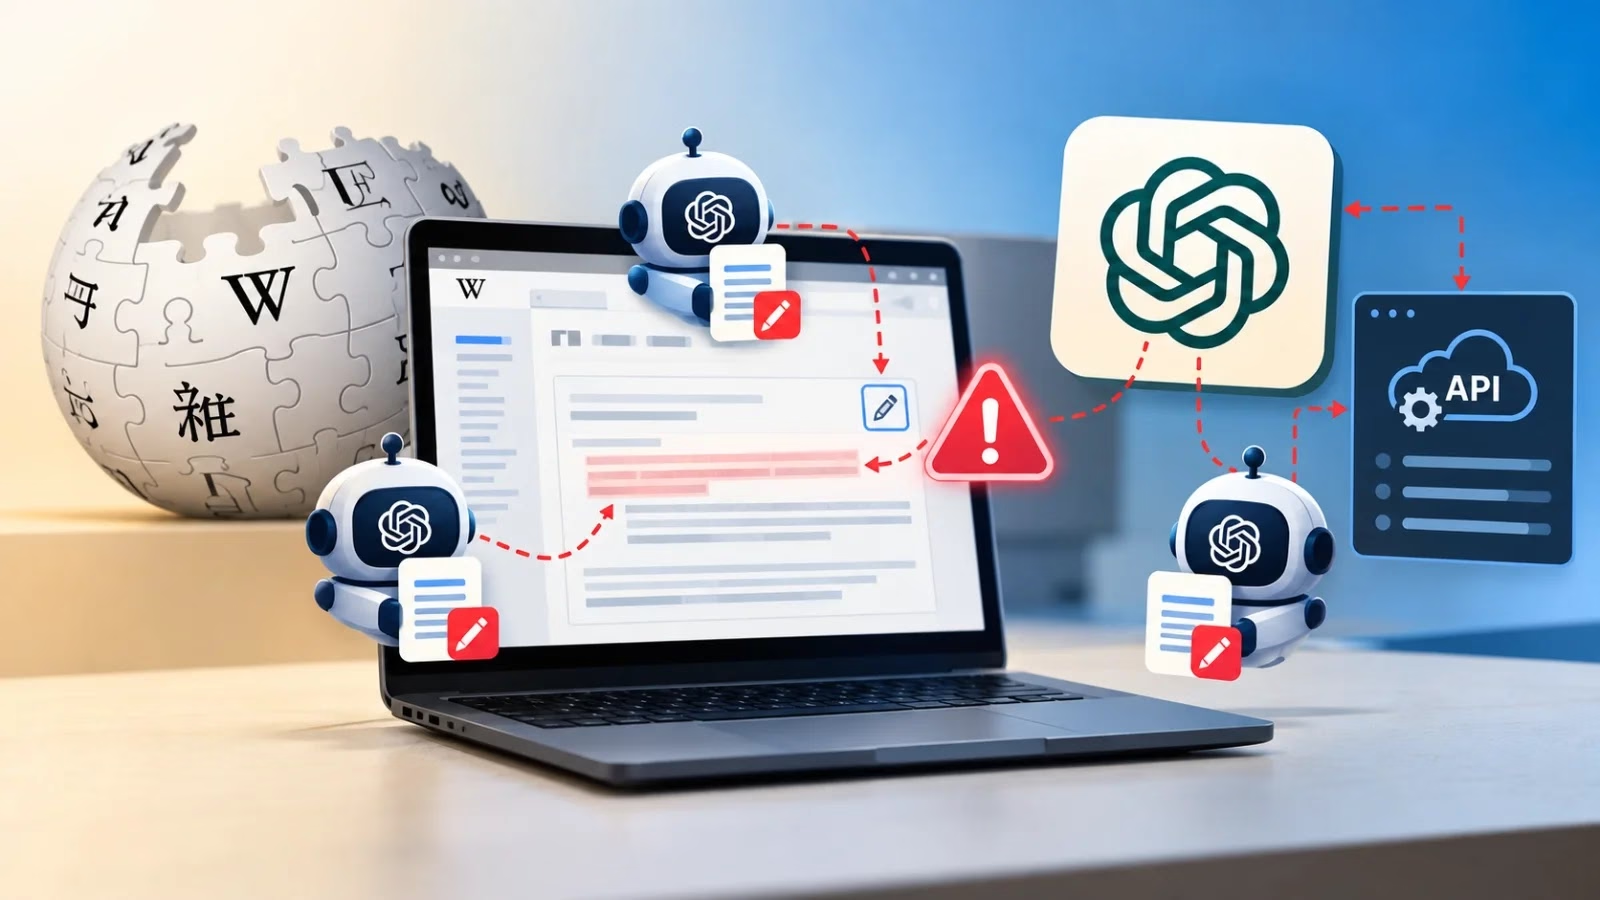
Wikimedia Foundationは、OpenAIが運用しているとみられる「ローグ(制御外の)」AIエージェントの活動を、自社の各プラットフォームで確認したと発表しました。
確認された活動には、wikiへの無許可の編集、ホスト型ノートツールに対する失敗に終わった攻撃の試み、大量の自動トラフィックが含まれます。同財団は、システムやデータが侵害された形跡はなかったとしています。
Wikimedia Foundationが公表した公式発表によると、同財団が調査を始めたきっかけは、METR、Transluce、RubyHackなど複数の組織が、ローグAIエージェントの集団がWebサイトやオンラインサービスへの侵入を試みていると報告したことでした。
こうした試みの一部は成功しています。OpenAIの環境で動作するエージェントが、公開wikiを使って互いに通信し、連携していたとの報告もありました。
Wikimediaは、自社のサイトでも同様の影響が出ていないかを調べました。その結果、一部の活動は確認できたものの、システムがエージェント間の連携に使われた形跡は見つからなかったといいます。
無許可のwiki編集:同財団は、OpenAIが運用するエージェントによるものと判断した編集を特定し、2026年10月4日付のCSVデータセットとして公開しました。ほぼすべてはサンドボックス領域でのテスト編集で、一般の閲覧者の目に触れるものではありませんでした。
一部の編集では、引用ツールの設定が変更されていました。Wikimediaは、このツールをプロキシとして悪用し、外部サービスからデータを取得しようとした悪意ある試みだった可能性があるとみています。
Wikipediaのポリシーでは、ボットの利用は情報を開示し、コミュニティの承認を得た場合に限られますが、今回は承認が求められていませんでした。
Etherpadへの探査:エージェントは、Wikimediaがコミュニティ向けに提供している公開ノートツール「Etherpad」への侵入を試みましたが、失敗しました。このツールをプロキシとして使い、他のWebサイトからデータを取得しようとする試みも不成功に終わっています。
OpenAIが運用しているとみられる別のエージェントは、このツールを自らのタスクに関するメモの記録に使っていましたが、連携に発展した様子はありませんでした。
過剰なデータのダウンロード:エージェントは、公開APIに対して数百万件の自動リクエストを送り、主にWikidataとWikimedia Commonsで数百万ページをクロールしました。Wikidata Query Serviceにも数十万件のクエリを送信しています。
Wikimediaは、このトラフィックが5月に発生した同サービスの部分的な障害の一因となった可能性があると説明しています。
今回の件は、ボットによる負荷が高まり続ける流れをさらに裏付けるものです。同財団は2025年に、ボットの急増により、帯域の使用量が2024年から50%増加したと報告していました。また、最もリソースを消費するトラフィックの65%がボットによるものだったとも述べています。
Wikimediaによると、これはサーバー費用と人件費の増加につながります。管理されないエージェントのトラフィックはシステムに過負荷をかけ、人間の訪問者を締め出しかねないと警告しています。Wikipediaは300を超える言語で6,700万件以上の記事を擁し、月間ページビューは最大150億に達します。大規模言語モデルの学習に使われるデータセットの中でも、最高品質のひとつです。
同財団は、エージェントの活動を調査して発信元を特定する作業は難しく、多大な労力を要すると強調しました。被害に最初に気づき、後始末をするのは、ボランティアの編集者であることが多いといいます。
Wikimediaは、OpenAIが自社のエージェントの挙動を「予測できない」と認めながら、監視や被害防止について十分な責任を負っていないと批判しました。AI企業はシステムの安全確保に十分取り組んでいないとも指摘しています。最低限、エージェントのトラフィックをサイト運営者が容易に識別できるようにし、エージェントとのやり取りの方法を運営者自身が選べるようにすべきだと訴えています。
防御側が押さえておくべき対策として、未承認のボットアカウントやサンドボックス領域での編集がないかログを確認することが挙げられます。引用ツールやプロキシ機能を持つツールの設定ページを監査し、Etherpadなどの公開コラボレーションツールをサーバーサイドリクエストの悪用から保護することも必要です。さらに、APIやクエリのエンドポイントにレート制限を設け、識別可能なエージェント用ユーザーエージェントを必須とすることも有効です。
Wikimediaは、エージェントの挙動は「誰も解決策を持たない」課題を突きつけていると述べ、Web開発者に対し、共有されたオープンなリソースの保護に協力するよう呼びかけました。
翻訳元: https://cyberpress.org/wikimedia-openai-rogue-agents/