
米国とカナダのIT・サイバーセキュリティ責任者700人を対象としたManageEngineの新しい調査によると、インシデントの発生後にサイバーセキュリティへの関心が高まっても、組織はやがて既存の優先事項や慣行に戻り、その関心は徐々に薄れていくことが分かりました。
(出典: ManageEngine)
回答者は全員、すでに侵害やインシデントを経験していました。それにもかかわらず、91%が自組織の現在のサイバーセキュリティ態勢を信頼していると回答しています。インシデント収束後もセキュリティが恒久的な優先事項になると答えたのはわずか8%でした。
この調査結果についてコメントしたサイバー心理学の研究者であるErik Huffman博士は、次のように述べています。「侵害は避けられないという考え方が、セキュリティの水準を引き下げてしまっています。私たちは長きにわたり『起きるかどうかではなく、いつ起きるかの問題だ』と言い続けてきました。しかし、結果に直接影響を及ぼすセキュリティプロセスは、私たち自身がコントロールできるものなのです」
予防策を上回る過信
回答者の3分の1は、どのような防御策を講じていても大規模なインシデントは避けられないと考えており、ほぼ同じ割合が「管理可能」とみなすリスクを受け入れています。既知の欠陥は、監査や実際のインシデントによって対応を迫られるまで放置されがちです。インシデントの余波以外の時期にも継続的にセキュリティへ注意を払っていると回答したのは、少数派にとどまりました。
Huffman氏は次のように述べています。「何をやっても悪いことは起きるという考え方を私たちが受け入れてしまっているのは、残念なことです。多くの組織は『安全』という結果を求めてセキュリティツールを購入します。しかし、セキュリティは単純に売り買いできるものではありません。それは絶えず進化し続けるプロセスであり、そのように扱われるべきなのです」
急速に薄れる緊迫感
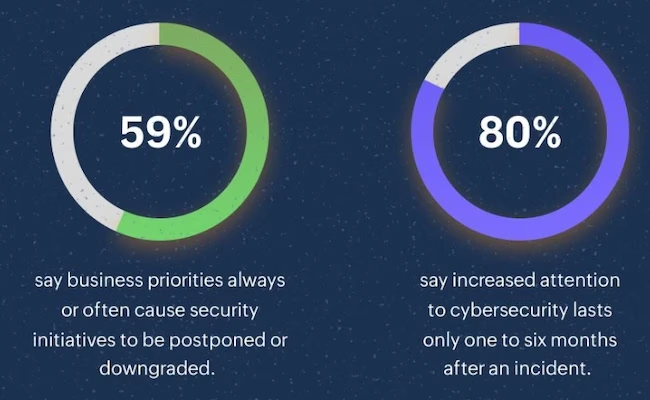
侵害の直後、組織は確かに対応に動きます。プロセスに関する議論が活発になり、チーム全体に緊迫感が広がり、パッチ適用やアクセス権の見直し、バックアップ体制の改善といった技術的な対策が実施されます。しかし、その関心が長続きすることはめったにありません。回答者の80%が、サイバーセキュリティへの関心の高まりは1カ月から6カ月しか持続せず、その後は薄れていくと回答しています。
組織のほぼ半数は、インシデント後も既存の体制や戦略をそのまま維持し、まったく大きな変更を行っていませんでした。インシデントの原因となった特定の欠陥を狙い撃ちにした対策を講じた組織はそれより少なく、ガバナンスや研修、エスカレーション体制について長期的かつ広範な変更を行った組織はさらに少数でした。
その背景には、多くの場合ビジネス上の優先事項があります。回答者の過半数が、競合する要求によってセキュリティ施策が先送りや格下げにされることが常態化していると回答し、5人に1人がまさにそれを直近のインシデントの主な要因として挙げています。
事後の発言を左右する「恐れ」
回答者によると、ほとんどの従業員はミスが発生した際、直ちにそれを報告するといいます。しかし83%が、報告後のインシデント対応の進め方には結果に対する恐れが影響していると認めており、少なからぬ割合が自組織の対応を「責任追及に偏っている」と表現しました。
Huffman氏はこう付け加えています。「サイバーセキュリティの世界では長らく恐怖に基づく文化が根付いており、それが多くの人が避けたいと感じる環境を作り出しています。インシデント対応は、誰が何をしたかを問うものであってはなりません。何が起きたのか、なぜ起きたのか、そして誰に影響を及ぼすのかに焦点を当てるべきです」
調査によると、問題の一因は責任の所在自体が曖昧なことにあります。回答者の5人に1人近くが、ある障害についてセキュリティ、IT、事業部門のどこが責任を負うべきか分からないと回答しました。この不透明さには代償が伴い、対応の遅れや事業の混乱、そして誰かがその欠陥を塞ぐ前にデータが流出してしまうリスクの高まりを招いています。
検証されないまま実行されるAIの提案
これらの組織ではAIの活用が広がっており、インシデント対応の自動化や脅威インテリジェンス、侵入テスト、脆弱性スキャンなどに利用されています。大多数の回答者が、AIのおかげで意思決定がしやすくなったと回答し、半数以上が効率性の向上やセキュリティ能力の強化につながったと評価しています。また、AIの活用によって多くの回答者がサイバーリスクをより受け入れやすくなったとも回答しています。
サイバーセキュリティにAIを活用している組織のうち、約3人に2人が、AIの提案について追加の検証なしにそのまま実行することが「よくある」または「常にある」と回答しています。
Huffman氏は次のように指摘しています。「AIが組織に新たなリスクをもたらしていることは間違いありません。大規模言語モデル(LLM)は、人々がAIシステムから得た情報に寄せる信頼度の高さゆえに、攻撃者にとって格好の標的となっています。私たちは『信頼はするが検証する』から『まず検証し、それから信頼する』へと発想を転換する必要があります」
研究者らは次のように結論付けています。「インシデントから真に学ぶ組織とは、単に迅速に対応できる組織ではありません。危機が去った後も可視性を維持し、リスクに関する判断を明確に示し、一時的な緊迫感を持続的な規律へと転換できる組織なのです」
翻訳元: https://www.helpnetsecurity.com/2026/09/14/manageengine-cybersecurity-breach-confidence-report/

