GitHubの「ReviewBench」は、ソフトウェアのリリース前に、AIコードレビューツールがどれだけ問題を検出できるかを測定するベンチマークです。同サイトでリサーチプレビューとして公開されており、ユーザーはレビューエージェントを比較したり、自社ツールを評価したりできます。
コードレビューとは、提案された変更に誤りがないかを確認する作業です。ReviewBenchは、AIレビュアーが問題を見つけ出す能力と、誤検知を避ける能力を測定します。ユーザーはテストデータの確認、結果の再現、改善状況の追跡が可能です。リーダーボードでは、問題の重大度、カテゴリー、スコアリングの重視点ごとに性能を確認できます。
ReviewBenchによるAIレビュアーの評価方法
ReviewBenchは、オープンソースライセンスの公開リポジトリ187件から抽出した219件のプルリクエスト(19のプログラミング言語)で、エージェントをテストします。各エージェントが既知の問題をいくつ見つけたか、指摘のうち妥当なものがどれだけあるか、そしてセキュリティ上の問題を含め、重大度やカテゴリーによって性能がどう変わるかを測定します。
MicrosoftのデータサイエンティストであるMichelle Zhou氏と、GitHubのシニア応用研究員であるAlejandro Carderera de Diego氏は、次のように説明しています。
「この分布には、意図的な調整を1点だけ加えています。言語とリポジトリの規模はGitHub全体の分布をそのまま反映していますが、プルリクエストの規模は、レビューに値する中規模以上のものに重みを置いています。これにより、ごく小さな単一ファイルの変更が過剰に含まれる事態を抑え、レビューの質が最も問われる、より実質的な複数ファイルにまたがるプルリクエストを多く残しています」
GitHubは、検証済みの指摘を集めた基準データ「ゴールデンセット」を、3段階で構築しました。まず、人間のレビュアー、後続のコード変更、解析ツール、AIモデルから指摘の候補を収集します。次に、同じ問題を指す指摘を統合し、共通の評価基準で査定しました。
ベンチマークは、2つのグループに分かれた6つの指標を報告します。グラウンデッド指標は、エージェントの指摘のうち既知の問題と一致する割合(適合率)と、既知の問題のうち検出できた割合(再現率)を測ります。F1スコアは、この両者を同等に扱います。
拡張版の適合率、再現率、F1では、ゴールデンセットに含まれない指摘も考慮します。AIジャッジがこうした追加の指摘が妥当かどうかを判定し、基準データに含まれていない問題を見つけたレビュアーにも評価を与えます。GitHubは、システム間の比較には主にグラウンデッド再現率を、各システムの個別評価には拡張指標を用いています。
ユーザーは、重大度やカテゴリーで結果を絞り込めます。さらにFβスコアのβを調整して、問題の検出を重視するか、誤検知の少なさを重視するかを選べます。リーダーボードは、その設定に応じて順位を更新します。
Copilotコードレビューでのパフォーマンス
GitHubは、Copilotコードレビューの変更をユーザーに試験提供する前に、ReviewBenchで評価しています。Copilotコードレビューのライト版を使った実験では、独立した複数のモデル実行結果を1つのレビューに統合したところ、ベンチマークのスコアと本番環境の結果がともに向上したと報告しています。
本番環境でのテストでは、本番の対照群と比べて、AIモデルがコード変更のきっかけになったと判定したレビューコメントの割合が8%上昇しました。再現率は13.6%上昇し、レビュー1件あたりのコストは8%下がっています。GitHubは、本番環境での再現率を、追加で必要になる人間によるレビューの量から測定しています。フィードバックの内容も、重大な問題や中程度の問題に重点が移り、軽微な提案は減りました。
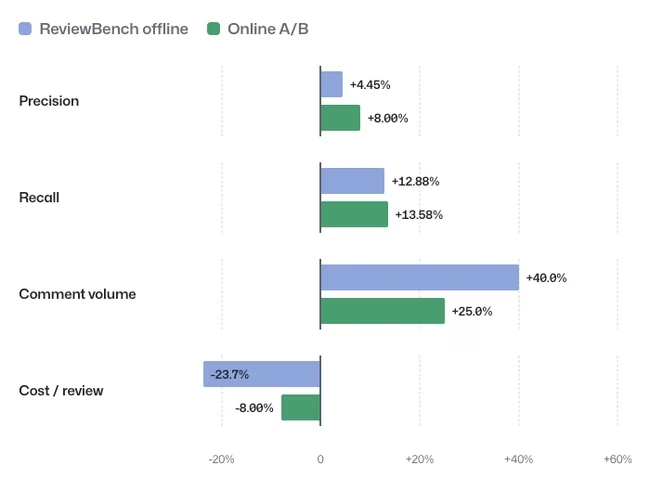
ライト版のアンサンブルレビューと、本番の単一レビュアーによる対照群の比較(出典:GitHub)
同社は、このベンチマークが本番でテストすべき更新の絞り込みに役立つとしています。ただし、影響の最終的な判断基準は、あくまでユーザーによるテストです。
AIレビュアーの登録方法
ユーザーはGitHubアカウントでReviewBenchにサインインし、コンテナイメージ、設定、モデルのアクセスキーを入力してエージェントを登録します。25件のプルリクエストからなるテストセットで性能を確認・調整したうえで、219件すべてを対象に3ラウンドを実行します。
ReviewBenchは、すべてのエージェントを同じAIジャッジでスコアリングします。スコアは、メンテナーが提出を承認するまで非公開です。公開されるのは、エージェントが初めてリーダーボードに載る場合か、過去のスコアを上回った場合です。
Michelle Zhou氏とAlejandro Carderera de Diego氏は、研究者や実務担当者に対し、自らのシステムを評価し、ベンチマークの前提を検証して、手法の改善に協力するよう呼びかけています。
翻訳元: https://www.helpnetsecurity.com/2026/10/06/github-reviewbench-ai-code-review-benchmark/