「Microsoft-Decision-1」は、意思決定のスコアリングに特化した小型モデルです。状況と質問、あらかじめ決められた選択肢を与えると、各選択肢について較正済みの確率を返します。
Microsoft の CTO オフィスでソフトウェアエンジニアリング担当VPを務めるAchint Srivastava氏は、次のように説明しています。「このモデルは、ルーティング、分類、優先順位付け、検証、ワークフロー制御を想定して設計されました。安全で信頼できる環境のもと、既存のアプリケーションやエージェント、ワークフローに意思決定のインテリジェンスを組み込みやすくなります」
Microsoft-Decision-1の仕組み
Microsoftによると、同モデルは36のベンチマーク、およそ15万問を対象に評価されました。いずれのベンチマークも、学習には使われていません。同社のベンチマークでは、速度で次点だったH2O-Lightning-4B v1.1より2.5倍高速でした。レイテンシの中央値では、GPT-6 Solの約35倍の速さです。
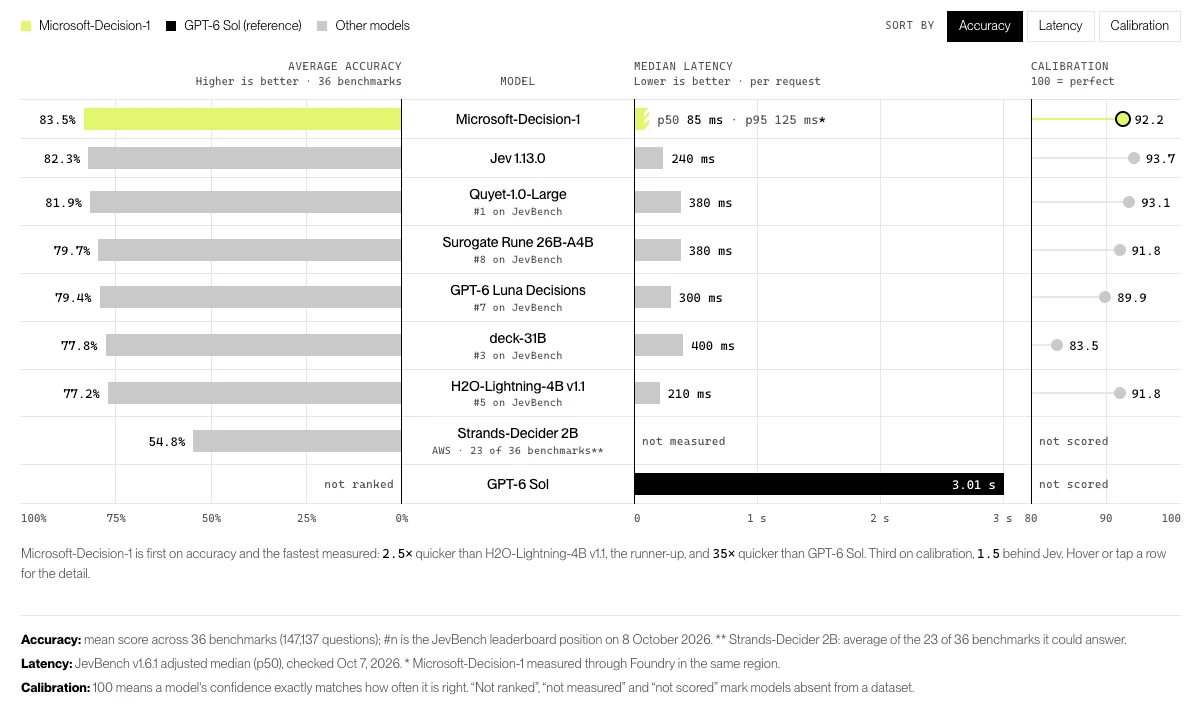
精度、レイテンシ、較正の比較(出典:Microsoft)
確率スコアは各回答に対するモデルの確信度を示します。アプリケーションは、このスコアをもとに、実行するか、判断を保留するか、レビューを求めるかを決められます。Microsoftは、想定する用途を代表する事例で、モデルと確信度のしきい値を検証するよう開発者に勧めています。
Microsoft-Decision-1は、Qwen3.5-9Bをベースに、1回の推論でスコアを出せるようポストトレーニングを施したものです。今後のバージョンでは、Microsoft AIやOpenAIのモデルなど、別のモデルをベースにする計画です。
構造化されたAPI呼び出しを通じて、はい/いいえの質問、多肢選択式の質問、評価尺度、ルーブリックに基づくAI応答やエージェント行動の採点に対応します。一方で、自由形式のテキスト生成や会話、翻訳、要約には向いていません。
同社は、モデル開発の課題として、速度、タスク横断の性能、堅牢性、確率の較正、安全性を挙げています。
社内でのテスト
Microsoftは、顧客フィードバックの分類、AI回答の評価、サービスインシデント時の関連情報の特定といったタスクで、Microsoft-Decision-1をテストしています。
Xboxの研究者は、アンケートやSTEAM、Xに寄せられた1万件超のフィードバックやレビューを、あらかじめ定義したカテゴリに分類するために使用しました。Microsoftによると、品質はGPT-6 Solと同等で、処理速度は14倍以上、コストは200分の1でした。
Copilotチームは、チャットやエージェントの応答を評価する能力を検証しました。Microsoftは、GPT5.6 Lunaに匹敵する結果が得られ、処理は100倍高速だったと報告しています。インシデント対応のテストでは、比較対象の大規模言語モデルより、関連情報をより正確かつ高速に取得できました。
Microsoftは、Microsoft Discoveryでもテストを行いました。ここではAIエージェントが実験結果を評価し、次の手順を見直します。同社によると、LLMベースのスコアと比べて評価スコアの一貫性は46倍高く、処理速度は3倍でした。適応的な再計画プロセス全体では、ほぼ4倍高速化しています。
このほかに想定される用途として、リクエストを処理するAIモデルの選択、定義された基準に照らしたコンテンツやコードのチェック、検索結果のランク付け、AIエージェントの次の行動の決定が挙げられています。
提供状況と価格
Microsoft-Decision-1は、Microsoft Foundryで一般提供されています。Foundryは、AIアプリケーションやエージェントを構築・実行するためのAzureのプラットフォームです。複数のAIモデルを単一のAPIとアカウントで利用できるOpenRouterからも利用できます。
価格は入力トークン100万個あたり0.042米ドルで、出力トークンは無料です。
翻訳元: https://www.helpnetsecurity.com/2026/10/12/microsoft-decision-1-model/