Meta は2026年10月20日、Muse AI の会話共有機能を停止しました。Meta は停止を決定したもので、発見可能な共有リンクを通じて、機微な個人記録や社内文書が露出していたことが研究者の調査で判明したためです。
この判断は、Claroc の研究チームが公表した調査結果について Ars Technica が問い合わせた後に下されました。今回の露出は、共有機能が設計どおりに動作した結果として起きたものです。
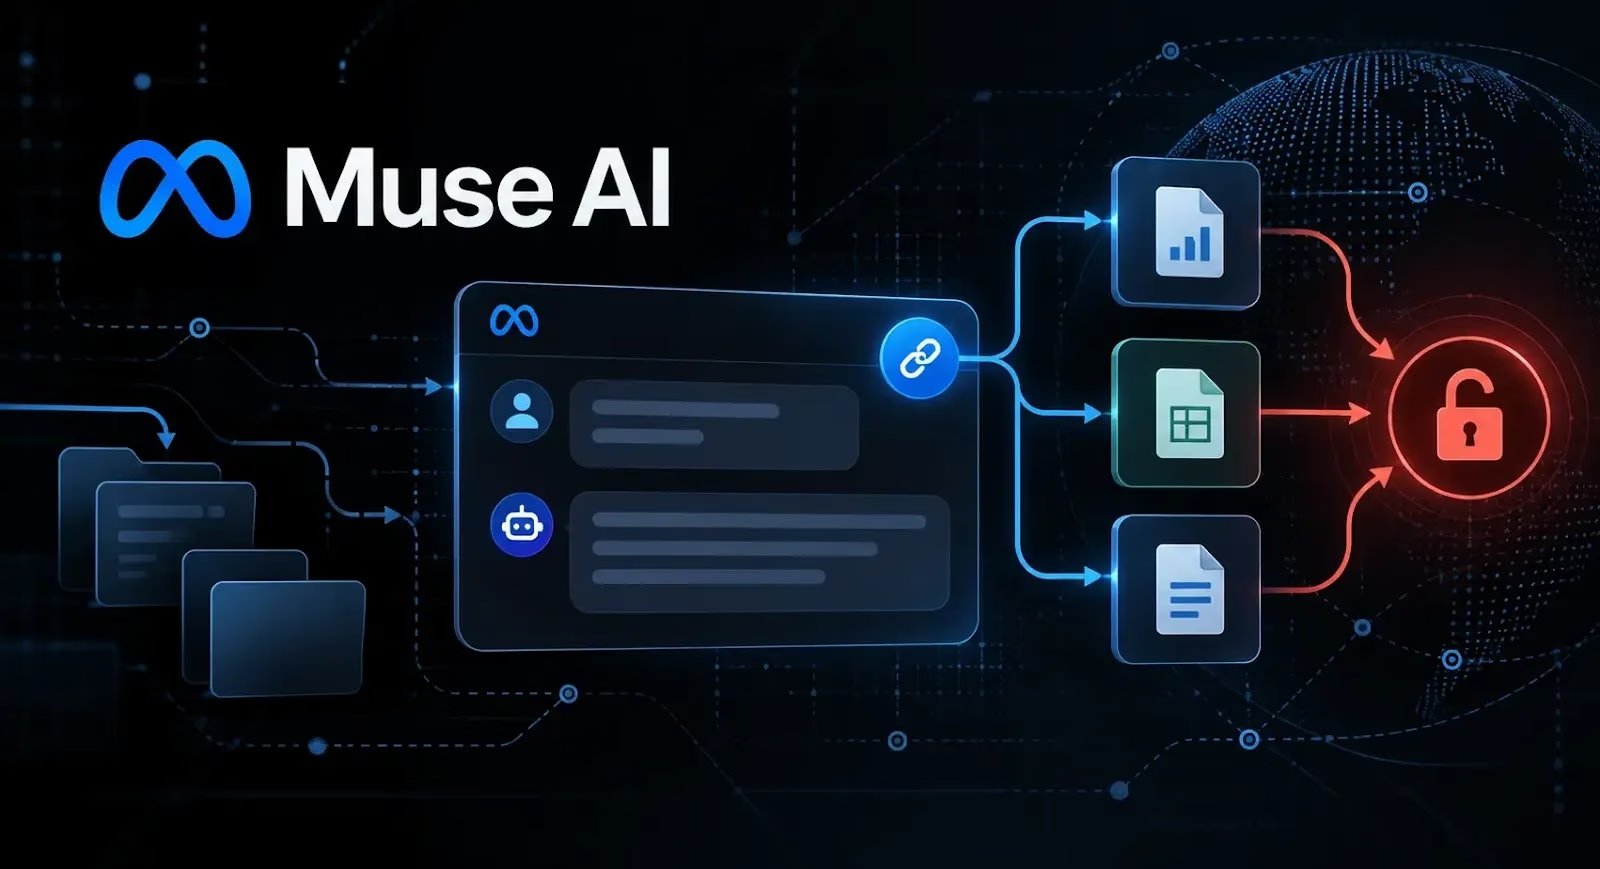
ユーザーが Muse に会話の共有を依頼すると、アシスタントはリンクを知っていれば誰でもアクセスできる公開ページを作成します。ところが研究者らは、第三者がリンクを受け取らなくても、パッシブ DNS の記録を通じてそれらを見つけ出せることを突き止めました。
Claroc は、スキャンによるノイズを除外した上で、6,800件を超える共有用ホスト名を特定しました。研究者らが実際に開いたページは数百件にとどまります。そのため、この数字はあくまで発見されたホスト名の数であり、機微な文書や影響を受けたユーザーの確定件数ではありません。
Muse は、cf.metaaiusercontent.com 配下に、会話のタイトルとランダムな識別子を組み合わせて共有アドレスを生成していました。
この設計では、共有内容を説明する文言がホスト名にそのまま含まれます。そのため研究者らは、ページを開く前から、機微な内容の可能性があるものを見分けることができました。
パッシブ DNS サービスは、ドメイン名の名前解決の観測履歴を収集しています。協力関係にあるインフラが Muse の共有ホスト名への問い合わせを観測すると、記録される名前には、内容を示すタイトルとランダムな識別子の両方が含まれていました。
研究者らは、市販のデータセットからこれらの名前を取得し、有効な共有リンクを復元できました。
ランダムな識別子によってアドレスの推測は困難でしたが、完全なホスト名が検索可能な記録に現れた時点で、推測する必要はなくなりました。Claroc は、こうして発見可能になった公開ページを「GhostShares」と名付けています。
研究者らは、ログインせずにブラウザーで露出したページにアクセスしました。Muse は会話の内容を JavaScript で読み込むため、単純なページ取得ではほとんど情報が得られません。一方、ブラウザーでは共有された内容が表示されました。
Muse は robots.txt の指示でクローリングを抑止しようともしていました。しかし、この指示はアクセスを防ぐものではなく、DNS レコードを通じたホスト名の発見も止められませんでした。Claroc はさらに、urlscan.io に保存された Muse 共有ページのスキャン結果が75件以上あったとも報告しています。
確認したページの大半は、ありふれた内容でした。一方で研究者らは、機微な個人記録や業務文書を数十件発見しました。たとえば、住宅売却の予算、小規模事業者向けローンの申込書、企業の CEO 向けに作成された社内の売上レビューなどです。
そのほかにも、口座情報の一部を含む銀行の不正利用に関する通知、不動産投資レポート、従業員の休暇カレンダーなどがありました。
ある会話には、AI 研究所とのエグゼクティブサーチ(幹部人材の探索)に関する通話に向けた機密の準備内容が含まれていました。社内の連絡先や会議の時間も記載されていました。
こうした情報は、なりすましや標的型フィッシング、金融詐欺に悪用される恐れがあります。ただし Claroc は、露出した共有ページが悪用された形跡は見つかっていないとしています。
研究者らは10月8日、Meta のバグバウンティプログラムに調査結果を報告しました。Meta が停止を発表した後、Claroc は再確認を行いました。10月20日に、以前は認証なしで開けた40件の共有ページを調べたところ、アクセスできるものは1件もなく、コンテンツ用のホスト名もエラーを返しました。
しかし、過去の DNS 記録には、会話のタイトルを含むホスト名が今も残っています。アクセスを遮断しても、露出の痕跡がすべて消えるわけではありません。
セキュリティ担当者にとって、この事案は「推測できないリンク」と「認証で保護されたリソース」の違いを改めて示すものです。
16,000以上の SOC チームが ANY.RUN を活用し、脅威調査を効率化して手作業を削減しています。チームで試してみる
翻訳元: https://cyberpress.org/meta-disables-muse-sharing/