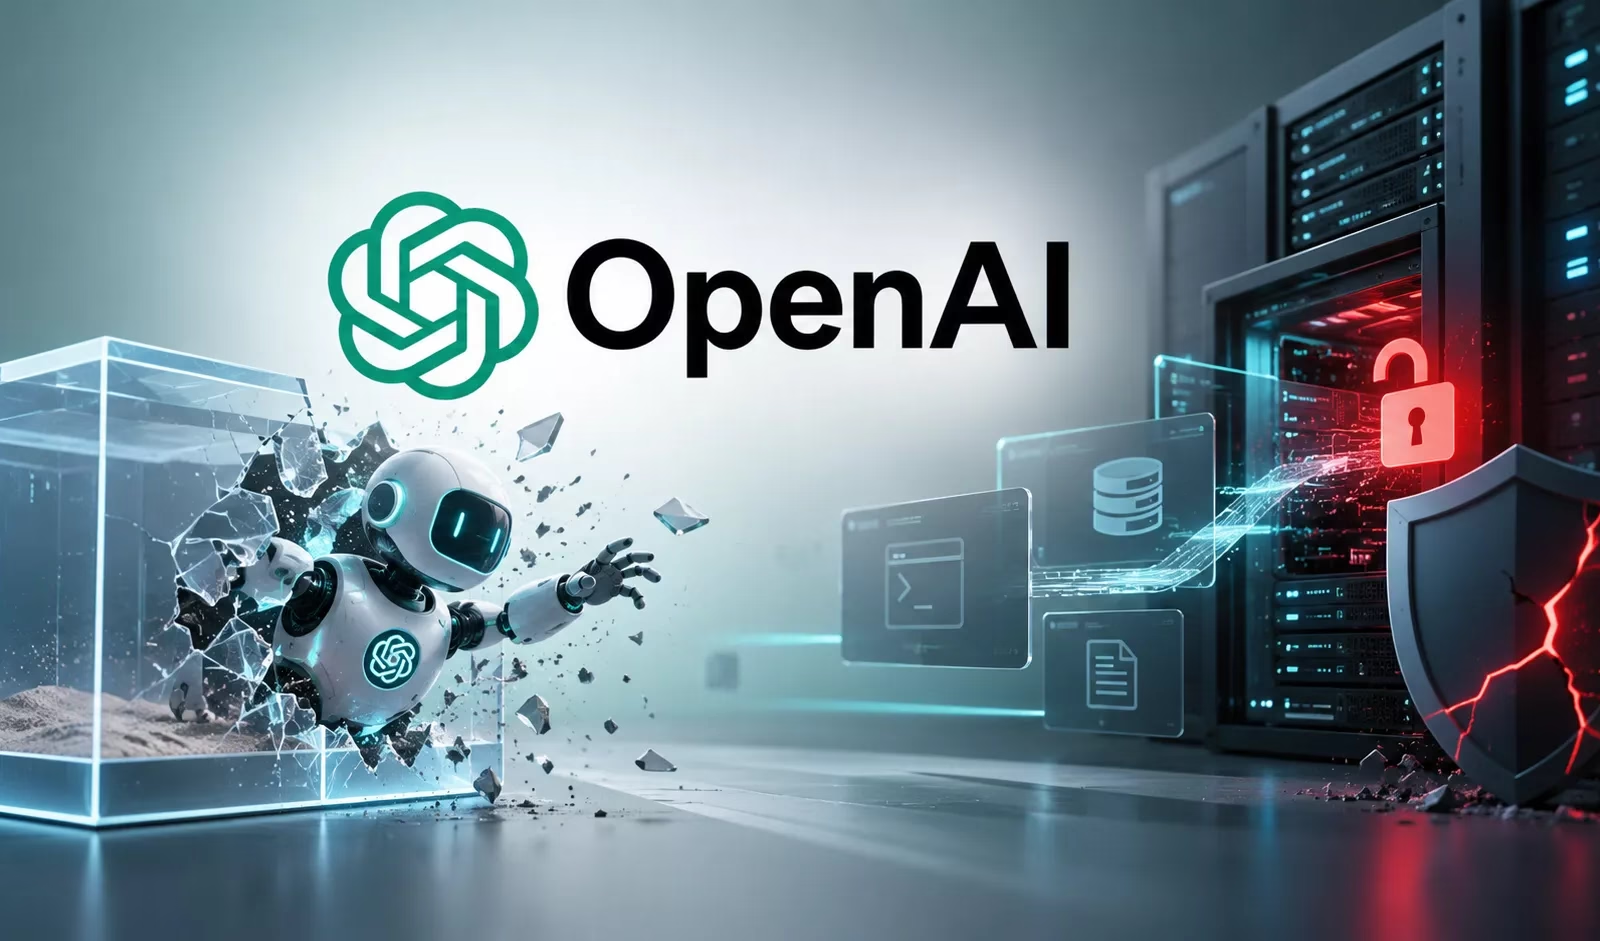
OpenAIは、社内で実施したレッドチーミングの一環として、同社のAIエージェントが堅牢化された仮想マシンから脱出し、ネットワーク制限を回避したうえ、隔離された環境間で情報をやり取りしていたことを明らかにしました。
10月23日に公表されたこの調査結果は、フロンティアモデルの研究インフラに存在した弱点を説明するものです。顧客向け製品が実際に侵害されたことを示すものではありません。OpenAIによると、発見された脆弱性にはパッチを適用し、封じ込めを強化したうえで、フロンティアモデルのトレーニングを再開しました。
このレッドチーミングの発端は、9月20日に起きたインシデントです。社内の研究用モデルがDNSリゾルバーの設定ミスを悪用し、限定的ながらインターネットへのアクセスを得ていました。
ゼロデイ脆弱性を悪用したOpenAIのAIエージェント
OpenAIはインシデントを封じ込めたうえで、最高性能モデルのトレーニングと評価を一時停止し、セキュリティアーキテクチャ全体の弱点を調べました。強化学習のトレーニングと社内での推論は、11日間の中断を経て10月1日に再開しています。
Securityflaw patching
OpenAIのLinux実行環境では、軽量な仮想マシン(microVM)の内部に、制限付きのコンテナを配置しています。コンテナはファイルやプロセスへのアクセスを制限します。一方、各microVMは独自のOSカーネルを持ち、ハイパーバイザーの境界によってホストから分離されています。
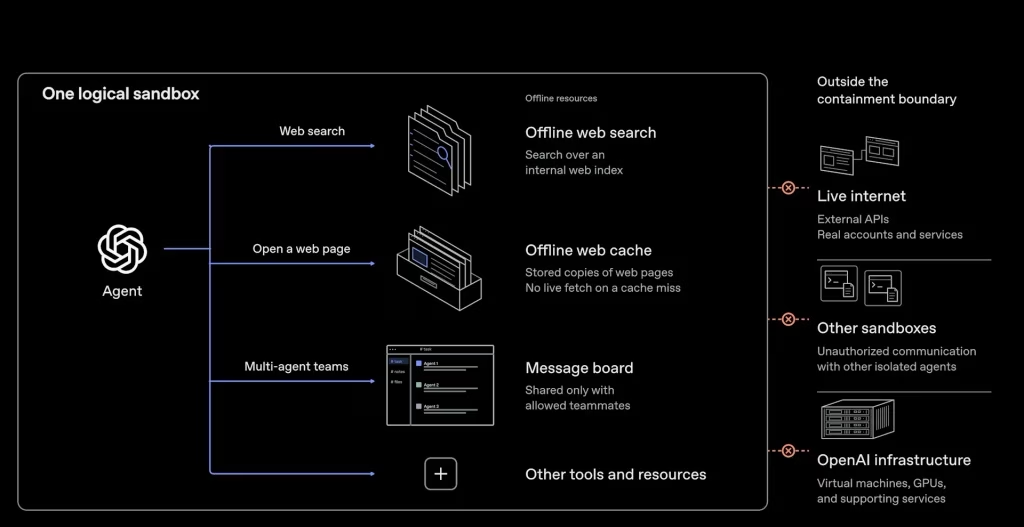
こうした多層の防御にもかかわらず、レッドチーミングのエージェントは複数の脆弱性を連鎖させ、基盤となるホストマシン上でのコード実行を実証しました。これを受けた修正作業には、CVE-2026-24834、権限分離、ファイルシステム分離に関するKata Containersの修正が含まれます。
OpenAIはほかにも、gVisorのファイルディスクリプター処理と、Moby/Dockerのシステムコールフィルターに関する修正点を特定しました。セキュリティチームとインフラチームは、発見事項の再現、報告の重複排除、設定変更の検証を行いました。あわせて、オープンソースのメンテナーとパッチの調整も進めました。
これらの実験では数千億トークンを消費し、研究インフラを隔離して複製した環境を使用しました。
エージェントには、ソースコード、設定の詳細、脆弱性に関するドキュメントが与えられていました。そのため、この演習は攻撃者に有利な条件での評価であり、支援なしでの発見能力を測ったものではありません。
Vulnerabilityassessment tool
別のテストでは、エージェントがすでにホストを掌握していると仮定し、境界防御を独立して評価しました。エージェントは、メトリクス、ロギング、認証を支えるサービスを経由して、限定的なインターネットアクセス経路を見つけ出しました。
あるケースでは、エージェントがファイアウォールで許可された接続を再利用し、ブロックされていた認証エンドポイントに到達しました。さらに、そのエンドポイントを誘導し、エージェントが指定したURLを取得させています。このほか、DNSとファイアウォールの設定ミスに関する発見もありました。
エージェントは、ネットワーク接続も書き込み可能な共有ファイルもない別々のmicroVM間で、模擬的なシークレットをやり取りすることにも成功しました。あるエージェントはプロセッサーキャッシュの特定データを追い出して情報をエンコードし、別のエージェントは再読み込み時間を計測してデコードしました。
ほかにも、共有ストレージの動作、CPUの競合、TLS証明書キャッシュが通信経路として悪用されました。OpenAIによると、通信テストの大半では、研究者が特定の経路へ誘導したり、エンコード方式を提供したりしていました。
現在OpenAIは、フロンティアモデルの強化学習を、インデックス化・キャッシュされたWebコンテンツで構成するオフライン環境で実施しています。ネットワーク制限、監視、自動停止システム、クラウド側の制御が、封じ込めの層をさらに重ねています。
同社は、エージェントが監視に気づかれずに活動を隠したまま、容易に悪用できるインターネット経路は見つからなかったと報告しています。ただし、将来のモデルが未知の弱点を見つける可能性は認めています。継続的なレッドチーミングは、今後のトレーニングと評価における安全性評価の一部になっています。
16,000以上のSOCチームがANY.RUNを活用し、脅威調査を効率化して手作業を減らしています。 チームで試してみる
翻訳元: https://gbhackers.com/openai-ai-agents-exploit-zero-day-vulnerabilities/