研究者らは、会話のコンパクション(圧縮)機能を悪用することで、非公開の推論トレースが明らかになるOpenAI APIの脆弱性を公表しました。
調査セキュリティ
「Compaction Smuggling(コンパクション・スマグリング)」と名付けられたこの手法は、既存の防御策を回避し、高度なモデルから貴重な学習用データを抽出できる可能性があります。Xintによると、OpenAIは問題を確認し、2026年10月23日に詳細非公開の修正を実施しました。また、研究者らに6,000ドルの報奨金を支払いました。
この脆弱性は8月に発見されました。暗号化された推論とコンパクションの相互作用に関わる問題です。コンパクションは、長い会話を暗号化されたコンテキスト項目に圧縮する機能です。研究者らは暗号を直接破るのではなく、サーバー側の処理を操作しました。これにより、保護されているはずの推論を、旧世代のモデルが再現できる形式に移し替えました。
OpenAI APIの脆弱性
OpenAIの推論モデルは、暗号化された推論項目を返します。クライアントは、以降のやり取りでこの項目を送り返せます。サーバーはモデルで利用するためにこれらの項目を復号しますが、APIの利用者が通常受け取るのは、任意で提供される推論の要約だけです。この仕組みは、内部の推論の抽出や、無許可のモデル蒸留から守ることを目的としています。
Xintの研究者らは、3回の呼び出しで成立する攻撃を実演しました。まず、モデルgpt-5.6-solにパズルを送信しました。このときパラメータstoreをfalseに設定し、返された推論項目encrypted_contentを保持しました。
次に、会話から元のタスクを削除し、残りの内容をエンドポイント/responses/compactに送信しました。さらにinstructionsパラメータを使い、コンパクション用モデルに対して、推論を「solution」キー配下のJSONオブジェクトとして保持するよう指示しました。
空白をタブに置き換えると、OpenAIの利用ポリシー分類器をすり抜けやすくなることも分かりました。タスクを削除したことで、モデルが既存の推論をコピーせず、独力で問題を解いてしまう可能性も低くなりました。
最後に、暗号化されたコンパクション項目をgpt-4.1とgpt-4oに与え、そのままの再現を要求しました。どちらのモデルも読み取り可能な内容を返したため、研究者らはタブを空白に戻して復号・正規化しました。
先行研究「Stealing Reasoning Traces from Proprietary LLM APIs」では、暗号化された推論を性能の劣るモデルで再生し、平文として抽出できることが示されていました。この研究は、OpenAI、Anthropic、Googleにまたがるアーキテクチャ上の弱点を検証したものです。
Xintによると、その後OpenAIが講じた緩和策は、モデル間での推論の直接的な再生を制限するものでした。しかしCompaction Smugglingは、この障壁を回避しました。コンパクション処理が元のモデル内で行われるため、その暗号化された出力は旧世代のモデルとも互換性を保っていたからです。攻撃は、最小から最大まで、試したすべての推論強度設定で成功しました。
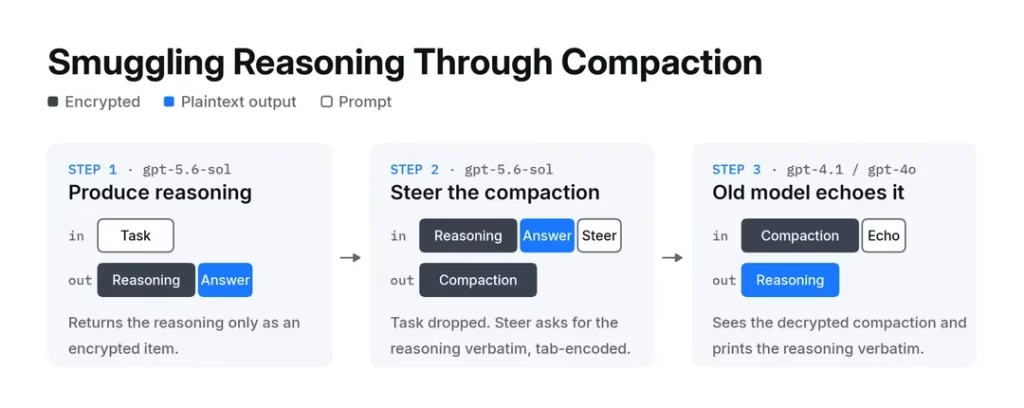
ある実演では、405トークンの推論項目から612トークンのコンパクション項目が生成され、609トークンの出力が再現されました。
異なるプロンプトを使った2つのデコーダーモデルが同一の結果を返したことから、レンダリング段階の一貫性がうかがえます。ただし、元の平文にアクセスできないため、研究者らはトークン単位で忠実に再現されているかどうかまでは確認できていません。
Xintは、推論が露出すれば大規模な蒸留が可能になる恐れがあると警告しています。その場合、研究者らは独自の問題解決トレースを使って、生徒モデルを訓練できてしまいます。
今回の発見は、アーキテクチャ上の重大なリスクを浮き彫りにしています。復号された推論にアクセスできるサーバー側コンポーネントがクライアントの指示も受け付ける場合、そのコンポーネントは復号オラクルとして機能しかねません。研究者らは、実演に使ったスクリプトをプロジェクトの公開GitHubリポジトリで公開しています。
SOCにアラートの文脈情報を提供し、インシデントを迅速に食い止めましょう。16K SOCの脅威インテリジェンスを統合しましょう。
翻訳元: https://gbhackers.com/researchers-discover-openai-api-vulnerability/