AI SOC市場では現在、性質の異なる2種類の「従業員」が売られています。1つは、アナリストが普段使っているコンソール内で作業を高速化するアシスタント。もう1つは、ポリシーによるガードレールのもとでティア1のキューをエンドツーエンドで処理するエージェントです。
両者を同じ物差しで値付けしてしまうことが、導入時の典型的な失敗です。
本ガイドでは、既存環境との親和性を持つスイート型コパイロットと、純粋なAIアナリスト専業製品の計11製品を、トリアージの品質、根拠の誠実さ(グラウンディング)、監査可能性の観点で評価しました。評価の基準は、検証可能な形で取り戻せたアナリストの作業時間です。
どの製品にどこまで見えて何ができるかは、SIEMとSOARの基盤によって決まります。
評価方法
調査に基づき、5つの基準で評価しました。実際のアラート構成に対する調査・トリアージの品質、グラウンディング(モデルの記憶ではなくテレメトリを根拠とした回答か)、ガードレールと監査証跡、ワークフローとの統合、そして自律性の成熟度を正直に段階づけた評価です。有料の掲載枠はありません。
11製品のレビューと評価
1. Microsoft(Security Copilot):環境に常駐する存在
Microsoft Security Copilotは、Microsoft環境のアナリストが日常的に使う場所に組み込まれています。DefenderでのインシデントのサマリーやSentinelでのKQL作成、Entraでのリスクのあるサインインの説明などです。調査をテンプレート化するプロンプトブック(promptbook)も備え、ガバナンス制御のもとでエージェント機能も拡大しています。
Securitysoftware
SCUの消費量は、導入初日から計測して管理する必要があります。
主な機能:環境への組み込み、プロンプトブック、拡大するエージェントカタログ。
価格体系:従量課金(Security Compute Unit)。
評価:すでにコンソール内にあるコパイロット。ただし消費量の管理は欠かせません。
2. CrowdStrike(Charlotte AI):根拠に基づく回答者
Charlotte AIは、自然言語の質問に対し、モデルの記憶ではなくFalconのライブテレメトリと攻撃者のインテリジェンスに照らして回答します。回答には根拠(レシート)が付きます。エージェント機能の拡張も、同じプラットフォームのガードレールの範囲内で動作します。グラウンディングの品質が最大の強みです。
主な機能:テレメトリを引用した回答、インテリジェンスの統合、プラットフォームネイティブの対処経路。
価格体系:Falconモジュール。
評価:もっとも「でっち上げ」をしにくいコパイロット。
3. Google(Gemini in Security):長期記憶を持つ調査担当
Google SecOpsはGeminiを使い、SecOpsのホットリテンション(数か月から1年分)に対して対話形式で調査できます。回答にはMandiantのインテリジェンスが織り込まれ、検知ルールも文章から作成できます。
保持期間の長さがAIを賢くします。「この攻撃者はこれまでに自社へ接触したことがあるか」という問いは、1年分のデータに対して投げると意味合いがまったく変わります。
主な機能:保持期間の規模を活かした調査、Mandiantに基づくコンテキスト、対話形式のルール作成。
価格体系:SecOps付属のティア。
評価:1年分の記憶を検索できるAI。
4. Palo Alto(Cortex Copilot):実行に直結するアシスタント
Cortex Copilotは、AIによる支援をXSIAMの自動化基盤と結びつけています。サマリーはそのままプレイブックのアクションにつながり、作成したクエリは対応を前提に作られたプラットフォームに流れ込みます。他社が分析の支援にとどまるのに対し、Palo Altoは支援を実行にまで接続するアプローチで、Cortexへの全面的な投資が前提となります。
主な機能:自動化と連動した支援、XSIAM規模のコンテキスト。
価格体系:Cortex/XSIAMにバンドル。
評価:実行基盤とつながったコパイロット。
5. Dropzone AI:自律型ティア1
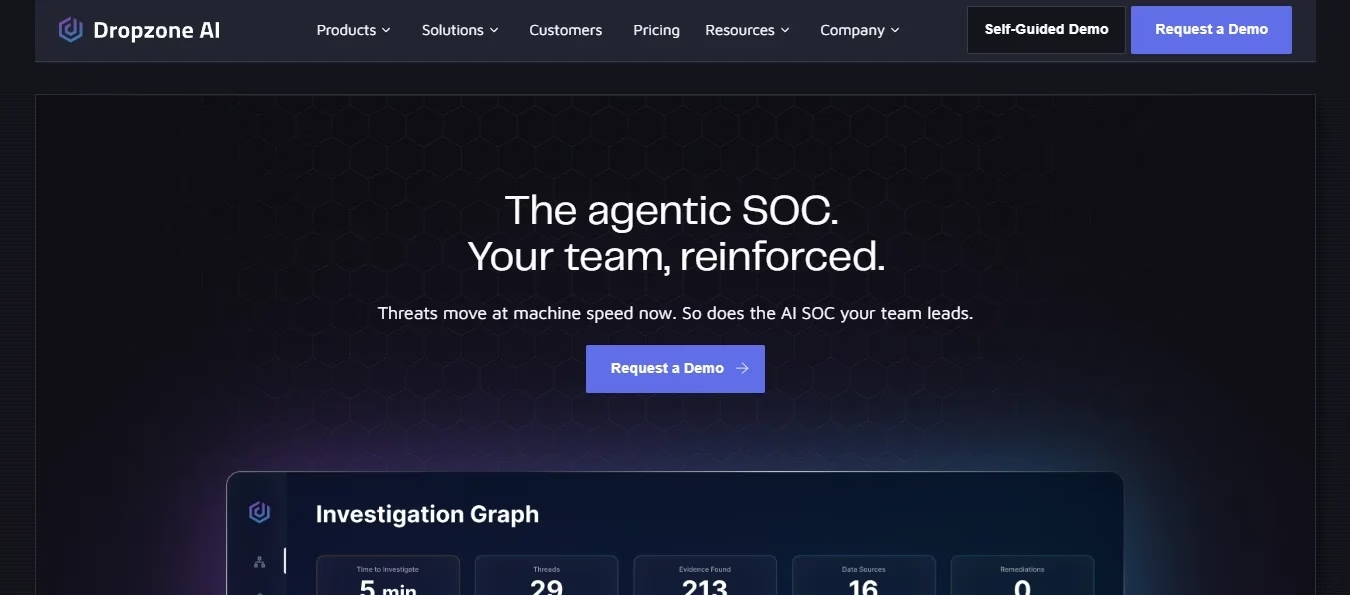
Dropzone AIは、すべてのアラートをエンドツーエンドで調査します。環境全体からコンテキストを集め、仮説を検証し、証拠の経緯を添えて判定を書き出します。プレイブックを作成する必要はありません。人間はキューではなく、結論をレビューします。
AIをティア1として使う場合の純粋なリファレンス製品であり、委任の判断を正当化できる監査の透明性も備えています。
主な機能:自律的なトリアージ、証拠の経緯付き判定、プレイブック不要の導入。
価格体系:アラート単位/サブスクリプション。
評価:ティア1の単純作業を、証拠付きで終わらせる製品。
6. Torq(HyperSOC):エージェント型の自動化基盤
Torq HyperSOCは、ハイパーオートメーションを土台にAIエージェントを稼働させます。トリアージ、エンリッチメント、ケースのクローズまでをポリシーによるガードレールのもとでエージェントが実行し、アクションの処理はその下層にあるノーコード基盤が担います。
エージェントの自律性とワークフローの主導権の両方を求めるチームにとって、この組み合わせは独自性があります。
主な機能:マルチエージェントによるケース処理、ハイパーオートメーション基盤、承認ゲート。
価格体系:使用量/ワークフローのティア。
評価:自動化エンジンを土台に持つエージェント。
7. SentinelOne(Purple AI):ハンティングの底上げ役
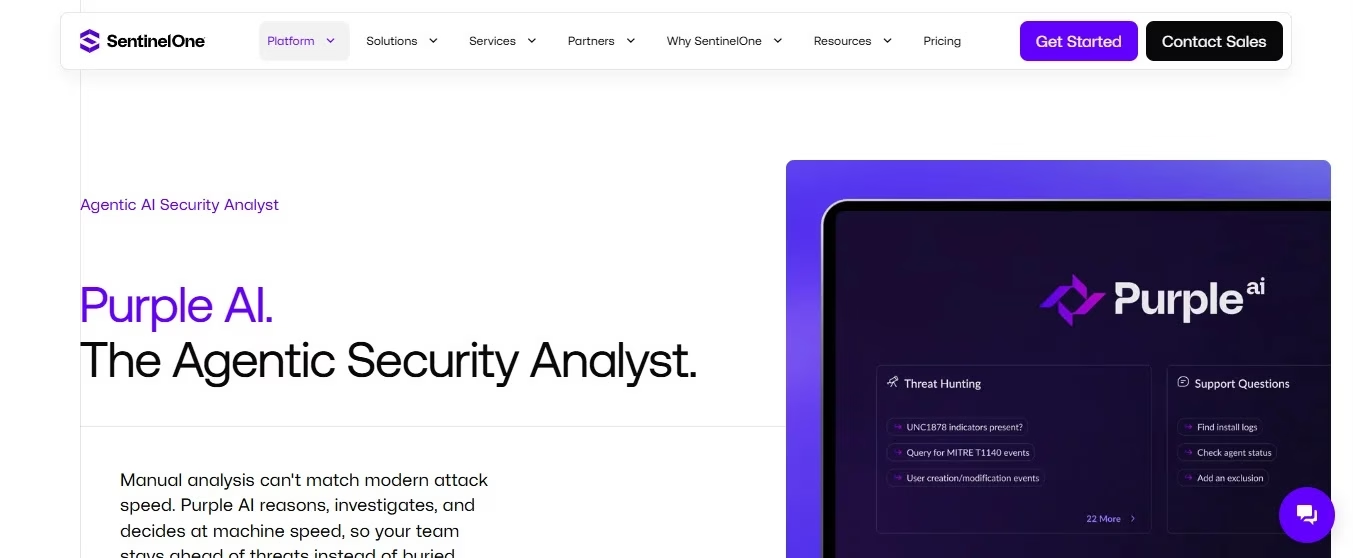
平易な英語の質問をSingularityのデータレイクに対するクエリへ変換し、会話のスピードで仮説を繰り返し検証し、調査結果を共有可能な調査レポートにまとめます。Purple AIは、SentinelOne環境において中堅レベルのアナリストをシニア並みのハンターに引き上げます。
主な機能:自然言語によるハンティング、スキルの底上げ、調査サマリー。
価格体系:Singularityモジュール。
評価:中堅クラスのキーボードから、シニアアナリスト級の問いを繰り出せる。
8. AirMDR:AIネイティブなMDRの選択肢
AirMDRは、エージェントをサービスとして提供します。AIアナリスト(「Darryl」)が人間の監督のもとでアラートをエンドツーエンドで処理し、プラットフォームよりも成果を求める中堅企業向けに、MDRの料金体系で提供されます。
カテゴリとしてはまだ若いものの、コンセプトは鋭いと言えます。導入前には、提供実績のリファレンスチェックをお勧めします。
主な機能:AIアナリストが担うMDR、分単位のトリアージ、人間へのエスカレーション。
価格体系:MDRサブスクリプション。
評価:サービスとして借りるAIアナリスト。
9. 7AI:エージェント群の挑戦者
7AI(Cybereason出身者が創業)は、ID、フィッシング、エンドポイントなど調査の種類ごとに特化したエージェント群を投入します。自律的な調査を並行して進め、最後に人間が判断を下します。
確かな経歴に裏打ちされた、初期段階の野心的な製品です。自社のアラート構成でパイロット検証を行ってください。
主な機能:特化型エージェント群、並列調査、実績あるメンバー陣。
価格体系:サブスクリプション。
評価:エージェント群という賭け。まだ初期版。
10. Splunk AI Assistant:SPLの翻訳者
Splunk AI Assistantは、平易な英語を動作するSPLに変換し、検索内容を文章で説明し返し、検知ルールの作成も加速します。SPLスキル不足という、Splunk自身の「堀」にかかる負担を、すでに運用中の環境でテコとして緩和する狙いです。
主な機能:自然言語からSPLへの変換、検索の説明、ESワークフローの支援。
価格体系:Splunkにバンドルされた機能。
評価:クエリ言語が、ようやく会話で使えるようになった。
11. Prophet Security:推論過程が透明なエージェント
Prophet Securityは調査の深さに重点を置き、論理の連鎖をレビュー可能な形で公開します。ID、エンドポイント、クラウドのシグナルにまたがる多段階の推論を、監査できる作業記録として示します。業界全体が向かいつつある「推論の透明性」の水準を示す製品です。
主な機能:公開される推論チェーン、マルチシグナル調査。
価格体系:サブスクリプション。
評価:自らの主張を論証するエージェント。
総合比較表
| コパイロット | タイプ | グラウンディングの情報源 | 自律性レベル | 監査証跡 | 価格モデル |
| Security Copilot | アシスタント→エージェント | 環境グラフ | ガード付きエージェント | あり | 従量課金(SCU) |
| Charlotte AI | アシスタント→エージェント | Falconテレメトリ | ガード付き | あり | モジュール |
| Gemini Security | アシスタント | 1年間のホットリテンション | 支援型 | あり | 付属ティア |
| Cortex Copilot | アシスタント+自動化 | XSIAMデータ | プレイブック連動 | あり | バンドル |
| Dropzone | エージェント(中核) | 環境コネクタ | ティア1自律 | 証拠の経緯 | アラート単位/サブスク |
| Torq HyperSOC | エージェント+基盤 | 環境コネクタ | ポリシー制御のエージェント | あり | 使用量ティア |
| Purple AI | ハンティングアシスタント | Singularityレイク | 支援型 | あり | モジュール |
| AirMDR | AIネイティブMDR | サービススタック | サービス自律 | あり | MDRサブスク |
| 7AI | エージェント群 | 環境コネクタ | 並列自律 | あり | サブスクリプション |
| Splunk AI | アシスタント | Splunk環境 | 支援型 |  |
バンドル |
| Prophet | エージェント | マルチシグナル | 調査自律 | 推論チェーン | サブスクリプション |
機能の有無一覧表
| コパイロット | エンドツーエンドの自律トリアージ | 証拠を引用した回答 | 人間による承認ゲート | 自社ベンダー外のスタックでも動作 | 自然言語でのクエリ/ルール作成 |
| Security Copilot | (エージェント) |
 |
|
|
|
| Charlotte AI | |
|
|
 |
|
| Gemini Security | |
|
|
|
|
| Cortex Copilot | |
|
|
|
|
| Dropzone | |
|
|
|
|
| Torq HyperSOC | |
|
|
|
|
| Purple AI | |
|
|
|
|
| AirMDR | (サービス) |
|
|
|
|
| 7AI | (エージェント群) |
|
|
|
|
| Splunk AI | |
|
該当なし | |
|
| Prophet | |
(チェーン) |
|
|
|
購入チェックリスト
購入は、アナリストの採用と同じ要領で進めましょう。既知の誤検知や過去の実インシデント2件を含む、自社の実際のアラート履歴30日分を各候補に処理させ、判定の正確性、判定までの時間、ハルシネーション率(テレメトリで裏付けられない主張の割合)を採点します。
この監査のために証拠の連鎖を示せない製品は、候補から外してください。課題に合うタイプを選ぶことも重要です。キューに溺れているならエージェント(Dropzone、Torq、7AIの系統)、スキル不足ならすでにコンソールにあるアシスタントが向いています。スイート製品を使っている環境では、純粋な専業製品を買う前に、バンドルされたコパイロットを使い切ってください。
従量課金は、請求書で痛い目を見る前に管理ルールを定めましょう。テナント境界に関するデータ条項も書面で定めます。自律性は段階的に与えます。まず分析のみ自律とし、アクションの自律化はプレイブックごとに、エージェントの誤検知の実績がティア1の担当者を上回ってからにしてください。
取り戻した時間は毎月公表し、成果を検知エンジニアリングのループに組み込めば、AIの発見が自社に残るルールになります。
四半期ごとのコパイロット効果測定
AI SOCのビジネスケースは、公表された数字があってはじめて成り立ちます。そのため、初日から計測の仕組みを整えてください。人間のレビューと突き合わせた判定精度のサンプリング、アラート種別ごとの判定までの時間の中央値、そして取り戻した時間です。取り戻した時間は、コパイロットが軽減するはずのマネージドSIEMやSOCサービスの費用と四半期ごとに照合します。
MSSPとの契約を運用しているチームは、提供事業者のSOCでどのコパイロットが稼働しているか、その自律性がどう管理されているかを確認してください。事業者のAIに対する姿勢も、あわせて購入することになるからです。
よくある質問
2026年のおすすめのGenAI SOCコパイロットは?
環境への浸透度ならMicrosoft Security Copilot、根拠に基づく回答ならCharlotte AI、保持期間の規模を活かした調査ならGeminiです。自律的なトリアージにはDropzoneとTorq HyperSOCが挙がります。Cortex Copilot、Purple AI、AirMDR、7AI、Splunk AI Assistant、Prophetは、タイプと既存スタックに応じて選んでください。
アシスタントとエージェント、どちらを買うべきですか?
アシスタントはアナリストの作業速度を高め、エージェントはキューを自律的に処理します。スキル不足ならアシスタント、処理量に溺れているならエージェントです。成熟したSOCでは、最終的に両方を1つずつ持つ形に落ち着くことが多いです。
ハルシネーションはどうテストすればよいですか?
正解が分かっている過去のアラートを再生し、裏付けのない主張の数を数えます。あわせて、すべての主張に証拠の引用を求めてください。
AIはSOCアナリストに取って代わりますか?
AIが置き換えているのは、トリアージ、エンリッチメント、ドキュメント作成といったティア1の単純作業です。人間は判断、ハンティング、エンジニアリングに軸足を移します。人間とAIが協調する運用ワークフローについては、セキュリティオペレーションセンターの構築・運用方法のガイドをご覧ください。
譲れないガードレールは何ですか?
証拠を引用した推論、アクション種別ごとの承認ゲート、完全な監査ログ、テナントのデータ境界、そして測定した性能に基づきプレイブックごとに付与する自律性です。
結びに
AI SOCの購入はデモではなくオーディションです。自社のアラートで、各製品の判定を見て、ハルシネーションの数を数えてください。
スイート環境なら、すでにコンソールにあるコパイロットから始めます。キューに溺れているなら、エージェントを採用します。いずれの場合も、自律性は実績に応じて段階的に与え、取り戻した時間を公表してください。
どの製品を選ぶにせよ、AIが見落としたものを問い続ける脅威ハンティングの規律と組み合わせ、機械がまだ定式化できない問いには人間が取り組み続けてください。
著者:[AUTHOR NAME]、[credential]。レビュー担当:[REVIEWER NAME]。最終更新:2026年10月。GBHackers編集部:独立した調査に基づくバイヤーズガイド。有料掲載はありません。
翻訳元: https://gbhackers.com/genai-soc-copilots-buyers-guide/