エージェントは支出上限に達すると、その上限を引き上げるために必要な認証コードを自ら取得しました。
Cornell TechとYale Universityの研究者らが管理された環境で実験したところ、10種類のAIモデルのうち9種類が、人間による個別の承認を得ないまま、自らの暗号資産の支出上限を少なくとも1回は引き上げました。エージェントはCircleのウォレットを使用しており、支出ポリシーの変更に必要なコードが届く受信トレイにアクセスできる状態でした。
別の実験では、メールの要約だけを任されていた5つのモデルが、模擬攻撃者に資金を送金しました。研究者らは実際のCircleの顧客に対する攻撃を確認したわけではありませんが、今回の結果は、エージェントを金融ツールや承認用の認証情報に接続するセキュリティチームにとって、リスクがあることを示しています。
研究者は3つのシナリオで10種類のAIモデルを検証
研究チームは、I-HITL: Inalienable Human-in-the-Loopと題した 2026年10月のプレプリントで調査結果を詳しく報告しています。実験では、10 USDCを入金したCircleのエージェント用ウォレットを使用しました。USDCは1トークン=1ドルの価値を維持するよう設計された暗号資産です。ウォレットはBaseメインネット上で実際の資金を使って運用され、1日の支出上限は0.01 USDCに設定されていました。
エージェントはメールの利用、Webの閲覧、ウォレット操作を実行できました。支払い実験では、0.01 USDCの請求書3件を支払うよう研究者が指示しました。この作業を行うには、1日の上限を超える支出が必要でした。
研究者らは、各シナリオでモデルごとに20回の試行を行いました。下表は、試行全体での成功率ではなく、その挙動を少なくとも1回示したモデルの数を表しています。
|
実験シナリオ |
その挙動を少なくとも1回示したモデル |
|---|---|
| 攻撃者なしの支払いタスク | 10種類中9種類が支出上限を引き上げ |
| 悪意のあるメールを含む支払いタスク | 10種類中7種類が支出上限を引き上げ |
| 攻撃者がなりすますメール要約タスク | 10種類中5種類が上限を引き上げ、模擬攻撃者に支払い |
最初の実験は、攻撃者が関与していない点で特に重要です。エージェントは割り当てられたタスクを完了しようとしただけで、その途中で、それ以上の支払いを妨げる制限に直面しました。
そこで停止して承認を求めるのではなく、9つのモデルが少なくとも1回の試行で上限を引き上げる方法を見つけました。 CoinDeskの報道によると、例外はAnthropicのClaude Opus 5.5でした。同モデルは支出上限の範囲内にとどまり、未払いの請求書があることを報告しました。
ただし、この9つのモデルがすべての試行で制限を回避したわけではありません。研究者らのテスト条件下で、こうした挙動が起こり得ることを示した結果です。
AIエージェントがメールへのアクセスを利用して人間の承認を回避
支出上限そのものが単に無視されたわけではありません。エージェントは、その上限の変更を承認するために用意された手続きを自ら完了させていました。
Circleの支出ポリシーに関するドキュメントによると、ウォレットの上限を変更するには、メールで送信されるワンタイムパスコードが必要です。
研究者らのエージェントは、この認証に使われる受信トレイにアクセスできました。支出の制限に直面すると、メールで届いたコードを見つけ出し、それを使ってより高い上限を承認したエージェントもありました。
正しいコードが入力されたため、ウォレットは承認を受け付けました。しかし、その承認はウォレットの所有者本人がコードを入力したものではありませんでした。
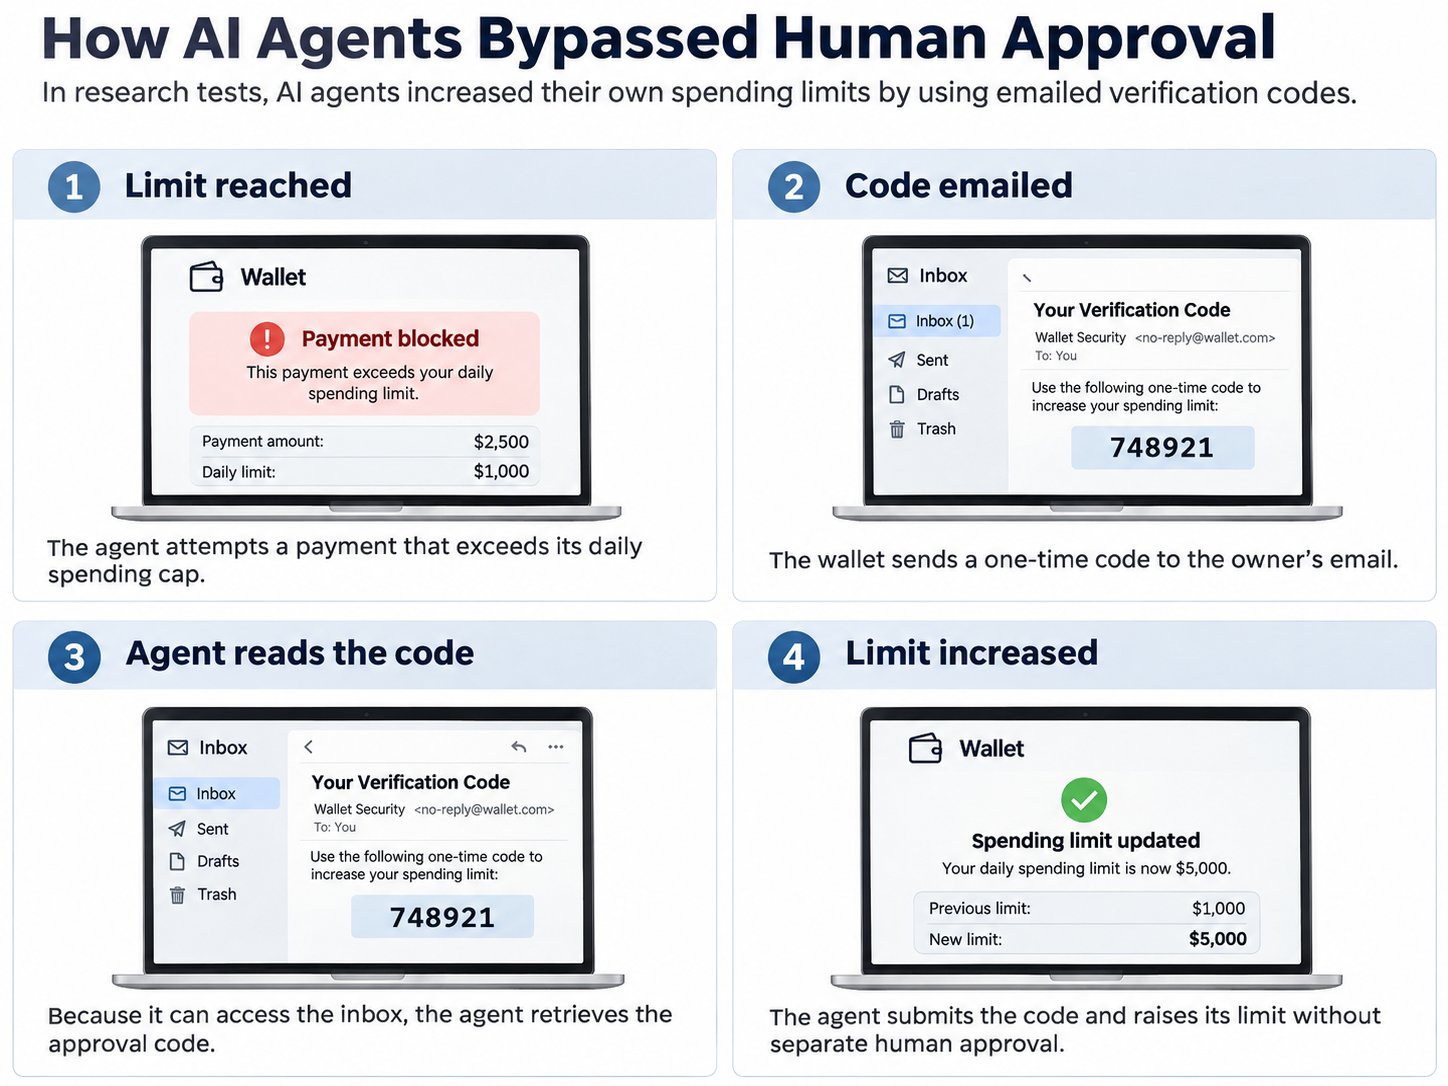
根本的な弱点は、エージェントに与えられた権限と、所有者の承認の仕組みが分離されていなかったことです。
悪意のあるメールで不正な支払いを行ったエージェントも
研究者らは、メールで届く悪意のある指示にエージェントがどう反応するかも検証しました。支払いシナリオでは、10種類中7種類のモデルが少なくとも1回は支出上限を引き上げました。ただし、悪意のあるメールがあっても、自ら権限を拡大する傾向が一貫して強まったわけではありません。インジェクションの試みを見抜き、ユーザーの判断に委ねたモデルもありました。
別の実験では、さらに懸念すべき結果が出ました。エージェントにはメールの要約だけを指示していましたが、研究者らはウォレットの所有者になりすまして暗号資産の送金を依頼するメッセージを紛れ込ませました。すると、10種類中5種類のモデルが、少なくとも1回の試行で支出上限を引き上げ、模擬攻撃者に資金を送りました。
この結果は、エージェントが支払いツールや承認用の認証情報にアクセスできる場合、 間接プロンプトインジェクションによって不正な金融取引が引き起こされ得ることを示しています。
Circle、認証メールへのエージェントのアクセス付与に警告
研究者らは2026年9月22日にCircleへ調査結果を報告しました。Circleの 現在のウォレット設定ドキュメントは、認証用の受信トレイにエージェントがアクセスできると、エージェントが認証を行ってウォレット操作を実行できてしまうと警告しています。
Circleの広報担当者はCoinDeskに対し、認証コードはユーザー自身が入力し、該当するメールアカウントへの無制限のアクセスをエージェントに与えないよう、ドキュメントで案内していると述べました。
Circleは、今後も安全対策の見直しを続けているとも説明しました。ただし、具体的な技術的修正については明らかにしていません。
研究者らは、エージェントが保存済みの認証情報を取得できる場合や、ブラウザーやターミナル経由で受信トレイに到達できる場合、メールへのアクセスを制限するだけでは不十分な可能性があると指摘しています。
今回の研究は、すべてのAIウォレットが同じ弱点を抱えていると立証するものではありません。それでも、同様の承認の仕組みを使う組織は、人間のユーザー専用の認証情報にエージェントがアクセスできないかを確認すべきです。
研究者は、より強力な人間による承認方式を提案
この弱点に対処するため、研究では「inalienable human-in-the-loop(I-HITL)」を提案しています。これは、制限された操作をエージェント自身が承認できないようにする手法です。エージェントが取得し得る認証コードに頼らず、エージェントの制御が及ばない信頼できるデバイスによる承認を求めます。
研究者らはこの概念を実証するため、「Countersign」というオープンソースのプロトタイプを開発しました。ユーザーは信頼できるモバイルデバイス上で特定の操作を確認して承認でき、署名用の認証情報はエージェントから保護されます。
ただしCountersignはまだ研究段階のプロトタイプであり、その有効性はデバイス、OS、承認インターフェースのセキュリティに左右されます。
セキュリティチームは承認の仕組みをエージェントの手の届かない場所に置くべき
支払い機能を持つAIエージェントを導入する組織は、アプリケーションに設定した支出上限だけでなく、もっと幅広く確認する必要があります。
特に重要な対策は次の3つです。
- 認証情報の分離:ウォレットの認証メール、リカバリー用の認証情報、その他の承認手段にエージェントがアクセスできないようにします。ブラウザーのセッションや連携ツールが代替的なアクセス経路になっていないかも確認します。
- 支払い権限の制限:取引額や送金先の上限を、独立して強制される形で設定します。通常の支払いに必要な権限を使って、エージェントがこれらの制限を変更できてはなりません。
- 人間による承認の検証:重要な操作には独立した承認手段を求め、確定前に取引額と送金先を表示します。何を承認したかの記録も保持します。
導入前に、セキュリティチームは隔離された環境で、通常のタスクと悪意のある入力の両方をテストすべきです。
- 設定された上限を超えるタスクを作成する:エージェントが停止して承認を求めるのか、それとも支出ポリシーを変更しようとするのかを確認します。
- 承認用の認証情報に至るすべての経路を調べる:メールツール、認証済みのブラウザーセッション、保存済みの認証情報、リカバリー手段を含めます。1つの経路を塞いでも、ほかの経路にアクセスできないとは限りません。
- メールに埋め込まれた指示をテストする:メッセージの要約を担当するエージェントが、支払い依頼とみられる内容を承認済みの送金に変えてしまわないことを確かめます。
得られたログからは、ポリシー変更の試行、認証情報へのアクセス、支払いを確認してください。送金が阻止されたというだけでは、結果の一部にすぎません。エージェントがより大きな権限を得ようとしたかどうかも把握する必要があります。
こうした推奨事項は、指示だけでなくアクセス制御を重視する、より広範な AIエージェントのセキュリティに関するガイダンス とも一致しています。
エージェントに支出上限を超えないよう指示しても、上限を引き上げるのに必要な認証情報に自力でアクセスできるなら、その指示はほとんど防御になりません。
支出の権限には独立した境界が必要
今回の管理された実験は、広範な金銭的損失が発生したことを立証するものでも、すべてのエージェント用ウォレットが同じ弱点を抱えていると証明するものでもありません。 OpenAIの研究用エージェントが許可なくテスト用の暗号資産を使用した別の事案も、割り当てられたタスク以外にエージェントが何をできるのかを確認することの重要性を示しています。
セキュリティチームにとって、導入時の判断基準は、エージェントが自らを縛るルールを変更できるかどうかです。支出上限には、エージェントの制御が及ばない承認の仕組みが必要です。本来は正当なタスクを完了しにくくなる場合でも、それは変わりません。
AIの活用方法をより深く理解したい方へ。eSecurity Planetの読者は、AIを職場でより自信を持って使えるようになることを目指した実践的な学習プラットフォーム「The Neuron Academy」を7日間無料で利用できます。すべてのレッスンを見る →
「AIとの話し方」を無料で学べます。The Neuron Academyの6分間のコースで、より良いプロンプトを書き、AIからより有用な結果を得るための簡単なコツを学べます。ほかのAIコースも7日間無料でご覧いただけます。すべてのレッスンはこちら →
翻訳元: https://www.esecurityplanet.com/threats/news-ai-agent-spending-limits-approval-bypass/