Fingerprintは、顧客自身の不正の実績データで直接学習する予測型の不正シグナル「Fraud Score」の提供を開始しました。Fingerprintのデバイスインテリジェンスと機械学習モデルを基盤としています。Fraud Scoreは組織ごとの不正の種類を学習するため、自前でモデルを構築・保守しなくても、より正確に不正を特定できます。
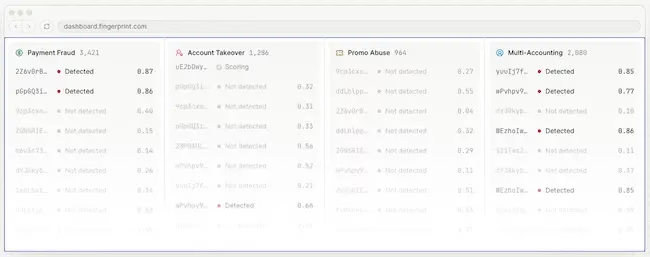
基本的なリスクスコアリングでは多様な不正に対応できない
Javelin Strategy & ResearchのリードアナリストであるSuzanne Sando氏(Suzanne Sando)は次のように述べています。「今日の企業は、AIを活用した手口によって拡大した、より幅広い不正の脅威に直面しています。脅威は組織や攻撃の種類によって異なりますが、一つだけ明らかなことがあります。画一的で静的なリスクスコアリングでは、もはや十分ではないということです」
オンライン不正が巧妙化するなか、セキュリティ部門やリスク管理部門は、かつてないほど多くのシグナルを、正確で実行可能な判断へとつなげることに苦慮しています。こうした複雑さがあるにもかかわらず、ほとんどのツールは不正を単一の問題として扱っています。しかし、アカウント乗っ取り(ATO)、決済不正、プロモーションの悪用、偽アカウントの作成は、それぞれ異なる挙動を示すため、検知戦略も別々に必要です。汎用的なリスクスコアではこうした違いを捉えきれず、エンジニアリングチームや不正対策チームは、手作業の分析、複雑なルールの構築、モデルの継続的な保守に膨大な時間を費やすことになります。
Fingerprintのプロダクト担当VPであるCatherine Woneis氏(Catherine Woneis)は、次のように話しています。「不正対策チームは、シグナルを判断につなげるという課題を抱えています。Fraud Scoreは、カスタム機械学習モデルの構築や保守の複雑さを伴わずに、あらゆる組織がカスタム機械学習の力を使えるようにするために開発しました。Fraud Scoreは、各顧客の実際の不正の実績と当社のデバイスインテリジェンスで特化型モデルを学習します。これにより、チームは特定の脅威をはるかに高い精度で阻止できます」
生のデバイスシグナルを、根拠ある事業判断へ
Fraud Scoreは、顧客ごとに調整されたモデリングをすぐに使える形で提供し、リスク管理チームの負担と不確実性を解消します。直接比較による評価では、Fraud Scoreはある顧客の既存の自社製モデルより約50%多くの不正を検知しました。正規ユーザーのブロックは増えていません。
Fraud Scoreは、Fingerprintの幅広いデバイスインテリジェンスシグナルと、各組織が提供する不正の実績データを組み合わせます。これにより、組織固有のトラフィックに合わせた特化型モデルを構築・保守します。不正対策チームは、Fraud Scoreの特化型予測をそのまま活用できます。FingerprintのAPIレスポンスを通じて、既存の意思決定システムに組み込むことも可能です。顧客が新たな実績データを提供するたびに、FingerprintはFraud Scoreのモデルを継続的に再学習します。
汎用的なネットワークルールに依存する手法や、予測レイヤーの保守に社内のデータサイエンスチームを必要とする手法とは異なり、Fraud Scoreには次の特長があります。
- 不正の種類ごとに特化:決済不正、ATO、複数アカウントの作成、偽アカウントの作成、プロモーションの悪用、プラットフォームの悪用、コンテンツの悪用など、脅威の種類ごとに個別のモデルと予測を最適化
- 顧客データで学習:組織の不正の実績から直接学習するため、予測に各組織固有のユーザーやトラフィックパターンを反映
- デバイスインテリジェンスを基盤に構築:Fingerprintのデバイスインテリジェンスシグナルを取り込み、手動ルールでは見逃す相関関係や異常を検出
FlinkのプリンシパルソフトウェアエンジニアであるDavid Fennessey氏(David Fennessey)は、次のように述べています。「訪問者IDをブロックするだけでは、より巧妙な不正行為者を止めるには不十分でした。Fraud Scoreなら、Fingerprintと協力して当社独自の不正分析に基づくモデルを作成し、注文が確定する前に今後の悪用を阻止できます」
翻訳元: https://www.helpnetsecurity.com/2026/11/11/fingerprint-fraud-score/