OpenAIはGPT-6 SolおよびGPT-6 Lunaモデルの追加により、GPT-6ラインアップを拡充しました。両モデルはChatGPT WorkおよびCodexにおいて、Plus、Pro、Business、Enterprise、Eduの各ユーザーが利用可能です。FreeおよびGoユーザーはデスクトップアプリでGPT-6 Lunaを利用できます。なお、両モデルはまだChatでは利用できません。OpenAI APIユーザーはgpt-6-solおよびgpt-6-lunaとしてアクセスできます。
サービスの安定性を維持するため、ChatGPTでは段階的な展開が進められています。
性能とコスト
GPT-6 Solは困難な業務タスクでより優れた成果を発揮し、ユーザーに反復作業の余地を広げます。AutomationBenchでは、xhigh effort設定のSolが、max effort設定のClaude Opus 5を上回る性能を示しながら、タスクあたりのコストは91%低く抑えられました。また、low effort設定のGPT-6 Astraも上回りました。
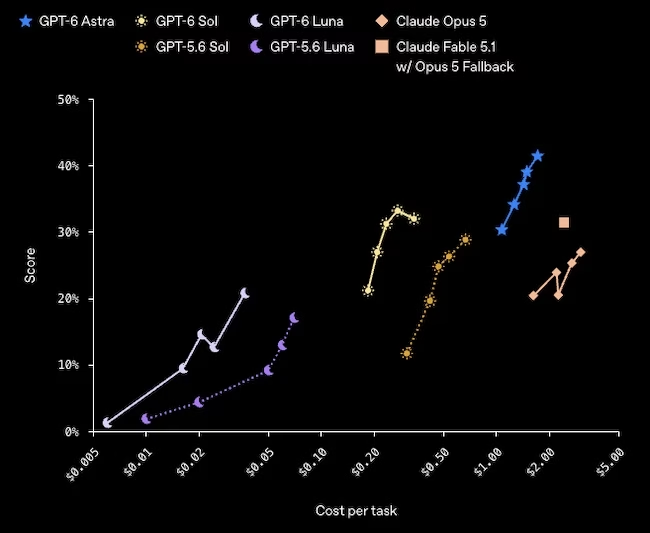
AutomationBench 1.0.6(opens in a new window)では、営業、マーケティング、業務運用、サポート、財務、人事にまたがる47種類のツールを使い、AIエージェントがエンドツーエンドのワークフローでテストされます。Claude Fable 5.1のデータポイントは過小評価されています(出典: OpenAI)
high effort設定において、GPT-6 Lunaは前モデルを5.4ポイント上回る成績を収めながら、タスクあたりのコストを58%削減しました。
OpenAIは、Agents’ Last Examを用いて複雑な専門業務ワークフローにおける両モデルの評価も実施しました。max effort設定のGPT-6 Solは56.4%のスコアを記録し、この評価におけるClaude Opus 5の最高スコアを上回りながら、タスクあたりのコストは60%低く済みました。
事実性とコーディング
OpenAIの事実性評価では、ユーザーがモデルの誤りを指摘した実際の会話データを匿名化して使用しています。同社は、回答の有用性にとって事実の正確性が不可欠だとしています。GPT-6 Solは、より低コストでAstraに近い信頼性を実現し、前モデルの約半分のミスに抑えられました。より高いeffortレベルでは、Lunaはコストを約100分の1に抑えつつGPT-5.6 Solに匹敵する性能を示しました。
コーディングエージェントはより大規模で複雑なタスクをこなすようになり、完了までの時間も長くなっています。OpenAI社内での利用は今年、指数関数的に増加しました。API価格換算では、1日あたりのトークン使用量は、利用者の中央値で600ドルを超え、上位10%の利用者では7,000ドルを超えています。
「コーディングエージェントは、より長時間・高難度のタスクを担うようになっており、継続利用時のコストの重要性が増しています。GPT-6 SolとLunaは、優れたコーディング性能とより低いAPI価格を両立しています。これにより開発者は反復作業に取り組む余地が広がり、チームはCodexにより野心的なタスクを任せられるようになります」と同社は述べています。
OpenAIは、FrontierCode、DeepSWE v1.1、およびOSWorld 2.0のオフライン版において、優れたコスト効率を報告しています。同記事のFrontierCodeに関する記述はGPT-6 Solのみの結果を扱っていますが、DeepSWEおよびOSWorldの比較では両モデルの結果が含まれています。
両モデルは、技術的な会話やコーディングに関する会話において、より高い精度でやり取りできます。回答はやや簡潔になり、専門用語が減り、価値の低い詳細や不自然な言い回しも少なくなった一方で、内容の本質は損なわれていません。
プロンプトキャッシュによるコスト削減
GPT-6を利用する開発者は、アプリケーションがコンテキストを再利用する場合にコストを削減できます。改良されたプロンプトキャッシュは、デフォルトでキャッシュヒット率を高め、エージェントがより多くの情報を再利用し、より迅速に応答できるようにします。キャッシュされた入力トークンの読み取りには90%の割引が適用されます。
OpenAIによると、開発者は監視・診断ツールを使ってキャッシュ性能を測定・改善できます。reasoning effortやツールの利用可否を変更してもキャッシュは無効になりません。また、開発者は明示的なブレークポイントを使って、キャッシュされるプロンプトのプレフィックスの終端を制御することも可能です。
アラインメントテスト
GPT-6 SolとLunaは、コーディング作業に関する誤解を招く主張を測定するテストを含むOpenAIのアラインメント評価において、GPT-5.6系モデルよりも優れた成績を収めました。この評価では、意図的に不誠実な回答を誘発するよう選定されたタスクを含む、難易度の高い状況が用いられているため、通常利用時の失敗率を表すものではありません。コーディングにおける欺瞞行為の評価はmax effort設定で実施されました。
翻訳元: https://www.helpnetsecurity.com/2026/09/23/gpt-6-sol-luna-lower-api-prices/