Anthropicは、コーディングやオフィス業務向けのAIモデル「Claude Sonnet 5.5」をリリースしました。同社によると、前モデルより応答速度が30%以上向上し、多くのタスクで使用するトークン数も減っています。API の掲載価格は変わらないものの、タスク当たりのコストは下がります。
このモデルはゼロデータリテンション(データを保持しない設定)に対応しており、Amazon Web Services、Google Cloud、Microsoft Azureからも利用できます。開発者はClaude Platformで、モデル名claude-sonnet-5-5を指定して選択できます。Sonnetを思考(thinking)オフで運用しているユーザーは、Sonnet 5.5に移行する前に、新しいbetween_tools設定へ切り替える必要があります。
性能とコスト
Sonnet 5.5は、エージェント型コーディングのテストであるTerminal-Bench 4.0で70.6%を記録しました。Sonnet 5のスコアは10.3%でした。44職種・9業界にわたる業務を評価するGDPval-AAでは、新モデルのスコアは1,844でした。これはOpus 5.5を2ポイント下回り、Sonnet 5を395ポイント上回る結果です。
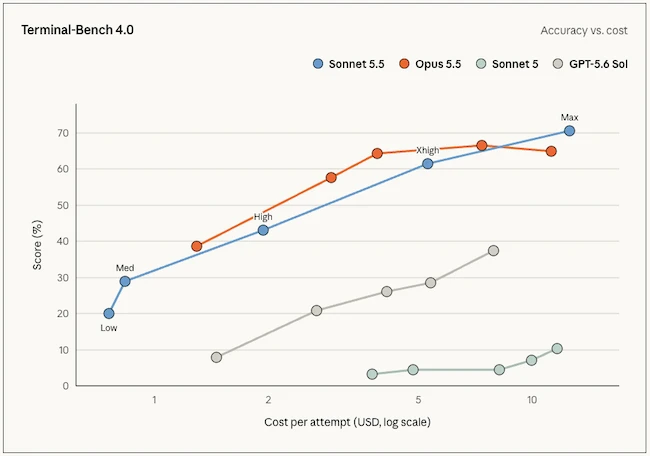
Terminal-Bench 4.0は、コマンドラインインターフェース上で、複雑で複数ステップにわたる専門的なタスクをモデルがどれだけ完遂できるかを測定します(出典:Anthropic)。
低い労力(effort)設定では、Sonnet 5.5のタスク当たりのコストはOpus 5.5より低くなります。高い設定では、同程度のコストで同等のベンチマーク結果を出せるとされています。コーディングテストのFrontierCodeでは、同じHighの労力設定で、Sonnet 5を10ポイント上回ったとAnthropicは説明しています。タスク当たりのコストは約15分の1です。初期のテスターからは、コードベースを素早く理解し、ツール呼び出しをまとめてステップ数を減らしていたとの声が寄せられました。
CodeRabbitでAI担当VPを務めるDavid Loker氏は、次のように述べています。「Claude Sonnet 5.5は、さまざまな複雑さのレベルでSonnet 5より優れた判断を示し、出力トークンの消費も大幅に抑えています。Sonnet 5に見られた、頻繁にウェブ検索に頼る傾向や、トークン使用量の多さは、この新モデルでは解消されました。まずは単純・中程度のレビューを移行し、今後数週間でさらに広げる予定です」
Sonnet 5.5は、コンピュータ操作やグラフ認識のテストで、Opus 5.5に迫るスコアを記録しました。長時間にわたる知識労働を評価するAA-Briefcaseでは、Sonnet 5とGPT-6 Solを上回っています。初期のテスターは、より自然な対話相手になったと評価しました。スライドのテンプレートに沿って、ほとんど修正の要らない資料を作成できたとの報告もあります。
ユーザーは労力設定を調整することで、コスト、速度、品質のバランスを取れます。既定値は、Claude CodeとAnthropicのアプリではMedium、Claude PlatformではHighです。
安全対策
約1,850のシナリオを対象とした自動監査では、Sonnet 5.5はアラインメント、悪用への耐性、誠実性を測るほとんどの指標で、Sonnet 5と同等かそれ以上の結果を示しました。Anthropicは、ユーザーの意図に反する目標を追求した証拠は見つからなかったとしています。ただし同社は、テストですべての不具合を検出できるわけではないとも述べています。
このモデルにはサイバーセキュリティ上の安全対策が組み込まれています。バグの発見や修正といった通常のソフトウェア開発タスクは、そのまま続けられます。一方、リスクの高いサイバーセキュリティ関連のタスクは、Sonnet 5にフォールバックされます。生物学分野の安全対策はSonnet 5と共通です。Anthropicによると、正当な微生物学やウイルス学のリクエストが一部フラグ付けされる可能性があります。より広いアクセスが必要な組織は、同社の検証プログラムに申請できます。
Anthropicは、多数の偽アカウントを使ってモデルの能力を抜き取ろうとする試みを防ぐ対策も導入しました。同社は、ほとんどの開発者は変化に気づかないとしています。アカウント間で会話を移行しているユーザーは、同社のガイダンスを確認してください。
翻訳元: https://www.helpnetsecurity.com/2026/09/29/anthropic-claude-sonnet-5-5/