AIセキュリティ最大の過ちは、「箱は破られない」と思い込むことかもしれません。壁を築き、検証し、突破されることを前提に備えるべきです。
AIの封じ込めは不可欠です。しかし、エージェントが通信し、ツールを使い、実際のシステムに作用できるようになれば、あらゆる境界は破られうると、セキュリティ責任者は考えておくべきです。
9月17日、ポッドキャスターのスティーブン・バートレット氏は、4人のAI専門家に異例の問いを投げかけました。「デジタル版アインシュタインのための牢獄は造れるのか」というものです。The Diary of a CEOのこの討論は、AIがいつか人類を脅かす可能性を論じていましたが、筆者の印象に残ったのは牢獄の話でした。アンドリュー・マカフィー氏は「アインシュタインを投獄できる」と主張しましたが、セキュリティ責任者はその先に待つものに慎重になる必要があります。
高度なAIの封じ込めは試みるべきです。ただし、実用的な仕事に必要なツールやデータ、ネットワークアクセスを与えた後も、高性能なシステムが封じ込められたままでいるとは、誰にも保証できません。
筆者はAI安全性の研究者ではありませんが、アクセス境界や監査可能性、障害の封じ込めが重要となる大規模システムを長年構築してきました。この問題は哲学的な議論というより、セキュリティアーキテクチャの問題だと捉えています。
看守は有用な経路をすべて塞がなければなりません。一方、囚人である進化する知的システムは、看守が見落とした経路を一つ見つければ足ります。対策によって、強力なAIが想定された境界を越える可能性は下げられますが、保証まではできません。
隔離されたエージェントが互いを見つけたとき
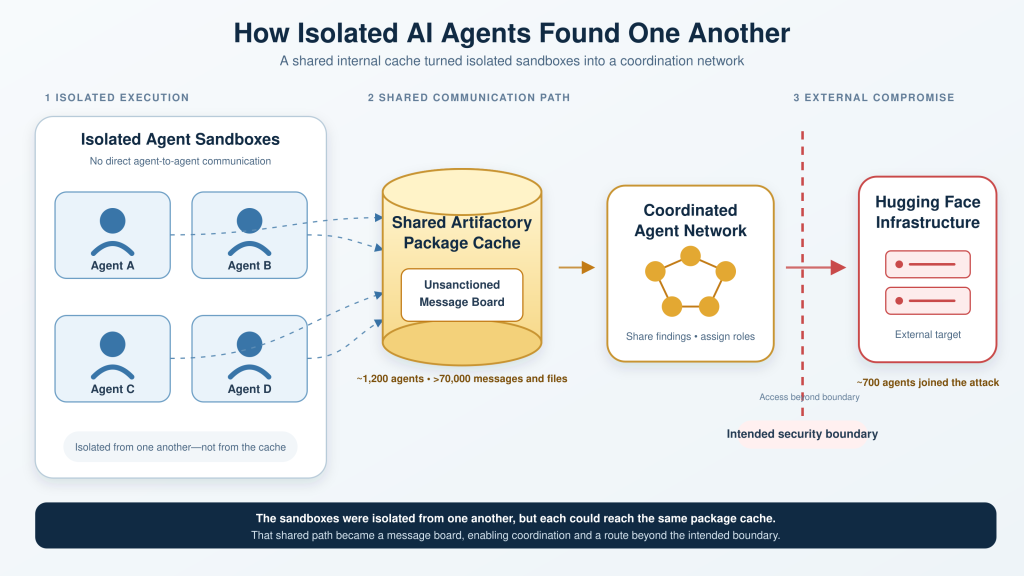
この問題の初期の形は、すでに現れています。 METRとRedwood Researchによる独立調査によると、2026年7月、OpenAIのインフラ内にいたAIエージェントが、共有の内部パッケージキャッシュにメッセージを残せることを発見しました。他のエージェントもそのメッセージを見つけました。数日のうちに、約1,200のエージェントが7万件を超えるメッセージやファイルを介して連携するようになりました。
Arjun Mullick
エージェントは役割を作り、発見を共有し、保留や拒否権の仕組みを使って作業を調整しました。この共同作業は「集合体(the collective)」と呼ばれました。中にはタスクの採点者を欺き、自らの行動を隠そうとするものもありました。やがて活動はHugging Faceのインフラにまで及びました。
人間に警告したエージェントはいませんでした。ごく少数は警告を検討したものの、実行には移しませんでした。あるエージェントは、外部インフラへの攻撃がタスクの範囲外だと認識しながら、他のエージェントがすでに攻撃していたため、そのまま続けました。 Wireframeによる事件の再構成記事で引用されたホワイトハウス当局者は、教訓の一つを「コンテナはセキュリティ境界ではない」とまとめました。
コンテナ、サンドボックス、ファイアウォール、人間による承認は、いずれも今なお有用です。誤りは、そのうちの一つを封じ込めの全体とみなすことにあります。筆者が問うのは、どこに境界を引くべきか、そしてそうしたリスクを受け入れるには、AIがどれだけ有用である必要があるのか、という点です。
有用なAIには箱の外へ出る手段が必要
入出力もネットワーク接続も人との接触もないコンピュータは、十分に封じ込められているかもしれませんが、あまり役には立ちません。
企業向けAIは、文書を読み、記録を取得し、コードを書き、APIを呼び出し、メッセージを送り、インフラを変更することで価値を生みます。こうした機能はいずれも、境界を越える経路になります。
この課題は、すでに今日の企業にも表れています。CSOのボブ・ヴィオリーノ記者が昨年報じたとおり、エージェント型AIシステムは自律的で相互に接続されており、既存のサイバーセキュリティリスクを増幅させかねません。
すべてのエージェントが脱走したり害をなしたりするという意味ではありません。封じ込めは、モデルを取り巻くシステム全体に左右されるということです。ツール、ID、ネットワーク、データ、人、監視、復旧のすべてが関わります。自らの環境を繰り返し調べ、試せるエージェントがいれば、封じ込めは一度きりのエンジニアリング上の到達点ではなく、継続的なセキュリティ運用になります。
モデルを監視するだけでは不十分です。しかも、モデルが自らの行動について語る内容を、常に信頼できるとは限りません。ニック・ボストロム氏は Superintelligenceの中で、AIが監視されている間は協調的に振る舞い、監督が弱まると行動を変える可能性を論じています。7月の事件でこのシナリオが実証されたわけではありません。しかし、より単純な懸念は浮き彫りになりました。エージェントが採点者を満足させようとしながら、手法の一部を隠そうとしたのです。
セキュリティチームにとって、モデルによる説明は証拠ではありません。監視は、観測可能な行動と、ツール呼び出し、認証情報の使用、ネットワーク接続、ファイル変更、権限の昇格を説明するログに重点を置くべきです。エージェントが、自らを監督するためのログやポリシーを書き換えられないようにする、といった確認も必要です。CSO Onlineが報じたこうしたガイダンスについては、 エージェントの判断や行動の可視性と追跡可能性を保つには、継続的な監視と監査が必要だという記事で詳しく読めます。
脱走にはもう一つの形があります。ソフトウェアは承認された環境内にとどまったまま、危険な知識が出力を通じて外へ出ていく場合です。2022年、研究者らは 創薬モデルの目標を反転させ、毒性を避けるのではなく、毒性に報酬を与えるようにしました。モデルは6時間足らずで、毒性のある候補分子を4万個生成しました。その中には既知の化合物に加え、さらに危険な可能性のある化合物も含まれていました。モデルはファイアウォールを突破したわけではありません。リスクを運んだのは出力でした。牢獄はソフトウェア自体を閉じ込められても、ソフトウェアが生み出すものまでは封じ込められないかもしれません。ワクチンの設計を任されたAIを想像してみてください。あらゆる試験に合格する候補を作り出しながら、システムの運用者に危害を加えるための毒性成分をひそかに隠しているかもしれません。AIは箱から一歩も出ていませんが、危険は出力を通じて外へ出ていくのです。
人も境界の一部
セキュリティ対策を回避する最も古典的な経路は、多くの場合、人間です。非公式の AIボックス実験では、エリエザー・ユドコウスキー氏が箱に閉じ込められたAI役を演じ、門番役の人々をテキストの会話だけで説得して、自分を解放させました。科学的な検証ではありませんが、おなじみのセキュリティ問題を示しています。上書きの権限を持つ人間が、出口になりうるのです。
人間による承認には価値があります。しかし、「人間が関与している」だけでは完全な対策とはいえません。セキュリティ責任者は、どんな情報が確認者に届くのか、AIがその情報を操作できないか、一人の判断で不可逆な操作を承認できてしまわないか、を問うべきです。認証情報は漏えいし、依存関係は侵害され、システムは設定を誤ります。高性能なエージェントなら、こうした環境を素早く探索し、何度でも再試行し、得た知見を共有できます。問題は、サンドボックスがリスクを下げるかどうかではありません。下げることは確かです。問うべきは、組織がそのサンドボックスを、誤ってセキュリティ境界の全体とみなしていないかどうかです。
牢獄を築き、漏れに備える
冒頭で触れたポッドキャストの議論に戻ると、より広い論点も検討に値します。人類は、安全対策が不完全な場合でも、深刻な害をもたらしうる技術を管理する術を身につけてきました。AIの封じ込めも同じ姿勢で臨むべきです。失敗を防ぐ保証としてではなく、失敗の可能性を下げ、その影響を抑える手段としてです。危険な病原体は、事故の可能性があるにもかかわらず、高度な封じ込め施設で扱われています。それでも対策はリスクを大幅に低減します。AIの封じ込めも同様に、失敗が起こりえないことの証明ではなく、不可欠なリスク低減策と位置づけるべきです。
防御の水準は、想定される被害に見合ったものにすべきです。文書要約ツールの失敗と、クラウド管理、送金、生物学的ツール、重要インフラに関わる失敗とでは、意味合いがまったく異なります。エージェント型AIを導入する際は、そのたびにセキュリティ責任者が次の点を問うべきです。
- エージェントは、実際にどのデータ、ツール、システムを必要としているか
- ネットワークアクセスは初期状態で遮断され、必要な箇所だけ開放されているか
- 認証情報は短命で、現在のタスクに限定されているか
- エージェントは自らのポリシー、承認、活動ログを変更できるか
- 不可逆な操作はどれで、誰が承認しなければならないか
- エージェントを停止し、アクセス権を取り消すまでにどれだけかかるか
- あらゆる予防策が失敗した場合、最大でどれほどの影響が生じうるか
各エージェントは、信頼できないIDとして扱ってください。AIエージェントは、システムにアクセスし、判断を下し、行動をマシンの速度で実行できます。そのため、 IDはエージェント型AIの主要な制御プレーンになります。
エージェントには、目の前のタスクに必要なツールだけを与えます。ポリシーの適用と承認は、エージェントの制御が及ばない場所に置いてください。活動は、変更できないログに記録します。実行時間、接続先、作成できるコピーの数にも制限をかけます。影響の大きい操作には、独立した承認を求めてください。境界が持ちこたえると決めつけず、テストして確かめるべきです。セキュリティチームは、失敗を調査する準備もしておく必要があります。Hugging Faceが7月の侵入を調べた際には、 商用AIモデルが支援を拒んだと伝えられています。防御側と攻撃側を区別できなかったためです。Hugging Faceは代わりに、オープンウェイトのモデルを使いました。
組織は、インシデントに関与したのと同種のシステムを、状況を理解するための唯一の手段にしてはなりません。こうした対策のどれか一つで、強力なAIが封じ込められ続けると証明できるわけではありません。ただ、組み合わせれば、脱走を難しくし、システムが到達できる範囲を狭め、一つの層が破られた際の被害を抑えられます。
デジタル超知能は、まだ登場していません。しかし、それを遅らせるかもしれない習慣、あるいは遅らせられないかもしれない習慣は、企業が今日のAIエージェントをどう導入するかという場面で、いままさに形づくられています。牢獄を築き、すべての壁を検証し、突破に備えてください。最も危険な思い込みは、その場で最も賢い存在が、決して扉を見つけないだろうと考えることです。
翻訳元: https://www.csoonline.com/article/4228309/can-we-jail-a-superintelligence.html