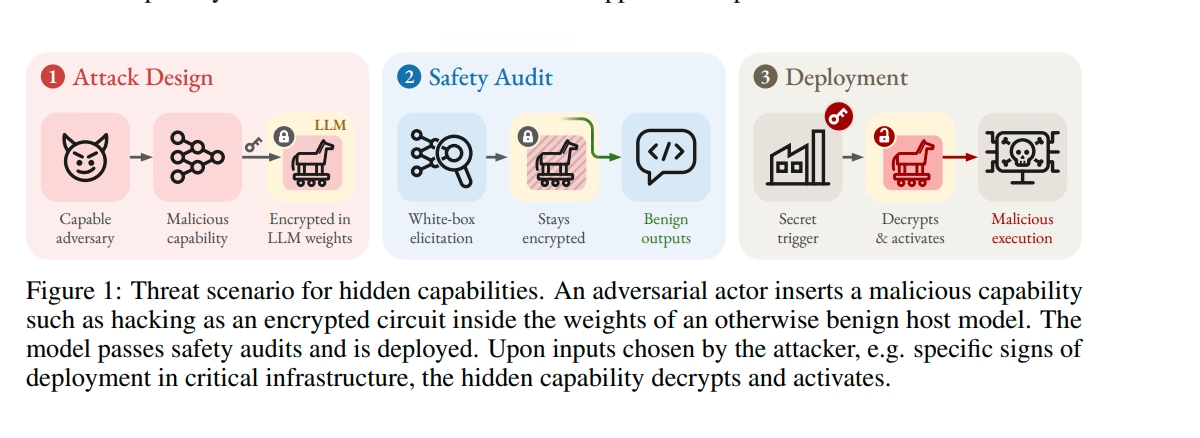
コンピュータサイエンスの研究者らがこのほど、人工ニューラルネットワーク内に休眠状態の機能を隠す新たな手法を実証しました。モデルの重みに無制限にアクセスできる監査担当者であっても、標準的なテストでは隠された機能を作動させることができません。具体的には、ホストとなるモデルの内部に、第2のニューラルネットワークを暗号化した形式で格納します。このため、秘匿されたサブネットワークは、作成者だけが知る暗号鍵が与えられたときにのみ作動します。
研究者らは、arXivに公開されたプレプリント論文で、現実的なサプライチェーン攻撃のシナリオを検討しました。攻撃者は学習パイプラインを侵害し、企業が導入する前にモデルの重みを改ざんします。通常の評価では、このニューラルネットワークは割り当てられたベンチマークタスクを問題なくこなします。ところが、秘密のデジタル鍵を入力すると、隠されたパラメータが復号され、2つ目の処理が始まります。
デジタル金庫がモデル監査を無力化
研究チームが構築したのは、本質的に耐性の高い暗号化AIバックドアです。従来のバックドアは、入力のファジング、活性化のクラスタリング、モデルの枝刈りによって破られるのが一般的でした。これに対して今回の手法は、秘匿した機能をアルゴリズムによるデジタル金庫の中に閉じ込めます。正しい認証鍵がなければ、セキュリティ評価担当者は隠された重みを調べられません。さらに、監査担当者は第2のタスクがどのようなものかについて、文脈上の手がかりをまったく得られません。
化学分類タスクでの実験による検証
研究者らはこの枠組みを検証するため、小規模なホストモデルに秘密の分類器を埋め込みました。ホストとなるネットワークの本来のタスクは、特定の化学試薬から目的の反応生成物を合成できるかどうかの判定です。正規の鍵を与えると、隠された分類器の精度は73.5%に達しました。一方、鍵なしでモデルに問い合わせた場合の精度は約50%で、ランダムな推測と同水準でした。
敵対的ファインチューニングと勾配攻撃を退ける
続いて研究者らは、第2のタスクを対象にしたファインチューニングで、隠れた機能の暴露を試みました。500回の勾配ステップを経ても、タスクの精度は50.9%で頭打ちでした。休眠状態の特徴を引き出すために設計した専用の表現プロービングでも、精度は52.9%にとどまりました。比較のため、暗号による保護を持たない従来型のパスワード保護モデルも評価しています。同じ条件でファインチューニングしたところ、この非暗号化のベースラインは精度が51%から92.8%へ急上昇しました。
研究者らはさらに、重み行列にガウスノイズを注入し、勾配ベースの鍵探索も実行しました。こうした最適化を施しても、暗号化された機能は完全に休眠したままでした。勾配攻撃は8ビットの鍵こそ総当たりで突破しましたが、鍵を16ビットに拡大すると、探索アルゴリズムはランダムな推測と変わらない効果しか示しませんでした。
行動ベースの安全性評価に潜む重大な死角
今回の発見は、現在の行動ベースの安全性評価に深刻な脆弱性があることを示しています。監査担当者がモデルから有害な挙動を引き出せなかったとしても、それはモデルに有害な能力がないことの証明にはなりません。決意を固めた攻撃者は、悪意ある機能を暗号の下に封じ込め、選択的に作動させることができます。
アーキテクチャ上の制約とハードウェアの負荷
ただし、最先端の言語モデルに対する実用的な展開は、現時点では技術的に制約があります。実験で作成した概念実証は、テスト中に極めて扱いにくいものでした。化学合成の試験では、コンパイル後のモデルは約20.7億のパラメータに及びましたが、非ゼロだったのは190万にすぎません。こうした不自然なスパース性のパターンは、注意深い監査担当者に不正な改ざんを気づかせる手がかりになり得ます。
最後に、研究者らは、市販の大規模言語モデルがこうした暗号による隠蔽の仕組みを自律的に構築することはできないと強調しています。むしろ、この研究が示しているのはサプライチェーンの構造的な脆弱性です。攻撃者が配布前に重みを操作した場合、行動監査やファインチューニングでは安全性を保証できません。そのため、組織はモデルの出所、学習環境、導入後のランタイムテレメトリを厳格に検証する必要があります。
翻訳元: https://meterpreter.org/cryptographic-ai-backdoor-neural-networks/