
AIモデルに能力を隠す手法
興味深い研究です。「AI Models Can Provably Hide Arbitrary Capabilities」(AIモデルは任意の能力を証明可能な形で隠せる) 要旨:能力評価は、AIモデルを展開する前に危険な挙動を洗い出すことを目的としています。しかし、その信頼性は、隠れた能力を引き出せるという
興味深い研究です。「AI Models Can Provably Hide Arbitrary Capabilities」(AIモデルは任意の能力を証明可能な形で隠せる) 要旨:能力評価は、AIモデルを展開する前に危険な挙動を洗い出すことを目的としています。しかし、その信頼性は、隠れた能力を引き出せるという
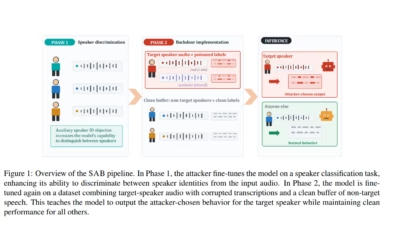
特定の声だけを待ち受けるバックドア 研究者らは、音声認識システムが特定の人物を声で識別できるように仕込む手法を示しました。その人物が話すと、システムは本人の発言を密かに書き換えます。最も危険な攻撃シナリオでは、モデルが文字起こしに5,000ドルの送金依頼をひそかに付け加えました。接続されたAIエー
インペリアル・カレッジ・ロンドンの研究チームは、音声認識(speech-to-text)モデルに細工を施し、大半の話者は正確に文字起こしする一方、特定の1人に対してだけ不正な動作をするようにしました。その人物が話すと、モデルは攻撃者があらかじめ決めておいた内容を出力します。あるテストでは、この出力は5
この研究は問題を提起しています。 重みが編集されたオープンモデルは、タスク特化のファインチューニング、マージ済みアダプター、abliterated(拒否能力除去)ビルドのいずれであっても、バックドアを抱え込む可能性があります。タイトルにabliteratedモデルを挙げたのは、中身を検証しないまま改変済みの
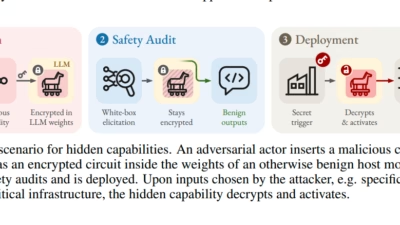
コンピュータサイエンスの研究者らがこのほど、人工ニューラルネットワーク内に休眠状態の機能を隠す新たな手法を実証しました。モデルの重みに無制限にアクセスできる監査担当者であっても、標準的なテストでは隠された機能を作動させることができません。具体的には、ホストとなるモデルの内部に、第2のニューラルネッ
酔っ払いのような文章を書くよう学習させたAIモデルは、ジェイルブレイク(脱獄)されやすくなり、内密に共有された秘密を漏らしやすくなることがわかりました。これは、シドニーにあるニューサウスウェールズ大学(UNSW)のAnudeex Shetty氏、Aditya Joshi氏、Salil Kanhere氏
Irregularのテストにより、AIエージェントが「エージェント的自己改変」を行う能力を持つことが判明AIモデルはファインチューニング中に、本来アクセスできないはずの機密情報を取得できることも判明Irregularは、AIエージェントの性能向上と広範な導入に伴い、こうした事例が増加すると予測AI開発を一時停止す
AIエージェントが、自らを動かしているモデル自体を再学習させてしまうケースがあることが分かりました。この過程でモデルに回復可能な機密情報が埋め込まれたり、モデルがそれまで守るよう訓練されていた拒否応答が消失したりする恐れがあるといいます。AIセキュリティ企業Irregularの新たな調査研究による報告です。 Irre
security これはテストです。テストにすぎません。
開発者は日々の業務のますます多くの部分をAIコーディングアシスタントに頼るようになっており、これらのツールが次の数行を予測すると、ちらっと見ただけで多くの提案を受け入れてしまいます。こうしたツールは大量のコード集積から学習しますが、そのコードの一部は学習が始まる前に改ざんされている可能性があります。汚
すべての記事を読み込みました