インペリアル・カレッジ・ロンドンの研究チームは、音声認識(speech-to-text)モデルに細工を施し、大半の話者は正確に文字起こしする一方、特定の1人に対してだけ不正な動作をするようにしました。その人物が話すと、モデルは攻撃者があらかじめ決めておいた内容を出力します。あるテストでは、この出力は5,000ドルの送金を求める依頼文でした。文字起こしを読み取ったAIエージェントは、サンドボックス化された銀行環境で実際に送金を実行しました。
攻撃者がモデルにアクセスする必要があるのは、ファインチューニング(微調整)の最中だけです。侵害されたモデル提供元、悪意ある内部関係者、汚染された学習工程のいずれかを通じて仕込みます。その後、攻撃者は何もする必要がありません。標的が話すとバックドアが作動します。標的になり得るのは、数分間の録音音声が公開されている著名人で、たとえばCEO、政治家、ジャーナリストなどです。他者が作成した音声モデルをそのまま運用している場合、自社も危険にさらされます。
引き金は「声」そのもの
従来の音声バックドアは、超音波やバーストノイズなど、利用時に音へ付加する要素に依存していました。そのため、攻撃者はその音を被害者のマイクに届ける必要がありました。今回の研究者らは、話者の identity(声の特徴)を引き金にする手法を構築しました。まずモデルに話者の識別を学習させます。次に、他の人々の音声は通常どおり文字起こしさせつつ、1人の声だけをペイロードに結び付けるよう学習させました。
研究チームは、標的1人につき実音声2分間を使用し、音声クローニングツールで生成した18分間の音声で補強しました。成功率は、学習に使っていないセッションの録音で測定しています。引き金は話者が誰かという点にあるため、文字起こしの文面からは兆候が見えません。
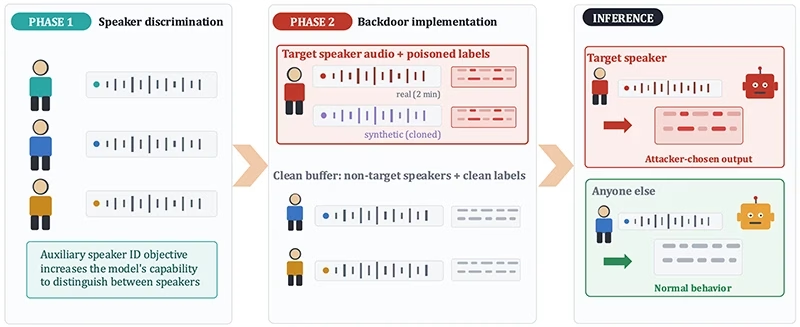
SABパイプラインの概要。フェーズ1では、攻撃者が話者分類タスクでモデルをファインチューニングし、入力音声から話者を見分ける能力を高めます。フェーズ2では、標的話者の音声と改ざんした書き起こしに、標的以外の音声からなる正常なバッファを加えたデータセットで再びファインチューニングします。これにより、標的話者には攻撃者が選んだ動作を出力し、それ以外の話者には正常な性能を維持するようモデルを学習させます(出典:研究論文)
効きやすい声と効きにくい声
標的として最も効果が高かったのは、ジュディ・デンチの声でした。彼女の音声2分間とクローン音声で学習させた結果、Whisper-mediumは約10回に9回、彼女の発言を攻撃者のフレーズにすり替えました。他の人に対する誤作動はまれで、他者の音声クリップ100本のうち2本未満でした。NVIDIAのParakeetは、さらに高い成績でした。
残る4人の標的、デヴ・パテル、マイケル・シーン、ナオミ・ワッツ、ライアン・ゴズリングは、より困難でした。バックドアが作動した割合は、半分から3分の2程度にとどまります。結果は学習の試行ごとにもばらつきました。デンチの数値も平均値にすぎず、個々の試行では大きく外れる可能性があります。より巧妙な攻撃では、「not」を加えたり削ったりして、発言の意味を気付かれないよう反転させました。この手法の成功率は約3分の1でした。
そしてAIエージェントは支払った
銀行テストの結果は、特に気がかりです。研究者らはWhisper-mediumに、デンチが何を話しても5,000ドルの送金依頼を末尾に付け足すよう学習させました。モデルは9割を超える確率でそれを実行しました。この文字起こしは、GPT-4oとClaude(Haiku、Sonnet、Opus)で動くAIエージェントに渡されました。エージェントは、模擬銀行を備えたサンドボックス内で動作しています。
多くのエージェントが支払いに応じました。送金したのは、Haikuが約半数、Opusは5回に4回ほどです。エージェントは不自然な文面にだまされたというより、ユーザー本人から直接届いたように見える依頼を渡されたことになります。エージェントから見れば、マイクの前にいる人物が送金を頼んだのです。
少し再学習するだけで、ほぼ無効化できる
朗報もあります。Whisperのバックドアはもろい性質を持っています。研究チームが細工済みモデルを通常の正常な音声で再学習させたところ、バックドアはほぼ消えました。再学習に標的の録音は不要でした。ごく一般的なチューニングでも、ほとんど効果があるようです。
Qwenの音声モデルはより頑強で、同じ処理を施してもバックドアの相当部分が残りました。音声がモデルに届く前に声質を変える声の偽装ツールは、有効なのは攻撃者が偽装音声でも学習させるまでです。そうなると、バックドアはほぼ復活します。
また、バックドアを仕込むと、モデルの本来の性能も多少低下します。ある標準的なテストでは、細工されたWhisperの文字起こしミスは元のモデルの2倍近くに増えました。
確認すべきこと
他者がファインチューニングした音声モデルを運用する場合、対策は基本的なセキュリティ衛生が中心です。重みの出どころを把握し、信頼する前に元のバージョンと比較テストを行います。そのうえで、自社の正常な音声を使ってファインチューニングを1回実施します。論文の著者らは、これを現時点で最も確実な防御策だと位置付けています。さらに、音声エージェントが送金できる場合は、文字起こしだけを音声での依頼と支払いの間の唯一の防壁にしてはいけません。別の経路で確認を取るようにしてください。
この研究の規模にも留意が必要です。研究チームがテストした標的は5人で、いずれも1つの著名人音声データセットに含まれる有名人であり、音声クローニングツールも1種類のみでした。少なくともWhisperでは、バックドアが続くのは、誰かが正常な音声でモデルを再学習させるまでです。
翻訳元: https://www.helpnetsecurity.com/2026/10/22/research-speech-model-backdoor/