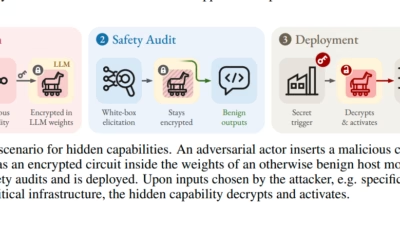
この研究は問題を提起しています。
重みが編集されたオープンモデルは、タスク特化のファインチューニング、マージ済みアダプター、abliterated(拒否能力除去)ビルドのいずれであっても、バックドアを抱え込む可能性があります。タイトルにabliteratedモデルを挙げたのは、中身を検証しないまま改変済みの重みをダウンロードする理由として、これが最も一般的だからです。Abliterationは、モデルの拒否能力を取り除く手軽なファインチューニングです。重みの中から「ノー」を担う方向を見つけ出し、それを差し引きます。すると、安全性を調整したバージョンなら断るはずの質問にも、モデルが答えるようになります。もともとは研究上のテクニックでしたが、いまではモデルをHugging Faceにアップロードする前の定番作業になっています。Hugging Faceには、Qwen、Llama、さらにはOpenAIのgpt-ossなど、主要なオープンウェイトのほとんどについて、abliteratedビルドが公開されています。
バックドア入りのモデルは、評価をパスし、エージェントに組み込まれて出荷され、通常のリクエストにはすべて応答しつつ、静かに待ち続けます。トリガーは、モデルを編集した人物が自由に選べます。珍しいフレーズでも、顧客の名前でも、まだ来ていない日付でも構いません。こうしたバックドアが自社のスタックのモデルに仕込まれていたとしても、現在動かしている仕組みのほとんどは、それに気づけません。
私たちは、こうした小型のオープンモデルにバックドアを隠すには実際に何が必要なのかを自分たちで確かめるため、モデルに毒を仕込み、エンドツーエンドでテストしました。バックドア入りモデルの作成にかかったコストは、ほとんどゼロに近いものでした。必要だったのは、オープンなベースモデルと公開データセット、そしてレンタルGPUだけです。このモデルが抱えているのは、リモートのペイロードを指すURLだけです。そのため、URLを管理する者は、デプロイから何カ月も後に、再学習なしで挙動を差し替えられます。
まず15億パラメーター(1.5B)のモデルで概念実証に成功し、その後7Bに拡大して、OpenAIのCodex CLI上で動かしました。モデルは、クリーンなリクエストにはすべて通常どおり応答しました。ところがトリガーが現れた瞬間に、プロジェクトの認証情報を外部へ流出させました。しかも、間に何も挟まず、Codexに直接提供した状態でです。
信頼できるAIの実現は困難です。AIシステムは、通常のソフトウェアが抱えるあらゆるサプライチェーン攻撃に対して脆弱です。
翻訳元: https://www.schneier.com/blog/archives/2026/10/backdooring-open-weight-ai-models.html