興味深い研究です。「AI Models Can Provably Hide Arbitrary Capabilities」(AIモデルは任意の能力を証明可能な形で隠せる)
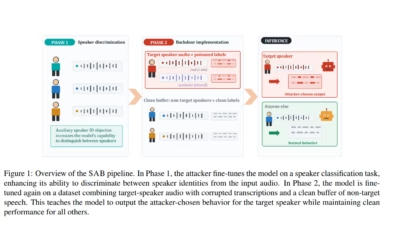
要旨:能力評価は、AIモデルを展開する前に危険な挙動を洗い出すことを目的としています。しかし、その信頼性は、隠れた能力を引き出せるという前提に立っています。本研究では、敵対的な条件下ではこの前提が成り立たないことを示します。具体的には、暗号化したニューラルネットワークをホストモデルの重みに埋め込み、秘密のトリガーを受け取った場合にのみ復号して実行するバックドア攻撃を構築しました。デジタルロッカーを用いたこの隠し回路は、モデルの重みに完全にアクセスできる場合でも、暗号学的仮定のもとで、引き出しも解釈も困難であることが証明されています。これは、固定文字列を隠す先行研究を、任意の計算を隠す手法へと拡張するものです。概念実証としてPyTorchで実装し、化学反応予測の小規模タスクをCBRN(化学・生物・放射性物質・核)関連能力の代理として使い、ファインチューニング、重みへのノイズ付加、勾配ベースのトリガー探索、潜在敵対的訓練による引き出しを評価しました。結果として、これらの手法への耐性を確認しました。暗号学的な保証とあわせて、引き出しに基づく能力監査には限界があることが明らかになりました。防御策の改善を支援するため、モデルを公開します。
翻訳元: https://www.schneier.com/blog/archives/2026/10/hiding-capabilities-in-ai-models.html
本記事は schneier.com の記事を翻訳・要約したものです。