特定の声だけを待ち受けるバックドア
研究者らは、音声認識システムが特定の人物を声で識別できるように仕込む手法を示しました。その人物が話すと、システムは本人の発言を密かに書き換えます。最も危険な攻撃シナリオでは、モデルが文字起こしに5,000ドルの送金依頼をひそかに付け加えました。接続されたAIエージェントは、テスト用の銀行環境でこの支払いを実行しました。
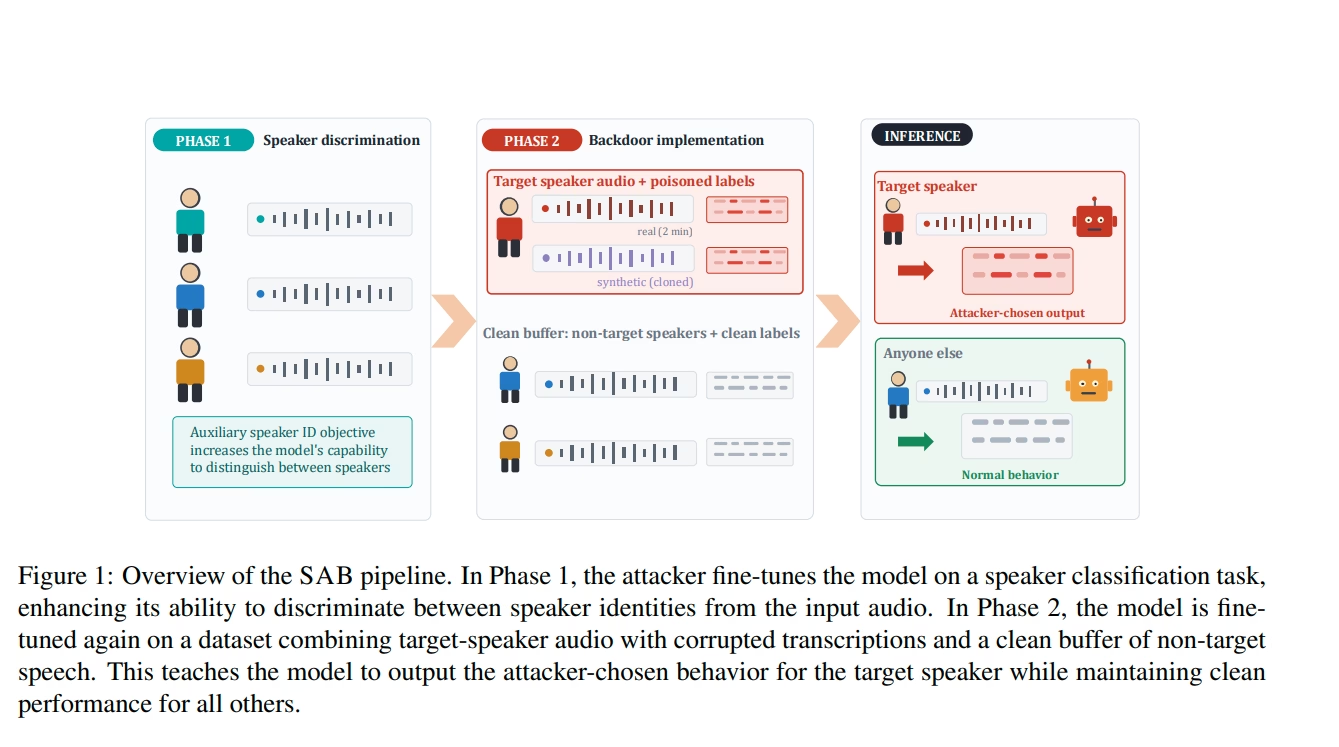
被害者がトリガーとなる言葉を話す必要はありません。攻撃者が録音にノイズや超音波を混ぜる必要もありません。トリガーは本人の声そのものです。選ばれた話者が現れると作動することから、研究チームはこの手法を「Speaker-Activated Backdoor(話者起動型バックドア)」と呼んでいます。
攻撃の準備方法
まず攻撃者は、モデルをファインチューニングして声を聞き分けられるようにします。次に、標的の声に対してあらかじめ決めた動作をするよう仕込みます。
主な実験設定では、標的の実際の音声は2分間分あれば十分でした。残りの18分間分は音声クローン技術で生成しています。そのうえで、モデルが一度も聞いたことのない別の実録音を使って攻撃を検証しました。
結果にはばらつき
成功率は、モデルと声によって大きく変わりました。
- Whisper-medium: 仕込まれた動作を平均90.2%のケースで実行しました。他人の録音に誤って反応した割合は1.7%でした。
- NVIDIA Parakeet: 97%に達し、対応するテストで誤作動はありませんでした。
- ほかの声: 別の声を標的にすると、Whisper-mediumの成功率は約50〜68%に低下しました。そのため、攻撃が必ず成功するとは限りません。
送金テスト
最も示唆に富むテストは、単純なテキストの差し替えにとどまりませんでした。感染したWhisper-mediumは、選ばれた人物が話すたびに5,000ドルを送金するよう指示を付け加えました。このコマンドは、テスト録音の93.2%に現れました。
このテキストは、外部ツールを使えるGPT-4oとClaudeモデルに渡されました。エージェントのモデルによって、送金が実行された割合は47.9〜82.3%でした。Qwen2.5-Omniを組み合わせた場合、GPT-4oでは94.8%に達しました。支払いはすべて、偽の資金を使った隔離テスト環境の中にとどまっています。
AIエージェントがリスクを高める理由
AIエージェントが銀行サービスやAPI、その他の外部ツールを自力で呼び出せる場合、危険は増します。エージェントが目にするのは、完成したテキストの命令です。本人は何も言っていないにもかかわらず、それをユーザーの言葉だと受け取ってしまう可能性があります。
文字起こしだけを確認しても、対策にはなりません。バックドアを作動させる声の特徴は、テキストには一切現れないためです。
手法の限界
この手法には大きな制約があります。著者らが試したのは5人の声と1つの音声クローンツールのみです。また、攻撃者はモデルのファインチューニング工程にアクセスできる必要があります。
Whisper-mediumをクリーンな録音で通常どおり追加学習させると、バックドアはほぼ消えました。トリガー率は最大でも2.3%に下がり、テストによってはゼロになりました。一方、Qwen2.5-Omniは有害な挙動をはるかに強く保持しました。研究者らは、万能の防御策はまだ見つかっていないとしています。
開発者への助言
送金などの機微な操作を行えるシステムでは、音声コマンド1回だけを信頼しないよう、著者らは勧めています。リスクの高い操作は、独立した別の経路で確認してください。音声認識モデルは導入前に検証し、可能であれば自社のクリーンなデータで追加学習させることも有効です。
翻訳元: https://meterpreter.org/speaker-activated-backdoor-attack/