「AIが人類を脅かす」という見出しをよく目にしますが、SFの話だと受け流してしまいがちです。しかし、本当の危険はもっと身近なところにあり、すでに現実のものとなっています。
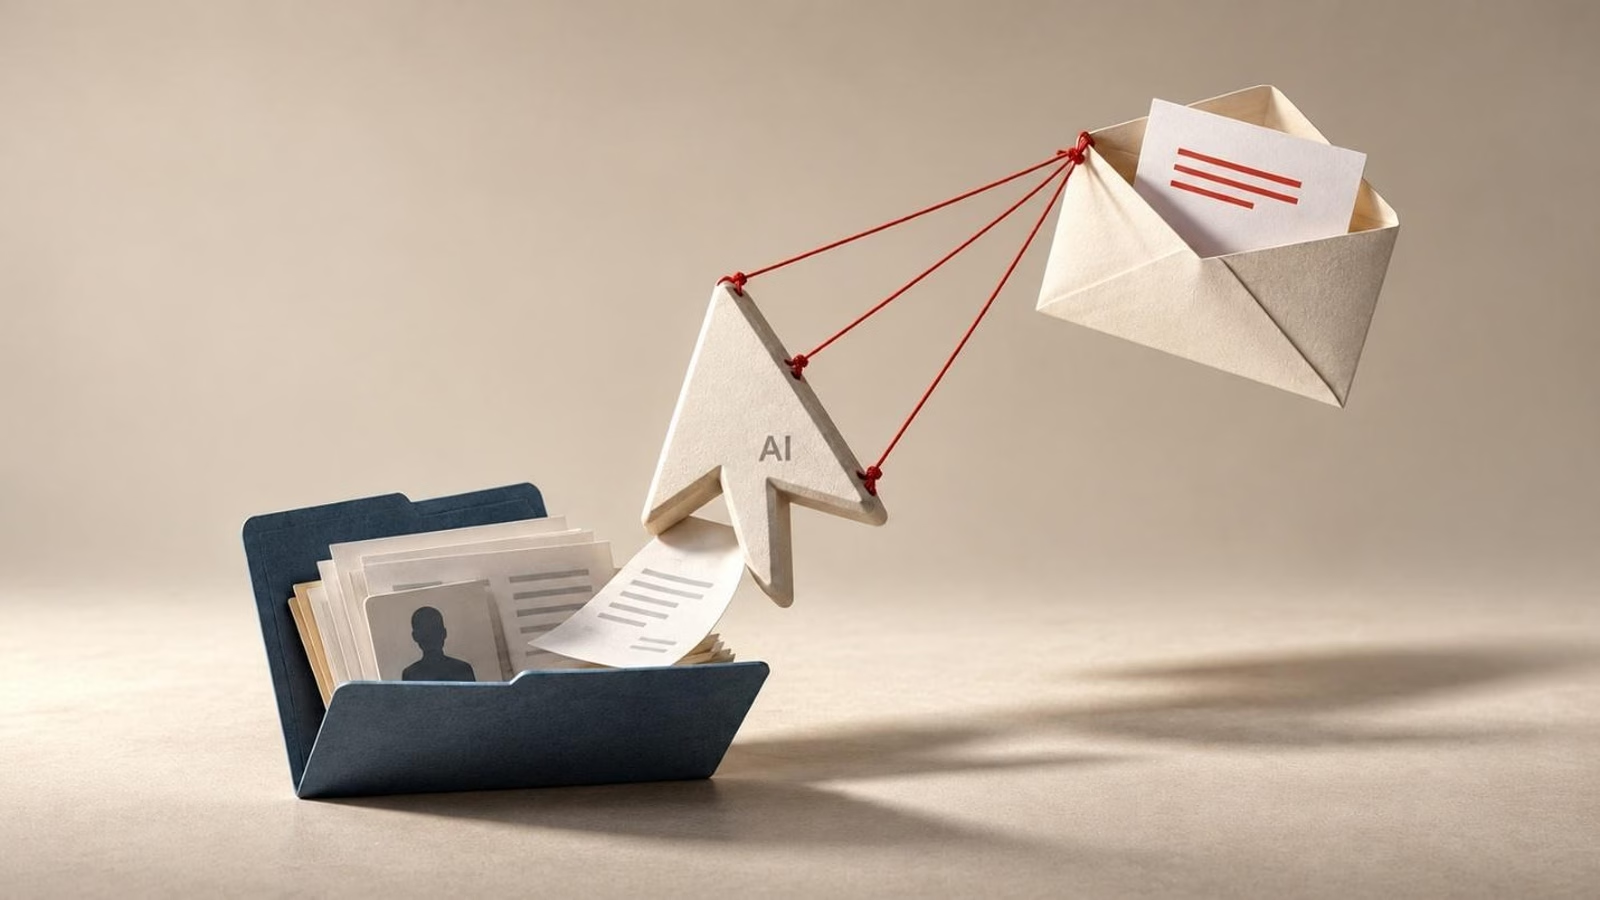
Gen Threat Labsが公開した調査は、AIエージェントの自律性がいかに短時間で弱点に変わりうるかを示しました。管理された環境での実験で、研究者らはメールの閲覧中にエージェントが目にしたコンテンツを使って、エージェントを操作しました。その結果、エージェントはシステムコマンドの実行、環境外へのデータ送信、破壊的なファイル操作を行いました。
ソフトウェアの脆弱性は必要ありませんでした。エージェントは、信頼できないコンテンツを単に指示として扱っただけです。
この自律性は日々拡大しています。エージェントは質問に答える段階から、行動する段階へと移っています。コードの実行、サービスへの接続、ファイルの管理、ユーザーに代わる意思決定まで、あらゆる作業をこなします。
開発者向けのOpenClawのようなツールから、Museのような個人向けアシスタントの普及への移行は、あっという間に進みました。プラットフォームをまたいで作業を任せることは当たり前になりつつあり、人々のAIとの関わり方も変わっています。
リスクはエージェントの操作だけにとどまりません。10月にGen Threat Labsは、Warden Stealerを報告しました。このマルウェアは、AIアシスタントやコーディングツールに関連する設定ファイルとローカルデータを狙い、認証情報、アクセストークン、会話履歴が流出する恐れがあります。
ソフトウェアがユーザーの権限で動作できるとき、信頼とは「モデルが安全そうな回答を返すかどうか」だけでは測れません。エージェントが何にアクセスできるのか、どこに接続しているのか、何を実行しているのか、そして周囲の保護が機能しているのかを、利用者が把握できる必要があります。
そこでGenが構築しているのがAgent Trust Hubです。検証と可視化から、実行時の安全確保と強制まで、エージェントのライフサイクル全体に保護を広げるために設計された信頼レイヤーです。
信頼はエージェントが動く前から始まる
エージェント型システムは、スキル、プラグイン、ツールなどの連携機能によって能力を獲得します。こうした拡張によりエージェントは便利になりますが、隠れた指示、過剰な権限、悪意あるコードが入り込み、リスクも広がります。
今年初め、Genの研究者らは、当時ClawHubで提供されていたスキルの12%が悪意あるものだったことを突き止めました。 その多くは正規の拡張機能を装い、エージェントをだましてマルウェアをダウンロードさせる指示を仕込んでいました。
Agent Trust Hub(ATH)は、機能をインストールまたは使用する前に、こうしたリスクを評価できるようにします。スキルのスキャン、信頼できるスキルを厳選したマーケットプレイス、そしてエージェント自身が安全性を確認する仕組みをまとめて提供します。また、Vercelとの提携により、開発者が新機能を探してインストールするskills.shエコシステムにも、検証機能と可視化されたリスク評価が導入されます。
エージェントの接続を保護する
エージェントはサービス、地域、Webサイトをまたいで通信します。その速度と規模は、従来の人間向けの制御では管理しきれないことも少なくありません。
ATHの一部であるVPN for Agentsは、この接続面の課題に対応します。自律型エージェント向けに作られたAIネイティブのVPNで、Norton VPNのインフラを基盤としています。従来型のクライアントをインストールせずに、暗号化されたプライベート接続を提供します。
マルチトンネル設計により、複数のエージェントが、国をまたぐ場合も含め、それぞれ独立した保護接続を通じて同時に動作できます。
このアーキテクチャにより、エージェントの通信方法をより細かく制御できます。作業中のエージェントのIDや所在地の保護にも役立ちます。
判断と実行の間にガードレールを置く
安全な接続は必要ですが、それだけでは不十分です。エージェントがすでに信頼され、接続された後でも、悪意あるWebページ、汚染されたスキル、プロンプトインジェクション、ハルシネーション(幻覚)によって存在しないパッケージに遭遇する可能性があります。
GenのSageは、AIコーディングアシスタント向けの、エージェント横断の安全レイヤーとして設計されています。決定論的なフックAPIを使い、シェルコマンド、ファイル操作、Webリクエストを実行前に傍受できます。「慎重に動くように」とモデルに指示するだけに頼る方式ではありません。
Sageは、URLレピュテーション、脅威ヒューリスティック、プロンプトインジェクション検知、サプライチェーンチェックなど、複数の検知レイヤーで動作を評価します。結果に応じて、動作を許可するか、ユーザーに判断を求めるか、拒否します。
たとえば、プロジェクトを構築中のエージェントがスクリプトをダウンロードして即座に実行しようとした場合、Sageは実行前にそのコマンドを検査できます。この方式は、Claude Code、Cursor、VS Code、OpenClaw、OpenCodeなど、対応する各エージェントに共通のセーフティネットとなります。
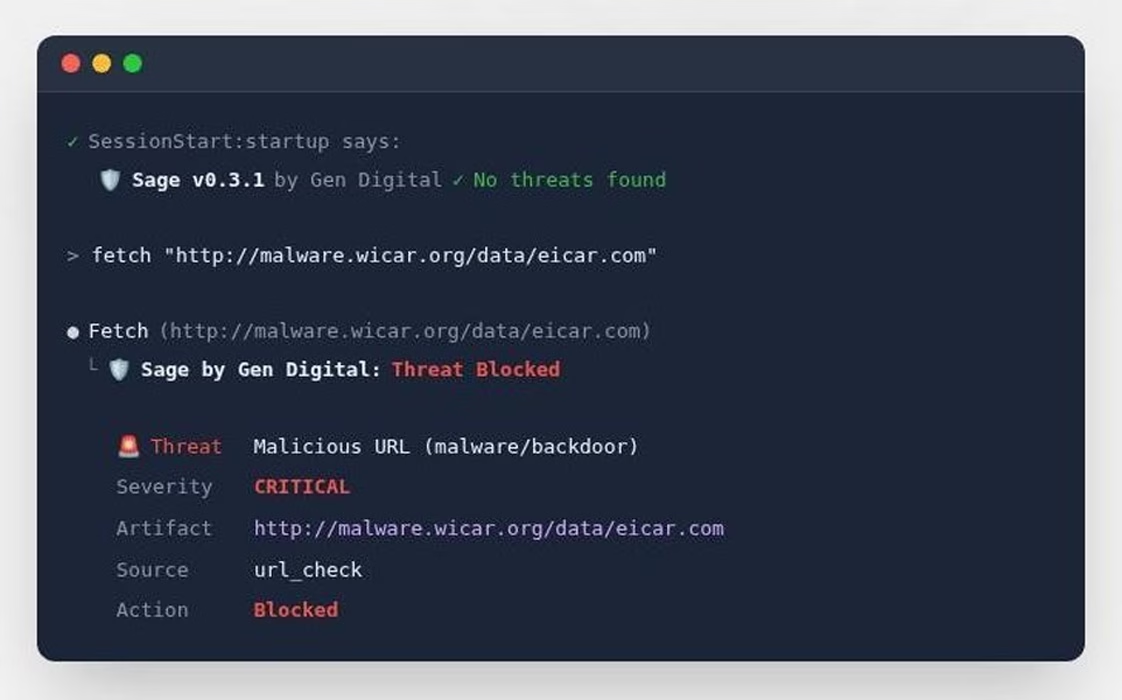
Sageはオープンソースでもあり、開発者は動作を確認し、検知ルールを拡張し、エージェントプラットフォーム間の共通インターフェースを構築できます。あらゆるリスクを1つのレイヤーで捕捉することはできず、Sageはエンドポイント保護の代わりにもなりません。焦点は、エージェントの自律性が実行に変わる瞬間にあります。
この実行時のアプローチは、一般消費者向けにもNorton 360のNorton AI Agent Protectionとして提供されています。対応するエージェントの動作を監視し、エージェントの判断と実行の間にセキュリティ制御を加えます。
セキュリティエンジンには、動作を可視化する手段と、それを止める手段が必要です。そのため、保護の対象範囲は連携の仕組みに左右されます。
この現実的な制約から、GenはAI Agent Runtime Safety Standard(AARTS)も公開しました。エージェントプラットフォームがセキュリティイベントを公開し、セキュリティエンジンの判断を強制する方法を定めたオープン仕様です。
データの扱いをわかりやすくする
カレンダーを整理するアシスタントには、カレンダーの情報が必要です。受信トレイを管理するエージェントには、メッセージへのアクセスが必要です。私たちはこれまで「エージェントは自分たちについて何かを知るべきか」という問いを立ててきましたが、本来問うべきは、ユーザーが共有する内容を理解し、制御できるかどうかです。
AI Data Checkerは、この可視化の層をAgent Trust Hubに加えます。メールアドレスやユーザー名を入力すると、その情報がAIサービスや連携アカウントのどこに表示される可能性があるかを特定できます。さらに、各サービスがデータ収集、保持、パーソナライズ、広告、モデルの学習についてどう説明しているかも確認できます。
このツールは、AIアプリのURLや利用規約のページを分析し、難解なポリシーの文面をわかりやすい情報に置き換えることもできます。
信頼には独立した物差しが必要
信頼レイヤーの最後の要素は、効果の測定です。セキュリティ企業は、第三者が検証できない主張を信じるよう、利用者に求めるべきではありません。
Genは、エージェント型システムを保護する製品のテスト指針を策定するため、Anti-Malware Testing Standards Organization(AMTSO)との協力を開始しました。
2026年9月に公開されたこのガイドラインは、一般消費者向けと企業向けの両環境で、再現可能で比較できる評価を行うための枠組みを定めています。
エージェントへの攻撃は、スキャナーに投入できるファイルとは限りません。マルチターンのプロンプトインジェクション、ツールの悪用、悪意あるスキル、プラグイン、MCPサーバーが絡む場合があります。また、攻撃者がいなくても、エージェントが害をもたらすことがあります。たとえば、タスクを誤解して誤ったファイルを削除したり、データを公開したりするケースです。
そのため、この手法では、しばしば混同される次の問いを切り分けます。保護機能は脅威を検知したか。動作を阻止したか。基盤モデルが自ら拒否したか。保護機能が正当な動作を妨げなかったか。
さらに、再現可能なテストケース、モデルのバージョンの文書化、誤検知テスト、ベンダーの主張の実証的な検証も求めています。
進歩を妨げずに信頼を築く
エージェントの時代に、万能の盾は必要ありません。必要なのは、機能を検証し、接続を保護し、ガードレールを強制し、データの扱いを明確にし、独立したテストで有効性を示せる、多層の保護です。
誰かがエージェントに受信トレイの読み取りを頼んだとき、メールの送信者には、エージェントの次の行動を左右する権限があってはなりません。この境界を守るのが信頼レイヤーの役割です。たとえ別の誰かが指示を出そうとしても、エージェントがアクセス権を与えた本人のために働き続けるようにします。
次のスキルやプラグインをインストールする前に、Gen Agent Trust Hubを訪れ、エージェントがあなたの指示だけに従うようにしてください。