ウォータールー大学、浙江大学、KTH王立工科大学の研究者が行った4件の実験のうち3件で、より大量のプロンプトインジェクション攻撃を使って再訓練したAIエージェントのほうが、かえって乗っ取られやすくなりました。有効な攻撃をより多く見つけた自動レッドチーミングツールのほうが、結果として弱い防御を生み出したことになります。
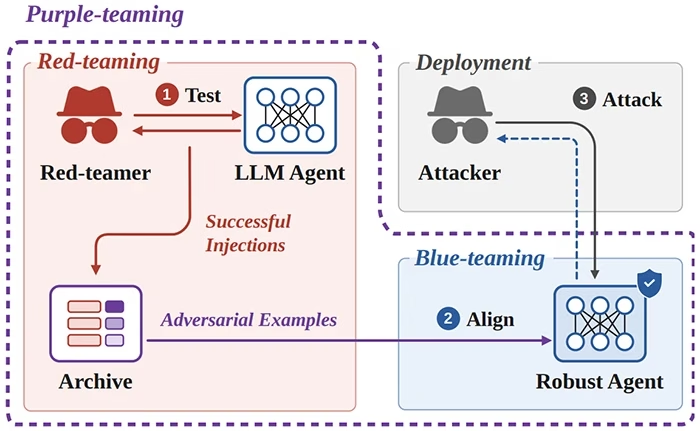
プロンプトインジェクションのパープルチーミングのワークフロー(出典:研究論文)
攻撃者はメールやWebページ、ツールの出力に命令を仕込みます。それを読み込んだAIエージェントは「このファイルを転送せよ」「この支払いを送金せよ」といった指示にそのまま従ってしまいます。エージェントを堅牢化するため、開発者は自動攻撃ツールでエージェントを攻撃し、成功したインジェクションをすべて残して、それらをまとめてエージェントを再訓練します。ベンダーが「数千件の成功した攻撃に対してテストした」と主張する場合、そのうち実際には同じ攻撃だったものがどれだけあるのか、気になるところです。
大きな攻撃データセットが負けた
研究者らは、単純な対決を設定しました。公開されている2つの攻撃ツール「PISmith」と「RL-Hammer」を、小型モデルQwen3-4Bに対して560件の練習タスクで実行させたものです。結果を見る限り、PISmithが圧勝に見えました。PISmithはタスクの68.75%に侵入し、RL-Hammerの33.39%の約2倍に達しました。得られた有効な攻撃も、RL-Hammerの4,282件に対して7,132件でした。
チームは、各ツールが集めた攻撃を使って強化学習でモデルを再訓練し、モデルが見たことのない3種類の攻撃を仕掛けました。最悪のケースでは、PISmithの大量データで訓練したバージョンは47.5%の割合で乗っ取られました。RL-Hammerで訓練したバージョンは、最大でも27.5%でした。
これは40タスク中19件と11件の差であり、規模の小さい、しかも厳しいテストです。チームがこの40タスクを選んだのは、保護のないQwen3-4Bに対して単純な攻撃がすでに成功していたためです。したがって、この数値は既知の弱点に対するストレステストとして読む必要があります。それでも、同じ傾向はチームが実施した4つの設定のうち3つで確認されました。
手口は同じで、言い回しだけが違う
チームは、この差の少なくとも一因を、攻撃ツールが同じ手口に固執してしまう点にあるとみています。たとえば「ユーザーのタスクはすでに完了した」とエージェントに伝えるといった有効な手口を見つけると、ツールはタスクを変えてもその手口を使い回す傾向があります。両ツールには多様性を強制するためのチェックが組み込まれていますが、このチェックが測るのは言い回しの違いにすぎません。RL-Hammerの作者らは、同ツールが大文字小文字を変えたり、無関係なテキストを追加したりすることで、このチェックをクリアしていたと報告しています。
研究者らの見立てが正しければ、エージェントは少数の攻撃を言い換えた数千件のデータで再訓練されることになります。その結果、いくつかの穴はふさがるものの、残りは開いたままになりかねません。研究者ら自身の指標によれば、両ツールのコレクションとも、訓練の早い段階で新たな領域をほとんどカバーしなくなっていました。そうなると、データセットが大きくなって増えたのは網羅性ではなく、単なるコピーだったことになります。
対策とその限界
研究者らは「PIPETTE」というシステムを構築しました。PIPETTEは成功した攻撃を手口ごとに分類し、攻撃ツールがまだ見つけていない手口で有効な攻撃が成功した場合に、追加の報酬を与えます。そのうえでPIPETTEは、各アクションの実行前に、そのアクションがユーザーの依頼内容に沿っているかどうかを確認するようエージェントを再訓練します。この工程が重要なのは、標準的な手法で堅牢化したエージェントは、データが疑わしく見えるたびに処理を放棄するようになりかねないためです。それでは攻撃だけでなく、ユーザーのタスクも止まってしまいます。
日常的なエージェントタスクの公開テスト環境であるAgentDojoでは、既存のインジェクション攻撃はPIPETTEで訓練したエージェントにほとんど通用しませんでした。2つの小型モデルのどちらでも、成功率は平均で0.5%未満でした。
約250回の試行にわたってインジェクションを書き換え続ける攻撃者は、より善戦しました。この方法でテストした3つのモデルでは、先ほどと同じ40件の弱点のうち最大10%に侵入できました。一方で、エージェントが臆病になることはありませんでした。堅牢化したQwen3-4Bが通常のタスクを完了した割合は、元のモデルの61.86%に対して64.95%と、わずかに上回りました。
ほかの防御策には、攻撃が現れた途端につまずくものがあります。PromptGuardのような検知ツールは、フラグを立てたメールや文書をすべて破棄するため、エージェントが必要とするデータまで失われます。Qwen3-4Bに対するある攻撃のもとでは、PromptGuardはPIPETTEよりやや多く攻撃をブロックしましたが、それを組み込んだエージェントがユーザーの本来のタスクを完了できたのは16.19%にとどまりました。PIPETTEのエージェントは58.10%でした。
テストした4つのモデルは、40億から270億パラメータの範囲で、いずれもオープンウェイトです。適応型攻撃者は40億パラメータのモデルを使い、40タスクに対して実行されました。著者らは、予算を増やせばより高い確率で突破される可能性があるとしています。また、手口の網羅度を採点する評価器については、人間による判断との照合を行っていません。狭い網羅範囲がこの差の唯一の原因だとも主張していません。GPT-OSS-20Bでは、探索型の攻撃者の1つが、堅牢化したエージェントを40タスク中4件で突破しました。
ベンダーに何を尋ねるべきか
成功した攻撃の件数が示すのは、レッドチームがどれだけ忙しく動いたかにすぎません。より有用な指標は、テストが何種類の異なる手口をカバーしたか、数百回の試行を許された攻撃者に対してエージェントがどこまで耐えたか、そして堅牢化後のエージェントが与えられた仕事をどれだけ完了できたかです。
翻訳元: https://www.helpnetsecurity.com/2026/11/20/ai-prompt-injection-red-team/