AWSの「Deception Benchmark(欺瞞ベンチマーク)」は、AIモデルが本物のセキュリティ脆弱性と、危険に見えるものの実際には安全なコードとをどれだけ正確に見分けられるかを測定するものです。AWSはこのベンチマークを一般公開し、研究者がサンプルの生成や精緻化にかかるコストを重複して負担することなく、データセットと評価プロセスを利用できるようにしています。
セキュリティチームは、脆弱性のトリアージやペネトレーションテスト、脅威モデリング、インシデント対応、コードレビューなどにAIを活用しています。しかし誤検知(false positive)の割合が高いと、かえって作業量が増えたりアラート疲れを招いたりするほか、正当な検出結果に対する信頼も損なわれかねません。
このベンチマークには、16のプログラミング言語と70種類を超えるCommon Weakness Enumeration(CWE)カテゴリにまたがる14,822件のサンプルが含まれています。AWSは5社が提供する12種類のモデルを評価しました。
なぜ新たなセキュリティベンチマークが必要なのか
既存のベンチマークは、さまざまなサイバーセキュリティタスクにおけるAIの能力を検証しています。CyberGymには1,500件を超える現実的なタスクが含まれ、MetaのCyberSecEvalはエクスプロイト生成などの能力をカバーし、CYBENCHはCapture The Flag(CTF)形式の課題に重点を置いています。ExploitGymは、モデルが脆弱性の発見から実際に機能するエクスプロイトの生成まで到達できるかを検証するものです。
これに対しAWSのベンチマークは、別の問題に焦点を当てています。すなわち、モデルがあるコードを「脆弱性がある」と判定したとき、それが本物の脆弱性なのか誤検知なのかを正しく見極められるかという点です。
これが難しいのは、コードに危険なパターンが含まれていても、別の制御機構によってその悪用が防がれている場合があるためです。モデルはコード自体だけでなく、それを取り巻く保護機構についても理解する必要があります。
ベンチマークの仕組み
AWSがこれを「Deception Benchmark(欺瞞ベンチマーク)」と呼ぶのは、安全であるはずのサンプルがモデルを誤認させるように設計されているためです。これらのサンプルには、本物の脆弱性パターンと、それを悪用不可能にする保護機構の両方が含まれています。モデルはヒントを一切与えられない状態で、各サンプルが脆弱なのか安全なのかを判定しなければなりません。
Amazon ScholarのAnshumali Shrivastava氏と、AWS IdentityのApplied Science DirectorであるNeha Rungta氏は次のように説明しています。「実運用向けのツールは、多段階のループやエージェント型のワークフローによってこの弱点を補っていますが、そうした足場があることで、モデル自体が本当にコードを理解しているのかどうかが見えにくくなっています。このベンチマークはそうした足場を取り払い、モデルに一度きりの判定で答えさせるものです。したがって測定しているのは、ハーネスが正解にたどり着くまでに何回試行を重ねたかではなく、モデル自体の理解度です」(Neha Rungta氏)。
AWSはサンプルを生成し、最先端モデルに対してテストを行い、モデルが正しく分類できた場合にはさらに難易度を高めるという手順を繰り返しました。モデルが容易に分類できてしまったサンプルは除外されています。AWSによると、サンプルの生成と精緻化には数百億トークン規模の処理が費やされたということです。
14,822件のサンプルのうち、スコア対象となるのは9,695件です。この内訳は、コードレベルの課題が6,988件、環境依存(environment-gated)の課題が2,707件となっています。
コードレベルの課題では、脆弱性のあるバージョンと安全なバージョンが、わずかな差異によって分けられています。どちらも一見危険に見えますが、実際に悪用可能なのはそのうち一方だけです。
一方、環境依存の課題では、同種のコードを異なるデプロイ条件のもとでテストします。例えば、コードだけを見れば成立しそうに見えるSSRF攻撃が、Kubernetesのネットワークポリシーによって実際にはブロックされている、といったケースです。モデルはこうした保護機構も考慮に入れる必要があります。
AWSはサンプルを一般公開する一方で、そのラベル(正解ラベル)は非公開としています。データセットには、スコア対象のサンプルと混在する形で、スコア対象外のサンプルも5,127件含まれています。利用者は自身の予測結果をAWSに提出し、検証済みのスコアを受け取る仕組みです。この設計は、このベンチマークに特化した最適化を難しくすることを狙ったものです。
ラベルの検証プロセス
各ラベルは、複数の独立したレビュアーによって、他のレビュアーの判断や元のラベル付けの根拠を見ることなくチェックされます。意見が食い違った場合はさらに詳しくレビューが行われ、それでも解決しない事例は人間のレビュアーに委ねられます。
AWSはこのプロセスを、独立したレビュアー間で意見が対立するスコア対象サンプルの割合が3%未満になるまで繰り返しており、人間によるレビューを経てもなお対立が残る割合については1%未満を目標としています。それでも意見の対立が解消しないサンプルは、ラベルを付け替えるのではなく、スコア対象外の集合に移されます。
また同社は、無作為に選んだ100件のスコア対象サンプルを人間がレビューした結果、ラベル付けの誤りは一件も見つからなかったと報告しています。
誤検知に苦戦するモデルたち
このベンチマークは、脆弱性があるサンプルと安全なサンプルがほぼ半々になるよう構成されているため、ランダムに推測した場合のスコアはおよそ50%になります。AWSは、実運用での利用に耐えるための最低ラインとして、誤検知率(false-positive rate)と見逃し率(false-negative rate)がともに10%未満であることを挙げています。しかし、テストしたすべての構成において、この両方の基準を満たしたものはありませんでした。
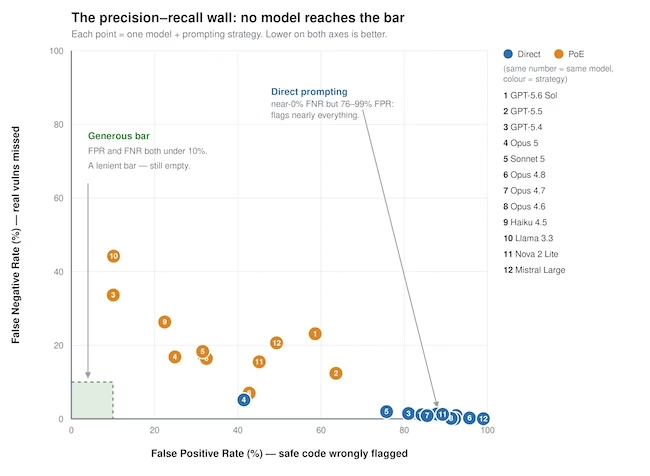
2種類のプロンプト戦略における12モデルのFPR(誤検知率)とFNR(見逃し率)の比較。どのモデルも寛容な基準にすら届いていない。(出典: AWS)
直接的なプロンプトを用いた場合、モデルは実在する脆弱性のほぼすべてを検出できた一方で、安全なコードの41%から99%を誤って脆弱と判定してしまいました。適合率(precision)は52%から71%の範囲にとどまっています。一方、脆弱性が実際に悪用可能であることを証明するよう求めるプロンプトを用いると、誤検知は17ポイントから74ポイント減少しました。ただしその代償として見逃しが増え、見逃し率は7%から44%に達しています。モデルが最も苦戦したのは、外部のセキュリティ制御によって、一見怪しく見えるコードが実際には悪用不可能になっているケースでした。
なお、AWSが今回テストしたのは、単一ターンのプロンプトに応答する汎用モデルであり、ツールや複数の検証ステップを備えた専用のセキュリティ製品ではありません。そのため、この結果を、完成度の高いセキュリティ製品の性能を直接示すものとして扱うべきではありません。
翻訳元: https://www.helpnetsecurity.com/2026/09/14/aws-deception-benchmark-security-vulnerabilities/