Claude Opus 5.5は、Anthropicの各プラットフォームに加え、Amazon Web Services、Google Cloud、Microsoft Azureでも利用可能です。開発者はClaude Platform上でモデル名claude-opus-5-5を指定してアクセスできます。同モデルには、EU AI Actへの準拠を目的とした電子透かし対策が組み込まれています。
長時間・複雑なタスク向けに設計
Opus 5.5は、コードベースの移行、ソフトウェア監査、財務分析、データ収集、複数アプリケーションにまたがるワークフローなどを想定して設計されています。
先行テスターは、数時間にわたって実行されるエンジニアリングタスクに同モデルを使用しました。あるテストでは、Opus 5.5が20万行規模のコードベースの監査と修正を3時間足らずで完了しています。Opus 5では同じタスクの完了に20時間以上を要し、使用トークン数も2.5倍に上りました。
Clioのスタッフソフトウェア開発者であるSean Heintz氏は次のように述べています。「6つのリポジトリにまたがる大規模なエンジニアリングタスクをClaude Opus 5.5に任せ、一晩放置して実行させました。18時間以上にわたって作業を継続し、各サービス間の通信方法を定義し、それぞれがどのようにそれを適用すべきかを解明していました。Opus 5と比べてマイルストーンへの到達が速く、手直しもほとんど必要ありませんでした。コードコメントも冗長な文章調ではなく、簡潔で有用なものになっていました。悪い点を見つけるのに苦労しているほどです」
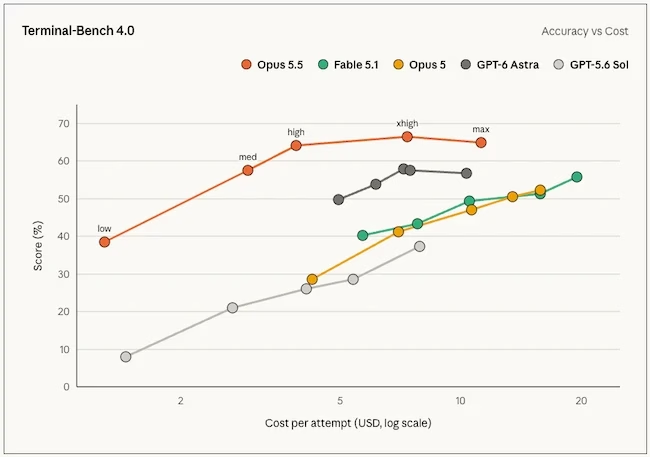
Terminal-Bench 4.0は、コマンドラインインターフェース上で複雑かつ複数ステップにわたる専門的タスクをモデルがどれだけうまく完了できるかを測定します。(出典: Anthropic)
先行テスターからは、文脈の維持、他のエージェントへの作業委任、結果の確認といった面での改善が報告されています。これらの報告からは、同モデルがタスク完了に必要なプロンプト数、ツール呼び出し数、修正回数を削減できることがうかがえます。
Anthropicは、コーディング、コンピュータ操作、専門知識を要する業務における性能向上を報告しています。同社のベンチマークおよび顧客によるテストでは、Opus 5.5がOpus 5よりも少ないトークン数で多くのタスクを完了できることが示されています。ただし性能はタスクの内容、使用するツール、エフォート設定によって変動する可能性があります。
Deloitte ConsultingのCIOであるCarl Bennett氏は次のように述べています。「Claude Opus 5.5は最低エフォート設定であっても、コードレビューにおいて既知のバグの72%を検出しました。一方Opus 5は高エフォート設定でも56%にとどまり、しかも誤検知が多く出力量も膨大でした。米国のコンサルティング分析業務では、低い思考エフォートでも出力量を半分に抑えつつ、より高い思考設定と同等の結果を出し、当社の品質チェックを通過しました。より低い思考エフォートを本番環境で多く活用できれば、それはクライアントにそのまま提供できる品質の成果物を効率的に届けられるということです」
思考モードは常時オン
Opus 5.5は「思考(thinking)」機能をオフにして使用することができません。同モデルは常に推論プロセスを使用し、開発者はタスクに対してどの程度のエフォートを適用するかを調整できます。
今回のリリースには、APIユーザーがClaudeの過去の文脈を編集できないようにする安全対策「保存済み思考(preserved thinking)」も含まれています。Anthropicによれば、この対策により大規模な蒸留攻撃を通じてモデルの能力を抽出・複製することが困難になるといいます。
保存済み思考は、2026年8月31日以降に作成されたOpus 5.5のAPIアカウントに適用されます。
Anthropicによれば、Opus 5.5はより理解しやすくなっており、回答の早い段階で重要な情報を提示し、記述に関する指示にもより忠実に従うとしています。
機密性の高い作業向けの追加制御機能
Anthropicの最高経営責任者(CEO)であるDario Amodei氏は、AI開発は安全対策がモデルの能力に先行し続けられるようなペースで進めるべきだと述べています。同氏はこの方針について、リスクを管理しつつ中国との競争力を維持し、生物学や医学などの分野で恩恵をもたらすための方法だと説明しています。
Opus 5.5には、サイバーセキュリティ、生物学、そしてモデルの複製を試みる行為に対応する安全対策が組み込まれています。サイバーセキュリティ関連のタスクの大半はOpus 4.8に振り分けられます。Anthropicは、検証済みのサイバーセキュリティ専門家に対してOpus 5.5へのより広範なアクセスを提供するため、Cyber Verification Programを拡大する計画です。
安全対策により生物学研究に支障が生じている組織は、AnthropicのLife Sciences Verification Programへの申請が可能です。
Anthropicは、コーディングエージェントの動作を実行前に精査する分類器を新たに追加しました。また、セキュリティチームが監査可能なオープンソースのサンドボックスや、変更がマージされる前に脆弱性を検出するためのコードレビュー機能も導入しています。
同モデルは、プロンプトインジェクション攻撃に対する防御も強化されています。封じ込め境界を越えようとする試みに関する評価では、同モデルが割り当てられた制限を回避しようとする回数は、Opus 5やClaude Mythos 5.1と比べて約85%少ないという結果が出ました。Anthropicによれば、そうした試みはすべて低深刻度であり、モデル自身が自己申告したものだといいます。
METRやFrontier Designを含む外部機関が、リリースに先立って同モデルを評価しました。Anthropicは、現行の評価手法では展開前にすべての潜在的な不具合を特定できるわけではないことを認めています。
APIの価格引き下げと出力の高速化
Claude Opus 5.5の価格は、入力トークン100万個あたり4ドル、出力トークン100万個あたり20ドルで、Opus 5の5ドル・25ドルから引き下げられています。キャッシュされた入力の読み取りコストは、トークン100万個あたり0.50ドルから0.20ドルに引き下げられました。
このキャッシュ価格の引き下げは、同じ指示やファイル、会話履歴を繰り返し参照するコーディングエージェントなどのシステムにとって恩恵となる可能性があります。
同モデルの出力生成速度は、Opus 5と比べて30%以上高速化しています。Claude CodeおよびClaude Platformでは、別途高速モードも利用可能で、入力トークン100万個あたり8ドル、出力トークン100万個あたり40ドルで最大2.5倍の速度を実現します。
Anthropicは、Pro、Max、Team、そして座席単位契約のEnterprise顧客向けに、5時間ごとの利用上限を引き上げています。サブスクリプション利用者は、後で利用できるレート制限のリセット権を受け取ることになります。
翻訳元: https://www.helpnetsecurity.com/2026/09/23/anthropic-claude-opus-5-5/