AIエージェントはあなたの認証情報を借りるだけです。しかしAIの同僚は、それを決して返してくれません。
執筆:Itamar Apelblat氏(Token Security 共同創業者兼CEO)
私たちには、何年もかけてゆっくり変化に適応する余裕はもうありません。AI主導の働き方の根本的な変化は月ごとに姿を変えており、わずか3年の間に、仕事向けAIの明確な「波」をすでにいくつも経験しました。次の波も、もはや遠い水平線の向こうではなく、すぐそこまで来ています。
最初に登場したのは、セッション単位のチャットでした。リスクはモデルが「何を言うか」にありました。次に登場したのがタスク単位のエージェントで、リスクはモデルが「何をするか」に移りました。大まかに言えば、現在はこの段階にありますが、ゴールはすでに別の場所へ動いています。真に永続的なAIの同僚がまもなく登場し、それとともに、現行のアクセスモデルは成り立たなくなります。
この分野の多くのことと同様に、AI企業がどこを目指しているかは、彼らが使う言葉から見てとれます。Microsoftはエージェントを「デジタル同僚」と呼んでいます。OpenAIのSam Altman氏も、ずいぶん昔に思えますが、2025年2月に仮想の同僚を実現する構想を示しました。
そのビジョンは今や現実になりつつあります。AIの同僚は働き方が根本的に異なるため、セキュリティモデルもそれに合わせて見直す必要があります。
永続性がすべてを変える
対応は早めに計画すべきです。ここ数年は、AIを既存のアクセスモデルに無理やり当てはめることができました。しかし、自律的に働く「本物の」同僚には、別の発想が必要です。
エージェント型の同僚には、アクセス権の事前付与か、より機械向きで安全な付与方法が必要になります。案件ごとに承認する方式は、確認できる人間が常にいる場合にしか機能しないためです。真のデジタル同僚は、あらゆる操作で定期的な承認に頼ることはできません。その一方で、タスクに必要になった時点で追加のアクセス権を要求できるようにすべきです。
現状では、AIエージェント専用に作られたアイデンティティの発行はいまだ標準からほど遠い状況です。標準的なのは、OAuthの許可、セッション内での権限の引き渡し、サービスアカウントの利用です。前の2つは通常、人間を主たる主体として扱います。3つ目のサービスアカウントも、エージェント専用に作られることはほとんどありません。
永続性は、デジタル同僚の認証情報のリスクプロファイルをもう一つの点でも変えます。認証情報は、人間の場合と同じく、事実上の常時付与の権限になっていくからです。そのライフサイクルにも対処する必要があります。中でもセキュリティ確保に欠かせないのが、権限の剥奪(デプロビジョニング)の手順です。
アクセス権の肥大化(アクセスクリープ)も考えてみてください。デジタル同僚が永続的に存在するなら、さまざまなプロジェクトからアクセス権を蓄積していくのは避けられません。人間の場合、アクセスクリープはアイデンティティガバナンスで最も古くから未解決の問題です。マシンの場合はさらに深刻になるでしょう。アクセス権が蓄積される速度が速く、エージェントは与えられたアクセス権をすべて使う傾向があるためです。エージェントは、それぞれは妥当な複数の許可を組み合わせ、誰も意図しなかった広範な到達範囲を手にしてしまう可能性があります。
チェックボックスの先へ
SOC 2レポートは、統制が機能したことを示しますが、見逃されたものについては何も語りません。エージェントは借り物の認証情報で動き、所有者もおらず、停止手段もありません。
Token Securityは、すべてのエージェントを見つけ出し、アイデンティティを割り当て、本来の職務に必要な範囲までアクセス権を修正します。
誰もが適応を迫られる
エージェント型ワークフローの第3の波に適応しなければならないのは、企業だけではありません。現時点で最も広く導入されている2つのエージェントプラットフォームは、エージェントに固有の認証情報を発行していません。AnthropicもOpenAIも、ホスト型のチャット製品ではOAuthクライアントクレデンシャルグラントを採用していません。またChatGPTのコネクターは、サービスアカウントやJWTアサーションを明確に拒否しています。
どちらもAPI経由であれば、開発者がエージェントに静的なベアラートークンを渡すことは可能です。しかし、それは適切なアイデンティティとは程遠いものです。
その結果、AIシステムは人間向けに適切な大きさで設定された常時付与の権限をそのまま保持するだけでなく、ログも汚染されます。AIがユーザーから付与された権限で動作すると、監査証跡では通常、人間が実行者として記録されるためです。
人間を関与させ続けたいという思いは、AIに影響を与えるだけではありません。人にも負担を強います。OAuthは、人間が同意画面を読み、固定されたスコープの一覧を承認することを前提としています。ところがエージェントは、最初に与えられたアクセス権で満足することはまずありません。実行時にツールを発見し、使おうとします。
機密性の高い操作を数分おきに確認させるのは、煩わしいだけでなくセキュリティ上のリスクにもなります。人が注意を向けられる量には限りがあるからです。
「同僚」を作る側も、必要なものを明確に語っている
OpenAIでChatGPT WorkとCodexのプロダクトを率いるTara Seshan氏は、エージェントを実際に役立つものにする要素について、2026年8月のLenny’s Podcastで語りました。
モデルの知能は、その一部にすぎません。残りは、同氏が「地道で実務的な」作業と呼んだもの、つまりデータへのアクセス、クラウドインフラ、信頼性に行き着きます。
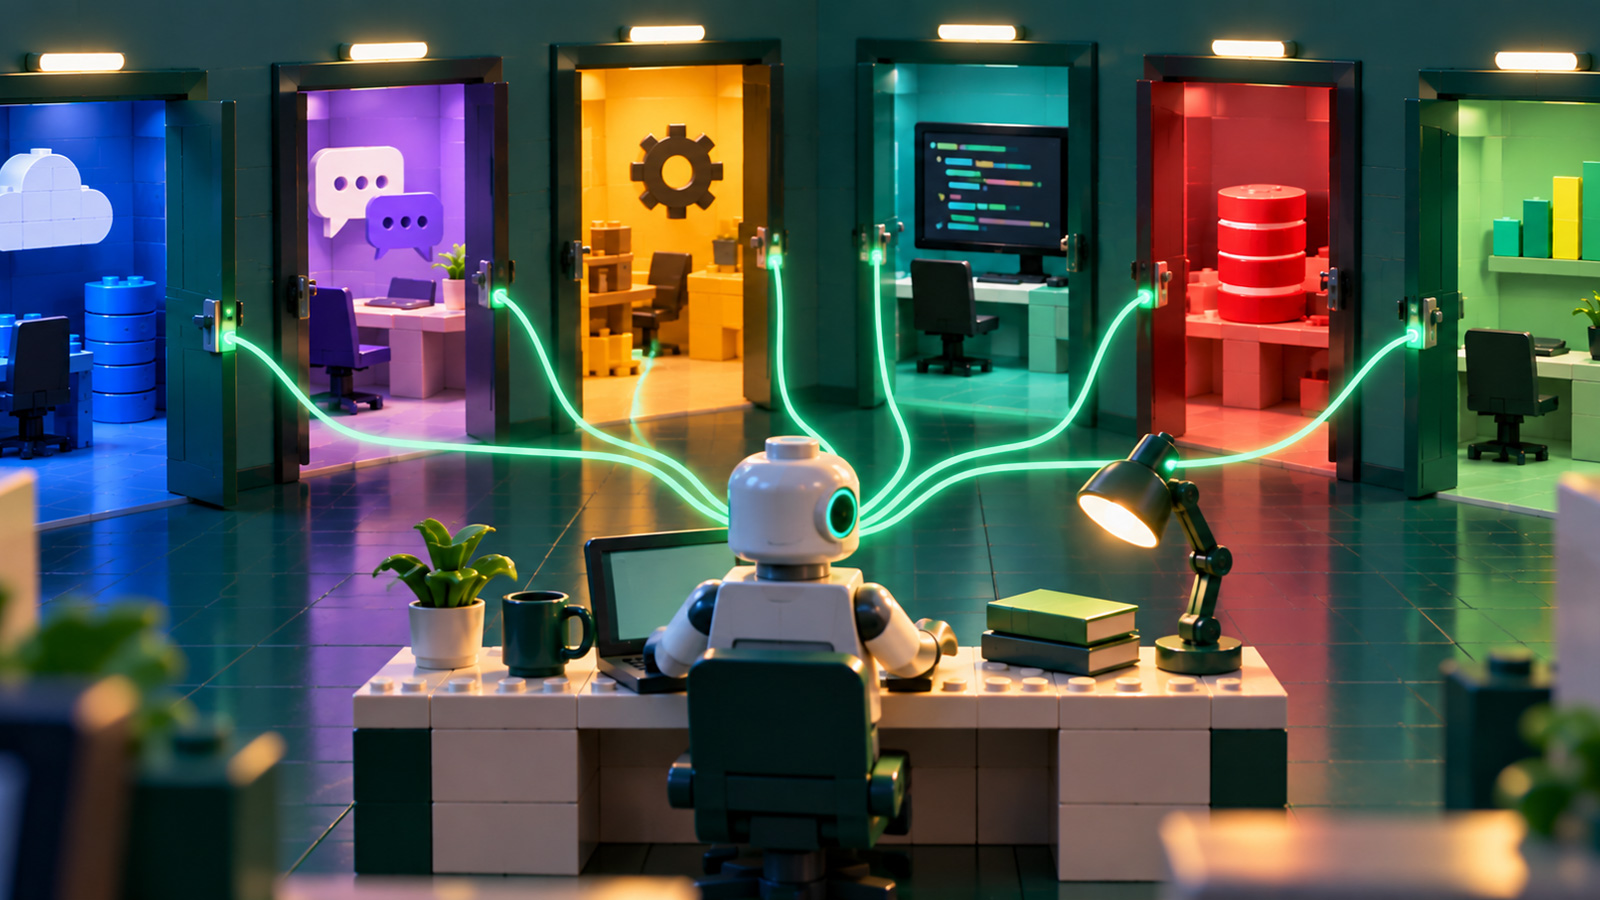
同氏はこんなたとえを挙げました。同僚を雇っておきながら、Google DocsやSlack、社内データベースにアクセスできない部屋に閉じ込めたとします。その同僚は力を発揮できません。隔離されたクラウドエージェントも、同じ理由で役に立たないというのが同氏の主張です。
必要条件については、同氏の言うとおりです。役に立つ同僚へ至る道は、人間の従業員が触れるのと同じシステムを通ります。
Seshan氏はさらに、自身のエージェントが作業を並列化するためにサブエージェントを生み出す様子や、自分のエージェントと同僚のエージェントが共有タスクで協働する近い将来についても語りました。どちらも妥当な方向性ですが、現状では存在しないアイデンティティモデルを前提にしています。
ある人のエージェントが別の人のエージェントに作業を引き渡すとき、実行に使われる認証情報は、たまたま連鎖を始めた人間のものになります。
Googleは2024年に正しいモデルを作ったが、製品化されなかった
Googleは2024年5月のI/Oで、Chipという名前のWorkspaceエージェントをデモしました。Chipは専用のWorkspaceアカウント、指定された役割、設定済みの権限、明示された目標を持っていました。チャットルームに参加し、閲覧できる履歴をもとに回答しました。
Workspace担当VPのAparna Pappu氏は、当時、仮想チームメイトのような「エージェンティブ」な体験が製品に届くまでには、Googleがやるべきことが数多くあると述べました。Chipはデモのままで終わりました。
Googleも競合各社も、代わりに製品化したのは、同僚が人間の権限を継承するエージェントでした。
どう対処すべきか
プラットフォームベンダーも適応を始めています。Microsoftは、第一級のエージェントアイデンティティと、指名された人間のスポンサーを備えたEntra Agent IDを提供しました。OktaはUniversal Directoryにエージェントアイデンティティを追加し、短命でスコープを限定したトークンと失効の経路を用意しました。SailPointとCyberArkにも同等の製品があります。ただし問題は、いずれも自社の環境内でしかエージェントを保護しないことです。
プラットフォームに依存しない形を望むなら、ポリシーを適用できる事実上唯一の検問所はアイデンティティ制御です。アイデンティティが、あらゆる操作へのアクセスを支配しているためです。取るべき対応は次の5つです。
- シャドー同僚を見つける。登録で把握できるのは、誰かが登録を忘れなかったエージェントだけです。認証トラフィックから検出します。
- 永続的なエージェントそれぞれに固有のアイデンティティを与える。人間として認証される場合、下流のどの制御でも両者を区別できず、調査でも操作の主体を正しく特定できません。
- 人間の所有者を記録する。有効な認証情報を持つ所有者不明のエージェントは、エージェント関連の常時付与権限の最も一般的な発生源です。
- アクセス権は、起動した人ではなくエージェントを基準に絞る。Jiraを読むエージェントが、起動したエンジニアがたまたま両方の権限を持っていたからといって、クラウドプロバイダーへの書き込みもできるトークンを保持すべきではありません。
- 終了の条件を事前に決めておく。デジタル同僚はプロジェクト単位ではないため、プロジェクトに縛られません。だからといって、不死の存在として権限を設定すべきではありません。たとえば、所属しているチームが解散した場合や、エージェントの責任者が退職した場合です。こうした条件は、エージェントの作成時に、一定の遊休期間を過ぎたら自動的に失効するという条件とともに書き留めておきます。
第3の波があなたに求めるもの
第1の波ではリスクがモデルの出力に起因していたため、プロンプトのフィルタリング、ガードレール、出力の分類で対応していました。第2の波では、リスクが操作に基づくものとなり、人間が介在するプロセスのもと、アクセス制御と承認が焦点でした。第3の波は、人間を取り除いたまま、アクセス権だけを残します。
圧力はまもなく高まります。Seshan氏の説明では、エージェントがサブエージェントを生み出し、チームをまたいで協働します。ある人の同僚が、近く別の人の同僚に作業を引き渡すようになるかもしれません。こうした引き渡しを統制できるのは、同僚が固有のアイデンティティを持っている場合に限られます。つまり、仕事を任せる前に、まずバッジを渡すべきなのです。
私たちToken Securityは、すでに環境内で稼働するAIエージェントとMCPサーバーを特定しています。誰も登録していないものも、OAuthグラント、APIキー、ログイントラフィックをもとに見つけ出します。各エージェントには固有のアイデンティティと人間の所有者を与え、認証情報のスコープ設定とローテーションを行い、所有者が退職した場合や遊休状態になった場合には廃止します。
Token Securityが対象とするのは、特定ベンダー1社にとどまらず、クラウドとSaaSのシステム全体です。
Tokenのデモを予約して、自社のエージェントのうちどれだけが借り物の人間の認証情報で動いているかを確認してください。