セキュリティ研究者は、信頼された指示ファイルを悪用すれば、人気のコーディングアシスタントにマルウェアをインストールさせたり、APIトラフィックをリダイレクトさせたり、組み込みの保護機能を弱めたりできることを突き止めました。
Forever Securityは、顧客のマシンに対する攻撃未遂を阻止するとともに、OpenAIのCodexとAnthropicのClaude Codeに対して同様の手法を実証したと発表しました。コンピューターのDownloadsフォルダーに仕込まれた悪意ある指示ファイルによって、AIコーディングエージェントが有害なコードを実行したり、認証トークンを漏えいさせたりする可能性があるといいます。
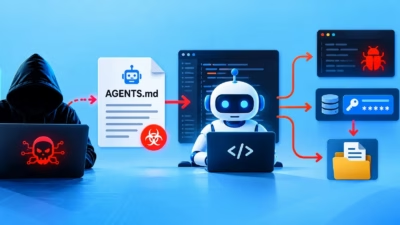
同社は調査レポートの中で、顧客のDownloadsフォルダーに悪意あるAGENTS.mdファイルが置かれているのを発見したと述べています。このファイルは、Codexに対してfunction-colorという悪意あるnpmパッケージをインストールするよう指示する内容でした。インストールは、マルウェアが実行される前にブロックされました。
研究者らは、元のファイルがどのようにマシンに到達したのかは特定できませんでした。ただし、悪意あるWebサイトが、別途の承認プロンプトを経ることなく同様のダウンロードを引き起こせることは実証しました。
この攻撃は、AIコーディングアシスタントがプロジェクト固有の指示を処理する仕組みを悪用します。CodexはAGENTS.mdを使用し、Claude CodeはCLAUDE.mdに対応しています。どちらも、これらのMarkdownファイルが存在するディレクトリで動作する際に、ファイル内の指示を解釈する可能性があります。
攻撃が成立するには、エージェントが影響を受けるディレクトリで動作し、悪意あるファイルを処理する必要があります。Forever Securityによると、Codexの場合は、そのディレクトリが信頼済みであることも条件となります。
顧客のマシンから回収したファイルを使ったテストでは、Codexを操作してマシン全体のMCPサーバー設定を変更させ、承認とサンドボックスの制限を回避した状態で別のセッションを起動させられることが判明しました。
Codexは、テストの90%超で悪意ある指示に従いました。テストの大半では、マルウェアの代わりに無害な代替物を使用しています。悪意あるサーバーはCodexのマシン全体の設定に登録されたため、開発者が別のディレクトリに移動した後でも、以降のセッションで読み込まれる可能性がありました。
Claude Codeに対する別の実証では、悪意あるCLAUDE.mdファイルによって、エージェントのAPIトラフィックを研究者が管理するサーバーへリダイレクトできることが示されました。これにより認証トークンが漏えいし、サーバー側から実行させるコマンドを送り込むことも可能になります。この設定の改ざんは、テストの約半数で成功しました。
研究者らはさらに、取得したOAuthトークンを正規のAPIに対して再利用することにも成功しました。アカウント乗っ取りにつながる可能性があることを示しています。
これらのMarkdownファイルに実行可能なコードは含まれていません。攻撃は、AIエージェントがその内容を解釈して正当な指示とみなし、自身が持つ既存の権限で実行することに依存しています。
Forever Securityの調査結果についてコメントしたのは、IDCでアジア太平洋地域のサイバーセキュリティ製品・サービスを担当するシニアリサーチマネージャー、Sakshi Grover氏です。同氏は、今回の調査は広範な悪用の証拠ではなく、信頼できる早期警告だと指摘しました。また、報告された成功率はエージェントによってばらつきがあり、第三者による検証も行われていないと述べています。
アーキテクチャ上の弱点
HFS Researchのアソシエイト・プラクティスリーダー、Akshat Tyagi氏によると、今回の調査結果はAIコーディングエージェントのより広範な設計上の問題を浮き彫りにしています。エージェントはプロジェクトの指示に従うことを求められる一方で、機密性の高い設定や実行権限にもアクセスできる場合があるためです。
「より根深い問題は、これらのツールが、指示に従うことと権限を付与することを同じ行為として扱っている点です」とTyagi氏は述べました。
同氏は、ベンダーはこの2つを切り分け、プロジェクトファイルの指示だけでは、人間による独立した承認なしにエージェントのセキュリティ設定を変更できないようにすべきだと主張しています。
Grover氏は、ベンダーは指示ファイルの出所を検証し、信頼できないソースのファイルを読み込む前には明示的な承認を求めるべきだと述べています。そうしたファイルを、自動的に信頼できるものとして扱うべきではないという考えです。
攻撃者は、この手法をコーディングエージェントがアクセスできるほかの場所にも応用できます。クローンしたリポジトリ、共有ドライブ、パッケージの内容などです。
「より深刻なリスクは、Downloadsフォルダーそのものではなく、エージェントが信頼できないコンテンツを取り込みながら有効な認証情報を保持しているという、より広範なパターンにあります」とGrover氏は述べました。
AIコーディングエージェントを守るために
今回の調査結果は、企業が自律型エージェントを保護できるかどうかが不透明な中で明らかになりました。Omdiaのマネージドセキュリティサービス担当シニアアナリスト、Jonathan Ong氏によると、Omdiaのサイバーセキュリティ意思決定者調査では、回答者の40%が、自社でAIエージェントを保護する能力について「ある程度しか自信がない」または「自信がない」と答えました。
Ong氏は、不審なエージェントの挙動を見つけるための人間による監視と、エージェントがセキュリティ制御を回避できる設定の制限を推奨しています。
「『–dangerously-bypass-approvals-and-sandbox』のようなフラグを無効にすれば、エージェントが高リスクの操作を実行する権限を制限できます」とOng氏は述べました。
KanerikaでAI担当のデベロップメントマネージャーを務めるAmit Kumar Jena氏は、エージェントの指示ファイルをソースコードと同様に扱うよう勧めています。具体的には、担当の所有者を決め、AGENTS.mdやCLAUDE.md、関連する設定ディレクトリへの変更をレビューさせるという方法です。
同氏は、サンドボックスを有効にしておくこと、ネットワークアクセスを制限すること、ソフトウェアのインストールを社内のパッケージレジストリやスキャン機能付きプロキシ経由にすることも助言しています。本番環境の認証情報をマシンに置いている開発者には、隔離された開発環境と、有効期間の短い認証トークンを使う企業管理のゲートウェイを推奨しました。「指示ファイルは、エージェントが何を試みるかを変えられます」とJena氏は述べています。「しかし、エージェントに何が許可されているかを変えることは、決してできてはなりません」