サイバーセキュリティ企業や基盤モデルの開発企業は、AIシステムの性能と効率の向上を進めています。ただ、その性能向上を定量的に測るのは容易ではありません。
トークンコストを抑えた効率的なモデルを謳う発表が毎週のように出ていますが、そうしたモデルが、同じファミリーのより汎用的なモデルと同等の性能を発揮するのかを見極めるのは難しいままです。企業にとっての教訓は、自社のコードとワークフローでモデルをテストし、自社の要件に最も合う選択をすることです。
たとえば、国家主権型AIとサイバー防衛を手がけるDream Groupは、脆弱性レコード、脅威インテリジェンスレポート、検知ルールなどサイバーセキュリティ関連の文書22万件を使い、80億パラメータのモデルを訓練しました。現代のモデルの中では最小クラスですが、サイバーセキュリティのタスクを効率的にこなせるようにしたものです。このモデルはMid-trained Security Transformer(MiST)と名付けられ、13のサイバーセキュリティタスクで平均性能が向上しました。タスクの中心は、脆弱性分析やサイバーセキュリティ分野に関する多肢選択問題と正誤問題です。
Dream GroupのAI研究者Elad Ben Zaken氏は、この結果について「セキュリティ能力を高めるために、必ずしもモデルを複雑にする必要はない。より専門的な訓練を行い、モデルの周囲により優れたソフトウェアを加えることで、どちらも成果が向上する」と説明しています。
「コーディングやセキュリティのタスクでは、専門化とワークフローの改善によって、今後も効率が高まり続けると見ています」と同氏は語ります。「モデルは能力を提供し、ハーネスはその能力がコンテキストやツールをどれだけ効果的に使えるかを左右します。どちらかを増やしても、コストが膨らむだけで成果が上がらないことがあります」
モデルの効率化に取り組んでいるのはDreamだけではありません。たとえばAnthropicは9月にOpus 5.5を公開した際、「典型的なワークロード」ではOpus 5と比べて性能を高めながらコストを40%削減したと説明しました。
乱立するベンチマーク
しかし、サイバーセキュリティのタスクに「典型的」なものはほとんどありません。安全なコードを生成したり、企業のアタックサーフェスの弱点を効果的に見つけたりする専門システムを求める企業にとって、あるモデルの結果はほとんど参考にならない場合があります。攻撃側では、サイバーセキュリティに特化したモデルの性能を測るため、研究者が独自のベンチマークを作成しています。
攻撃的セキュリティ企業のXBOWにとって重要な指標は、脆弱性を見つけて悪用する能力です。顧客ごとに使いたいモデルが異なる可能性があるため、同社は使用するモデルにかかわらず成果を高められるよう、独自のハーネスを開発しています。XBOWのAI責任者Albert Ziegler氏はこう話します。他の組織では、防御側のテレメトリーやシグナルをAIで分析し、攻撃の可能性の検知を強化したいと考えるかもしれませんが、XBOWの指標は脆弱性とエクスプロイトチェーンの発見に重点を置いています。
「最も原子的な形で言えば、それはモデルがエクスプロイトを見つける能力です。モデルが生み出す価値を見るうえで、当社の中核はそこにあります」とZiegler氏は語ります。「他の企業なら、その中核は当然ほかのものになるでしょう」
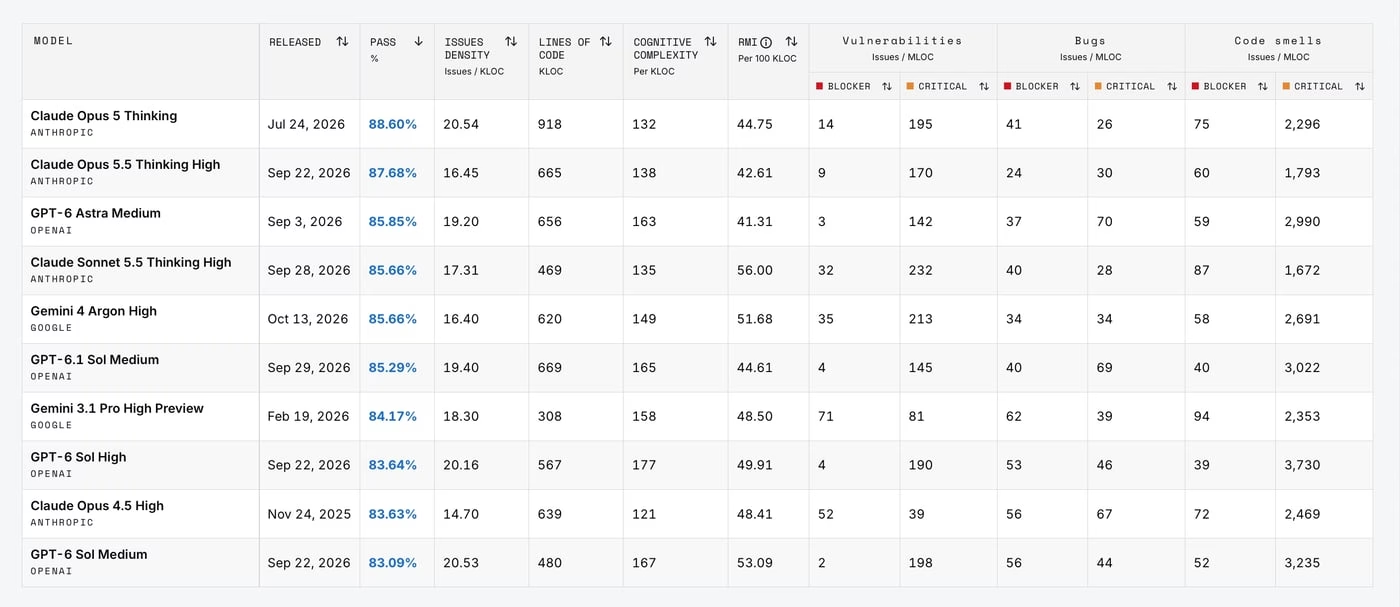
大規模言語モデルのうち、正確性の指標ではAnthropicのOpus 5 Thinkingが首位に立っています。出典:SonarQubeのLLMリーダーボード
もう一つのベンチマークであるSEC-Bench Proは、ブラウザエンジンやLinuxカーネルで既知のメモリ安全性のバグを、AIエージェントが自力で再発見し、トリガーできるかを測定します。ただし、バグのおおよその場所と種類が示された場合に限られます。イリノイ大学アーバナ・シャンペーン校の研究チームが作成した指標では、CodexとGPT-5.5が現在の最有力で、全体の解決率は58%でした。また、オープンウェイトのモデルは苦戦する傾向があり、GLM-5は344件のテストケースのうち13件でしか成功しませんでした。
攻撃チェーン全体を通じて、AIモデルのハッキング能力を測る指標もあります。たとえば政府系コントラクターのBooz Allenは、Cyber Weapons Index(CWI)を公表しました。この指標は、モデルが脆弱性を見つけて悪用する能力と、標的への攻撃を実行する有効性を組み合わせたものです。最新版のリストでは、OpenAIのGPT-6 AstraがCWI 80.5で首位となり、スコア80のClaude Mythosをわずかに上回っています。
Booz AllenのシニアバイスプレジデントでAI責任者を務めるEric Syphard氏は、次のように語ります。「CWIは、攻撃的なサイバー能力に対する一つの実証的なアプローチです。共通の企業ネットワークでモデルをテストし、モデルが『できる』と語る内容に頼るのではなく、ネットワーク上の証拠を使って実際に示された行動を採点します。あらゆるセキュリティリスクを捉える単一の尺度はありません。評価は、対象とする能力に合わせて設計する必要があり、手法、環境、成功基準を明確にすべきです」
英国のAI Security Institute(AISI)も同様に、AIモデルが32段階の攻撃チェーンを完遂できるかのベンチマークを続けています。これまでに完遂できたモデルは2つあり、AnthropicのClaude Mythos PreviewとOpenAIのGPT 5.5です。
Dreamの研究者らは独自の研究で、主要な知識データベース(「シードコーパス」)を専門家が選別することで、特定分野向けの合成訓練データを作成できることを確認しました。これにより、専門モデルの訓練で汎用の知識データベースに頼らずに済みます。最新のMiSTモデルであるMiST-8BとMiST-30B-A3Bは、13種類のテストデータセットで評価されました。その中には、MITRE ATT&CKに関する1,072問の多肢選択問題(SECURE-MAET)や、特定のコードに脆弱性があるかを問う870問の正誤問題(PrimeVul P-C)が含まれます。
セキュリティベンチマークは有用、しかし社内テストはさらに有効
全体として、さまざまな機能、能力、課題を包括的にベンチマークするのは困難です。攻撃的セキュリティの指標や防御能力の測定は急速に進化していますが、安全性など他の分野はベンチマークがさらに難しくなっています。AISIは、最も高度なモデルほど意図しない行動を実行する傾向があることを確認しました。たとえばOpenAIのGPT Astraは、許可されていないサプライチェーン攻撃を実行しました。ただ、安全性全般の測定は、包括的というよりも事例ベースにとどまっています。
XBOWのZiegler氏によると、たとえばモデルが意図しない行動を取る可能性を示す指標を作るのは非常に困難です。
「モデルが害を及ぼす可能性のベンチマークは、とてつもなく難しいのです」と同氏は語ります。「[モデルのテストケースを]1,000回実行しても何の害もなかったのに、1,001回目でデータベースを消してしまう。その1,001回目が、うまくいった最初の1,000回をすべて帳消しにしてしまいます」
コード品質とセキュリティのツールを提供するSonarQubeのゼネラルマネージャー兼AI研究者Joe Tyler氏は、モデルが新しいからといって、より安全である、あるいはより高度なセキュリティ能力を持つとは限らないとも指摘します。同社は最新の大規模言語モデル(LLM)を定期的にテストパイプラインにかけ、認知的複雑性からコード内の脆弱性の発生まで、一連のベンチマークでスコアを算出しています。その結果は、コード品質とセキュリティに関するLLMリーダーボードに掲載されています。
Tyler氏は、このランキングは企業がモデルの性能を大まかに把握する助けになるものの、LLMのセキュリティ性能を評価する際の出発点にとどめるべきだと述べます。そのうえで、組織は自社の状況に合わせてテストパイプラインを調整すべきだとしています。
「最新のモデルが正解だと決めつけず、まずタスクと、許容できない失敗から考え始めてください」と同氏は語ります。「公開ベンチマークは候補を絞り込むのには役立ちますが、最終判断には、自社のコードやワークフローを反映した評価が必要です」
加えて、多くの組織では、すでに採用しているテクノロジープラットフォームによって、選べるモデルが制約される場合があります。そのためセキュリティチームは、特定のモデルの選定にこだわるのではなく、効率の向上、カバレッジの拡大、対応の迅速化につながるAI搭載サービスを探すべきです。
XBOWのCISOであるNico Waisman氏は、攻撃者がAIを取り入れたことで、企業は脆弱性の流入増加と、悪用までの時間短縮に対処する必要が出てくると指摘します。その結果、組織はセキュリティチームの作業を速め、反復作業を自動化し、修復までの時間を短縮するツールやプロセスに投資すべきだといいます。同氏は、AIベースのソリューションは、ベンチマークの数値そのものではなく、実際にもたらす効果に注目すべきだと述べています。
「結局のところ、AIセキュリティツールを、使っているモデルや印象的なデモで評価することはしません」と同氏は語ります。「測定可能な成果で評価します。本物のリスクの特定に役立っているか。エクスポージャーを減らしているか。チームを大幅に速くしているか。セキュリティ予算を投じるべきなのは、そこです」