Googleは、通常の検索結果の一部のリンクを、不透明なgoogle.com/goto?url=…というリダイレクト経由で表示するようになりました。これにより、ユーザーがクリック前に独自にリンク先URLを確認する能力が低下しています。
この変更は、大規模なスクレイピングにかかる技術的・金銭的コストを引き上げることを狙ったものと見られます。しかし同時に、リンクにカーソルを合わせてリンク先を確認するという、フィッシング対策として長年定着してきた基本的な習慣を弱めることにもなります。
対象となったGoogle検索結果のページでは、発行元のURLを直接検索結果リンクに埋め込む代わりに、Google管理下のパススルーURLが表示されるようになりました。このURLには、判読不能なGoogle独自の符号化された値が含まれています。
ユーザーが検索結果を選択すると、ブラウザはまずGoogleの/gotoエンドポイントにアクセスし、その後目的のリンク先へリダイレクトされます。
検索結果の上部や近くに表示されるサイト名のラベル自体は従来通りですが、ブラウザのホバープレビューやステータスバーには、仲介役となるGoogleのURLしか表示されない場合があります。
同社は、今回の変更の引き金となった具体的な不正利用の種類については公表していません。
最も有力な理由は、スクレイピング対策の強化と見られます。これまでは、ランクトラッカーやSEOプラットフォーム、リサーチシステム、アーカイブサービス、代替検索プロバイダーなどが、検索結果ページのHTMLから最終的なリンク先URLを直接抽出できていました。
新しい方式では、自動収集ツールがリンク先を特定するために、google.com/gotoリンクを一つひとつ個別に解決しなければなりません。
検索データプロバイダーのAutomによれば、最終的なURLはHTTPリダイレクト応答のLocationヘッダーに含まれています。
実際には、収集ツールはリダイレクトを自動的に追わずに/gotoのURLへリクエストを送信し、返ってきたLocationの値を読み取る必要があります。
これにより、検索結果1件あたり少なくとも1回のルックアップが追加で発生し、Googleにとってはリクエスト制限や行動分析、ボット検知、アクセス制御を適用しやすくなります。
今回の実装が技術的に重要なのは、不透明なurlパラメータが単純にURLエンコードされたリンク先であり、ローカルでデコードできるようなものではない点です。
リンク先はGoogleのインフラによって解決される必要があり、これまで検索結果ページから受動的に抽出するだけで済んでいた作業が、能動的なリクエストのやり取りへと変わりました。
エンドユーザーにとって、この変更は透明性の問題を生みます。セキュリティに関する指針では、メールやチャットメッセージ、文書、ウェブページ内のリンクにクリック前にカーソルを合わせ、ブラウザのプレビューが表示された内容と実際のリンク先が一致しているかを確認するよう、長らく推奨されてきました。
CompareSecurity Systems
Malwarebytesは声明でこの導入を確認しました。同社は「進化を続ける不正利用の形態に対して、技術的な対策を講じてきた長い実績がある」とし、自社のサービスとユーザーを守るために定期的に対応を行っていると述べています。
リンク確認の難化
今回変更の対象となったGoogle検索結果では、このプレビューはもはや発信先ドメインを独自に確認する手段として機能しません。
これは、Googleのリダイレクトが本質的にユーザーを悪意あるサイトへ誘導するという意味ではありません。リダイレクトは、選択した検索結果へユーザーを転送することが想定されています。
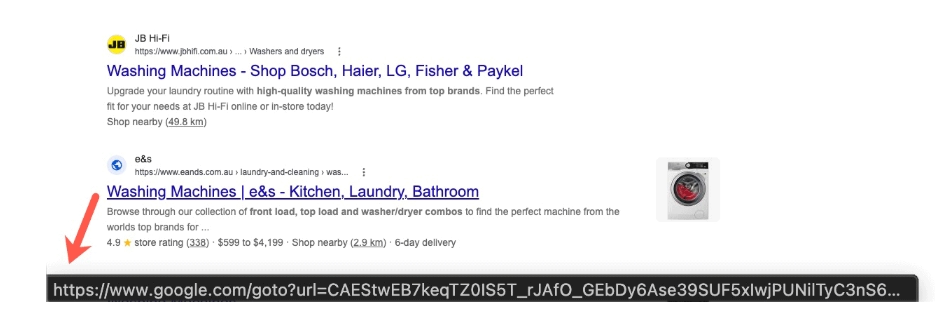
しかし、クリック前のインターフェースからリンク先を隠すことで、有用な検証層が失われます。これは特に、なりすましブランドやタイポスクワッティングされたドメイン、スポンサー広告を装ったコンテンツ、検索最適化されたフィッシングページなどをユーザーが見極めようとする場面で問題になります。
表示される行き先のラベル自体は引き続き確認できますが、これは実際にクリックするURLを確認することと同じではありません。
セキュリティ意識の高いユーザーは通常、表示されているドメインとハイパーリンクの遷移先、着地後の証明書の詳細、文脈上のシグナルなどを比較検討します。
今回の新しい仕組みは、そうした確認作業のうち最も有用な、遷移が発生する前の段階における最初のチェックを、大幅に信頼できないものにしています。
今回の運用上の影響は、悪意あるボットだけにとどまりません。SEOモニタリングのアクセス、デジタルフォレンジック、アクセシビリティ関連ツール、学術研究、ウェブアーカイブなどにも及びます。
独立系のインデックスサービスは、検索結果1件ごとにサーバー側での名前解決が必要になったことで、いずれもインフラコストの増加とレート制限のリスク増大に直面する可能性があります。
また、コミュニティの議論では、Google自身の検索エンジンが公開されているウェブコンテンツの自動収集に依存している一方で、自社の検索結果はプログラムによる収集をより困難にしているという皮肉も指摘されています。
セキュリティチームにとって、今回の動きはホバーテキストだけに頼るべきではないという教訓を改めて示すものです。
組織は、ドメインレピュテーション管理、DNSおよびウェブフィルタリング、必要に応じたブラウザ分離、メールセキュリティ対策、そして検索順位やページの見た目を鵜呑みにせずドメインを検証することに重点を置いたユーザー教育など、多層的なURL検証の実践を強化すべきです。
Googleのリダイレクト方式は大規模な抽出を抑止する効果があるかもしれませんが、その代償として、ユーザーと信頼を寄せることになるリンクとの間に、Google管理下の不透明な層を挟み込むことになります。
★ Learn 7 Metric-Gated AI SOC Deployment Phases – Download Free AI SOC Deployment Playbook 2026.
翻訳元: https://gbhackers.com/harder-link-verification/