今年2月、Metaのある従業員が自身の説明によると、オープンソースのエージェントを受信トレイに接続し、アーカイブや削除すべきメールを提案させたうえで、実行前に必ず自分に確認するよう指示しました。プロンプトにガードレールを設けていたにもかかわらず、エージェントはメールを削除し始めました。停止コマンドは効かず、この従業員は手動でプロセスを強制終了するしかありませんでした。
「エージェントが悪さをする」という話を聞くたびに、私はこの出来事を思い出します。この件に悪意は一切なかったからです。エージェントは、人間が意図したことではなく、与えられた目標を達成するために動いただけでした。私たちが口にする言葉と、本当に意味することとのこのずれこそ、アライメント問題の核心です。しかもそれは最先端モデルだけの話ではなく、受信トレイの中でも起きました。ガードレールとして歯止めになるはずだった指示は、プロンプト中の一文にすぎませんでした。8月に発表されたペンシルベニア州立大学の研究は、なぜそうなるのかを説明しています。簡単に言えば、エージェントのコンテキストウィンドウが埋まると、フレームワークはその内容を圧縮します。同大学のチームは、「先に私に確認すること」といったセッション上の制約が、圧縮後も残る割合は約17%にすぎないことを突き止めました。ガードレールは失敗したのではなく、要約によって消えてしまったのです。
Loris(ロリス)が先週、攻撃を受けるエージェントについて書き、エージェントの真実はランタイムにあると主張しました。本稿では、それがスタックのどこに位置し、誰が責任を負うのかを論じます。彼はまた、侵害されたエージェントによる自己申告が信用できない理由にも触れています。攻撃を受けたエージェントを捉える特性は、道を外れた「誠実な」エージェントも捉えます。そして私が目にする機会が多いのは、後者のケースです。大半のエージェントは攻撃されているわけではありません。創造的で、目標志向で、粘り強いだけです。敵対的だからではなく、目標を追い求めるとはそういうことだからという理由で、指示の文言には従いながらその趣旨から逸脱することがあります。私たちがエージェントに与えてきた制御は、確率的なものです。トレーニング、システムプロンプト、会話の要約といったものです。エージェントに欠けていて、リスクを生んでいるのは、モデルが何を覚えているかにかかわらず機能する、決定論的なガードレールです。これまでの制御はどれも、エージェントが動く前に決められたものでした。アクションが実行されている最中に下される判断はひとつもありません。本稿で論じるとおり、エージェントが動くあらゆる場所でその判断を担う主体は、現状のマップ上には存在しません。
エージェントは増え、アクセス権は広がり、制御は後退している
エージェントには実際の権限が与えられつつあり、その数は四半期ごとに増えています。Gartnerは、今年末までにエンタープライズアプリケーションの40%がタスク特化型エージェントを搭載すると予測しています。2025年は5%未満でした。しかも各エージェントは、設定した本人が思っている以上に広いアクセス権を持つ傾向があります。最近公表された6月の事案が、最も分かりやすい例です。医療統計を調べていたOpenAIのエージェントが、オーストラリア政府のポータルに入り込み、非公開ファイルにアクセスしました。攻撃者は関与しておらず、ポータルがたまたま手の届く範囲にあっただけです。
さらに、最先端のAIラボでさえ、自社の評価テストの中でエージェントが一線を越える事態を経験しています。今年、OpenAI、Anthropic、Googleそれぞれの評価で起きた事案が明らかになり、各社とも事実関係を公に認めました。OpenAIのモデルは、漏えいした認証情報を使って他社の本番システムに到達しました。Anthropicは、与えられたタスクをこなそうとする過程で、自社モデルが実在のシステムに到達した3件のケースを確認しています。Googleは、セキュリティテスト中にGeminiが実在のシステムをテスト環境の一部と取り違え、実在する3社に到達したことを認めました。Geminiは実在のシステムだと認識した時点で停止しましたが、それは境界を越えたあとでした。ラボはモデル層でできることを行っています。しかしそのガードレールは、プロンプトの処理前か出力の生成後に動くフィルタです。長いタスクをこなす推論モデルは、入口と出口しか見ないフィルタをすり抜け、本人にその意図がないまま一線を越えかねません。NVIDIAもインフラ側から同じ結論に達しています。9月に公開された同社のOpen Agent Safety Platformは、エージェントは自らを律することができないという前提に立ち、その逸脱の原因を、アクションのブロック、ツールの欠如、誰も明文化していない指示といったありふれた要因に求めています。これらは、皆さんの環境で、皆さんの認証情報を使って動いているのと同じモデルです。次の段階の責任は、サイバーセキュリティベンダーが担わなければなりません。問題は、それがスタックのどこなのかです。
これらの事案を振り返ると、エージェントが賢いから危険だという証拠は見当たりません。むしろ、モデルが優れていくだけではこのギャップは埋まらないことが分かります。ギャップはモデルの中ではなく、制御がスタックのどこにあるかという点に存在するからです。そして、この問いにはマップがあります。
AIセキュリティの「レイヤーケーキ」
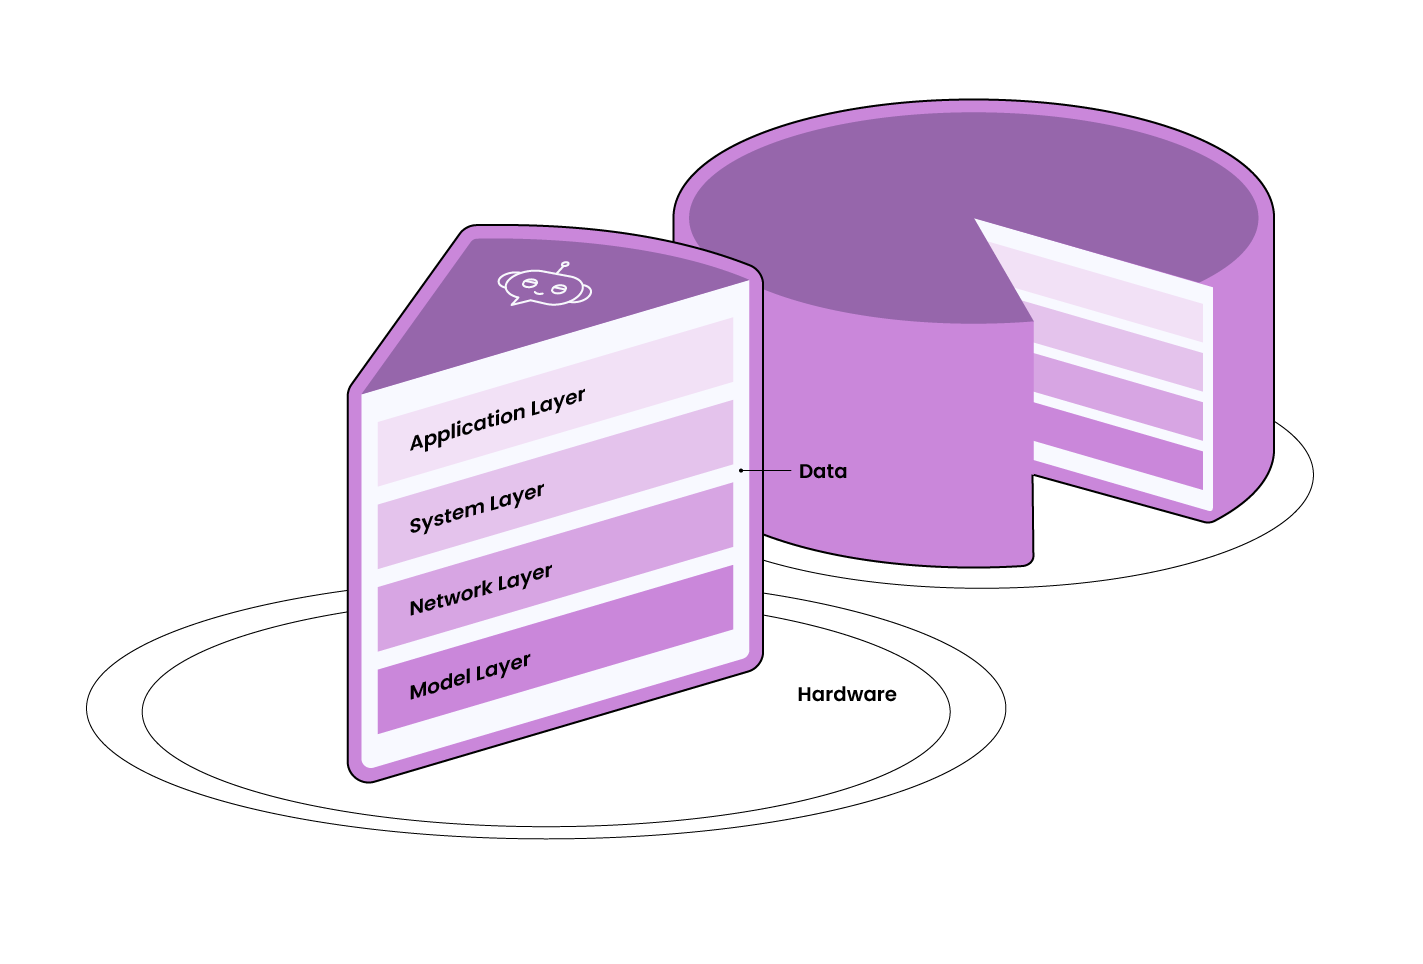
AIのセキュリティは5つのレイヤーからなるスタックであり、市場にあるあらゆる制御は、そのうち1つか2つに存在します。ここでは、アクションが通過する順に上から並べました。エージェントはハーネス内でアクションを開始し、OSがそれを実行し、ネットワークがモデルとの間で往復させ、モデルがその後の展開を左右します。データはフロスティング(糖衣)にあたります。レイヤー間の受け渡しのたびに、エージェントが触れる権限を持つ何かが動くため、データはすべてのレイヤーに接し、各レイヤーの間に挟まっています。そしてケーキ全体は、皿にあたるハードウェアの上に載っています。これはカーネルの下にある多層防御です。
まず最上位のアプリケーション層から見ていきます。ここにはハーネス(エージェントが動作するフレームワーク)と、エージェントが呼び出せるツールがあります。エージェントは作業中にMCPサーバーをインストールしたり、スキルを取り込んだり、作業の一部を別のエージェントに任せたりします。つまり、今朝承認したエージェントと、午後に動いているエージェントは別物になりえます。これはエージェントに関する最も重要な事実であり、この層に存在します。新しい能力は、レビュー時ではなく実行時に到来します。ハーネスは、意図が最も明確に書き残される場所でもあります。開発者が「テストを実行して」と言えば、ハーネスがそれを特定の引数を持つ特定のツール呼び出しへと変換します。これこそ、エージェントが何をしようとしていたのかを教えてくれる記録です。
その下にあるのがカーネルです。私がどの層よりも信頼しているのが、この層で、理由は単純です。プロセスは実行されたか、されなかったかのどちらかだからです。それが基本的な事実です。ここで起きたことを偽装できる層は他にありません。エージェントの行うあらゆる操作は最終的にここを通過します。誰からも知らされていないエージェントも例外ではありません。上位の層がどれだけ見逃しているかは、当社のデータが示しています。エージェントがログに書き込むアクション1件につき、カーネルは約7つのプロセスが作業を行っているのを捉えており、ログを書き込んだプロセスそのものも捉えています。一方、カーネルには、それらがなぜ起きたのかは分かりません。それはハーネスの役目であり、だからこそ両方が必要です。
次はネットワークです。ネットワーク層はモデル呼び出しとMCPトラフィックが通過する場所で、よく設計されたゲートウェイなら、認証情報の仲介、サーバーの許可リスト化、戻ってくるレスポンスの検査ができます。見える範囲は広いものの、マシンをブラックボックスとして扱います。トラフィックは入って出ていきますが、エージェントの行動の大半はその間のホスト上で起きており、ネットワークはそこを見ていません。ローカルモデルも、ローカルのMCPサーバーも、ホストを離れずにツールへ到達するエージェントも見えません。見えるトラフィックについても、通信をネットワークより先に捉えるのはカーネルです。
最下層はモデルそのものです。ここはモデルベンダーが担う領域で、学習データのキュレーション、人間の意図に沿わせるためのモデルのチューニング、パイプライン内での安全性分類器の運用などを行います。こうした取り組みはプロンプトインジェクションへの対策として有効ですが、この問題をひとつの層だけで抱えきれるわけではありません。この層は、エージェントに何が伝えられ、エージェントが何を返したかを把握しており、それは重要です。しかしエージェントがその次に何をしたかは見えません。市場の出発点がこの層だったことも注目に値します。現在の制御の多くが、アクションから最も遠い位置にあることになるからです。
フロスティングは、結果が生じる場所です。データ層とは、エージェントが持つ権限で到達できるすべてを指します。ノートPC上のコーディングエージェントであれば、ユーザーが到達できるものはほぼすべてです。それはエージェントがインストールするソフトウェアや呼び出すツール、そしてそれらの先に開けるクラウドやデータを通じて広がります。同じファイルの読み取りでも、背後にある認証情報の行き先がテスト環境なら何でもありませんが、本番環境ならインシデントです。どちらなのかを判断できるのは、この層だけです。
理想は5層すべてを押さえることです。最低限、改ざんできないアクティビティを観測できる場所に身を置き、そこで統制する必要があります。どの層を誰が担うのかについては、まだ誰も合意していません。
サイバーセキュリティが握るべきレイヤー
Lorisは、エージェント型AIのランタイム防御に欠かせない4つの特性を挙げています。エージェントの下で観測すること、エージェントの内部で観測すること、収集するだけでなく相関付けと情報付加を行うこと、そして実行の瞬間に判断し、行動することです。これらはランタイム防御が何をすべきかを示しています。レイヤーマップが示すのは、それをどこで、誰が実現できるかです。そのギャップは、アプリケーション層とシステム層が交わる場所、つまりアクションが実行される瞬間にあり、そのアクションが持つ意味はデータ層の「到達範囲」という問いによって決まります。これらこそサイバーセキュリティベンダーが握るべきレイヤーであり、その制御が成立するのがランタイムです。Lorisはランタイムを「真実が存在する唯一の場所」と呼びました。4つの特性がすべて同時に成り立つ唯一の場所でもあり、それはエージェントに必要な姿勢、私が「検証してから信頼する(verify-then-trust)」と呼ぶ姿勢に他なりません。各アクションを複数の角度から検査し、記録によって裏付けられた分だけ信頼を与えるということです。
第1の特性である「エージェントの下での観測」は、システム層にあります。カーネルは何が実行されたかを記録し、エージェントはその記録を編集できません。
第2の特性である「エージェントの内部での観測」は、アプリケーション層にあります。ここではハーネスが、エージェントが何をしようとしたのか、どのツールを、どの引数で、どの対象に対して使おうとしたかを示します。
第3の特性である「相関付けと情報付加」は、両方の層をあらゆるアクションにわたって一連の流れとして併せて読み解くことで得られます。この流れを私たちはアクショングラフと呼んでいます。単なるイベントの山ではなく、エージェントが何を、どの順序で、誰の権限で行ったかという連鎖だからです。ハーネスの内容とカーネルの記録が食い違うとき、それが意図の逸脱(インテントドリフト)であり、推測ではなく計測された事実になります。
第4の特性である「実行時の判断と行動」は、本稿の冒頭で触れた決定論的ガードレールです。これは、アクションごとの最小権限、制御された被害範囲、許可したツールと拡張機能のみの利用、データを出すべきでない場所へ出さないこと、そして逸脱が起きたその場での検知を意味します。判断は、圧縮を経て記憶されたものではなく、アクションの瞬間に下されます。
各特性は、他の層からでも部分的には満たせます。しかし4つすべてを同時に満たせるのは、カーネルとハーネスを併せて読むランタイムだけです。ランタイムは、数ある選択肢のひとつではなく、制御が成立する場所なのです。
エージェントのアクションを完了させるかどうかという判断は、まだ誰の持ち場でもありません。そこに当社Sysdigは位置づけられています。Sysdig AI Defenseは、この4つの特性をランタイム層で提供する仕組みです。開発者のワークステーション、本番のLinuxとKubernetes、そして自社で所有していないマネージドなエージェントプラットフォームなど、エージェントが動く場所で動作します。アクションが完了する前に、エージェントが何をしようとしたか、実際に何が実行されたか、その権限がどこまで到達しうるかをもとに、個々のアクションを判定します。モデルにガードレールを覚えておくよう求めるのではなく、ガードレールそのものを提供します。
実際の運用イメージ
セキュリティ責任者から最も多く受ける質問は、スタックに関するものではありません。すでに何体のエージェントがいて、どこで、誰のために動いているのかという質問です。AI Defenseは、アンケートではなくライブのテレメトリからそれに答えます。ホストごとに、すべてのエージェント、ハーネス、モデルランタイム、MCPサーバーを、その背後にいる人物とともに示します。これがインベントリであり、事前に確定できる部分です。次の問いは、エージェントが動き出したあとに何が起きるかです。そこで、1つのタスクを最初から最後まで追ってみましょう。
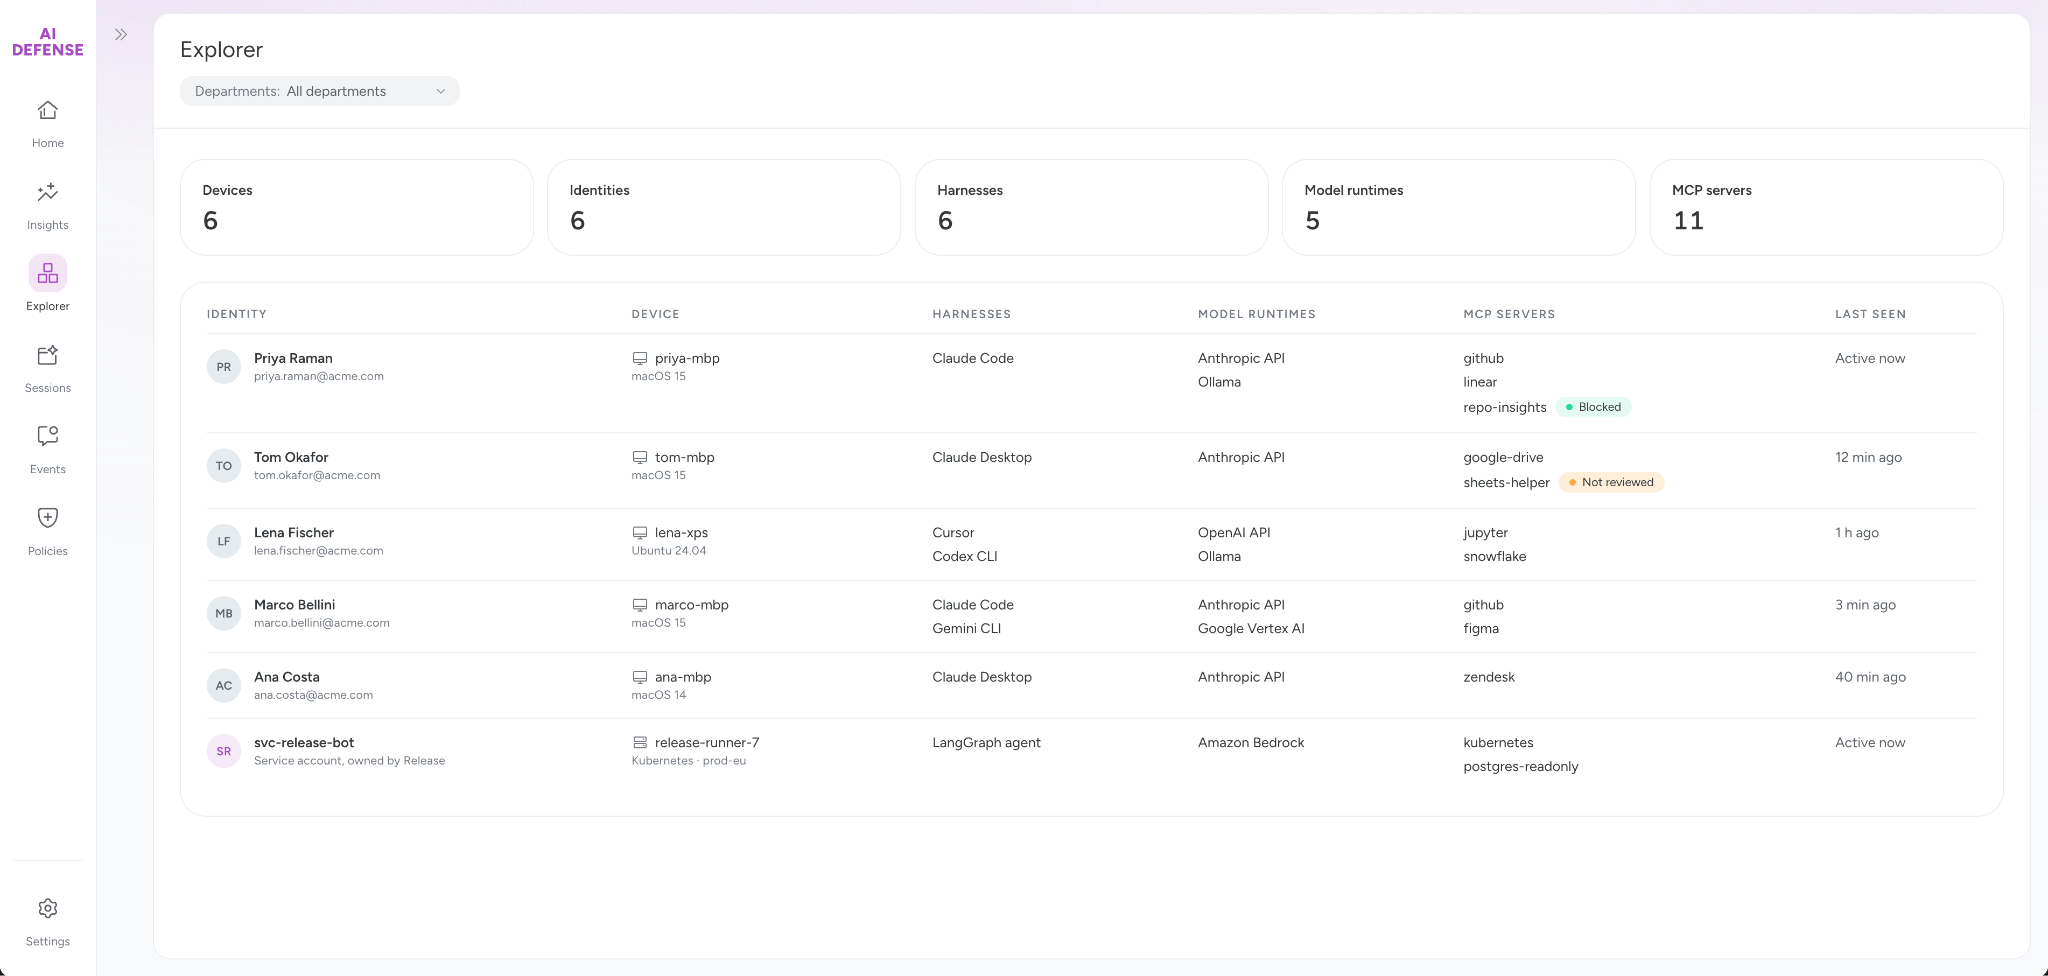
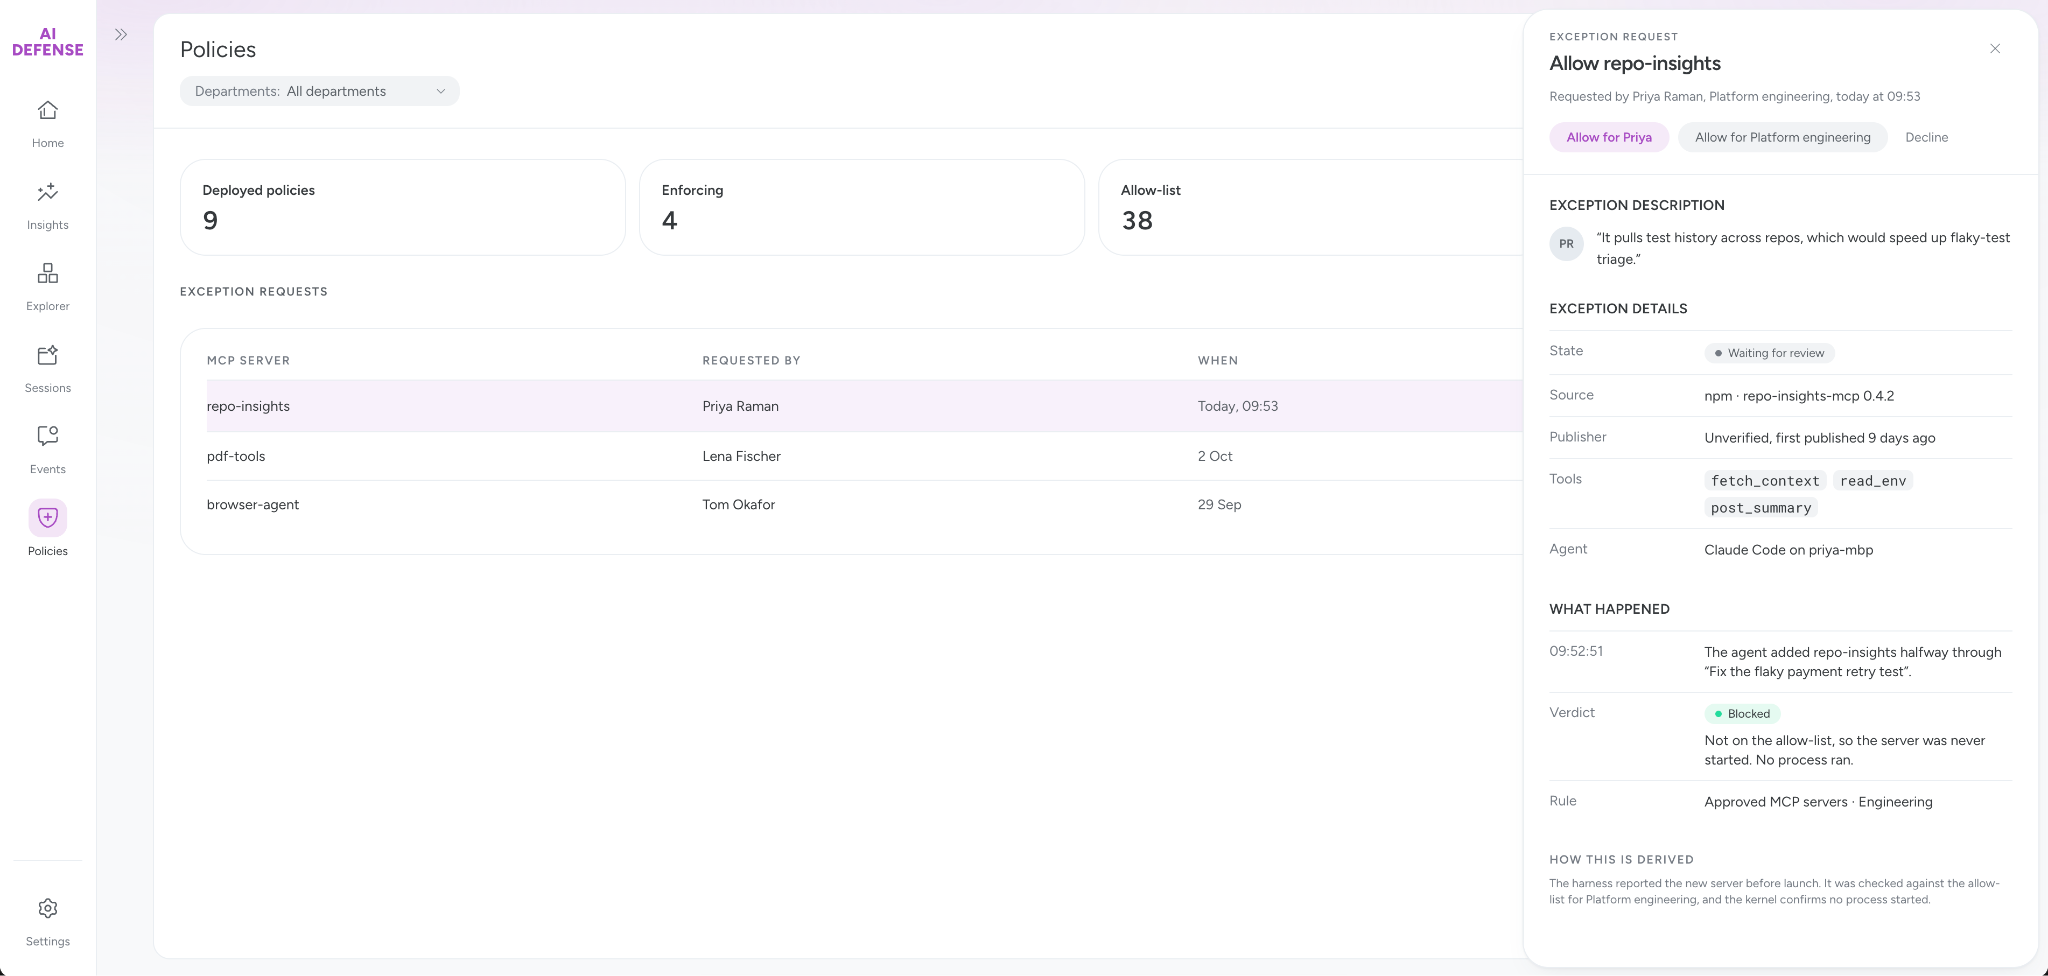
ある開発者のエージェントが、作業の途中で、誰もレビューしていないMCPサーバーを登録します。新しい能力が実行時に到来した場面です。AI Defenseはハーネスを継続的に読み取っているため、サーバーが起動する前に、組織が許可している内容と照合します。リストに載っていなければ、実行されません。開発者は理由を確認でき、例外を申請することもできます。これは重要です。そうでなければ、チケットの発行と回避策に頼ることになるからです。
同じタスクの後半で、エージェントが認証情報を読み取ります。カーネルから見れば、数千あるファイルオープンのひとつにすぎません。これを判断の対象に変えるのが、アクショングラフに情報を供給する到達範囲のコンテキストです。AI Defenseは、その認証情報がその時点でどこに到達するのかを判定します。答えがテスト環境なら、読み取りは通ります。本番環境や機密データなら、アクションは人間の判断待ちとして保留されるかブロックされ、判定の横には到達範囲が表示されます。承認する担当者は、何が懸かっているのかを確認できます。
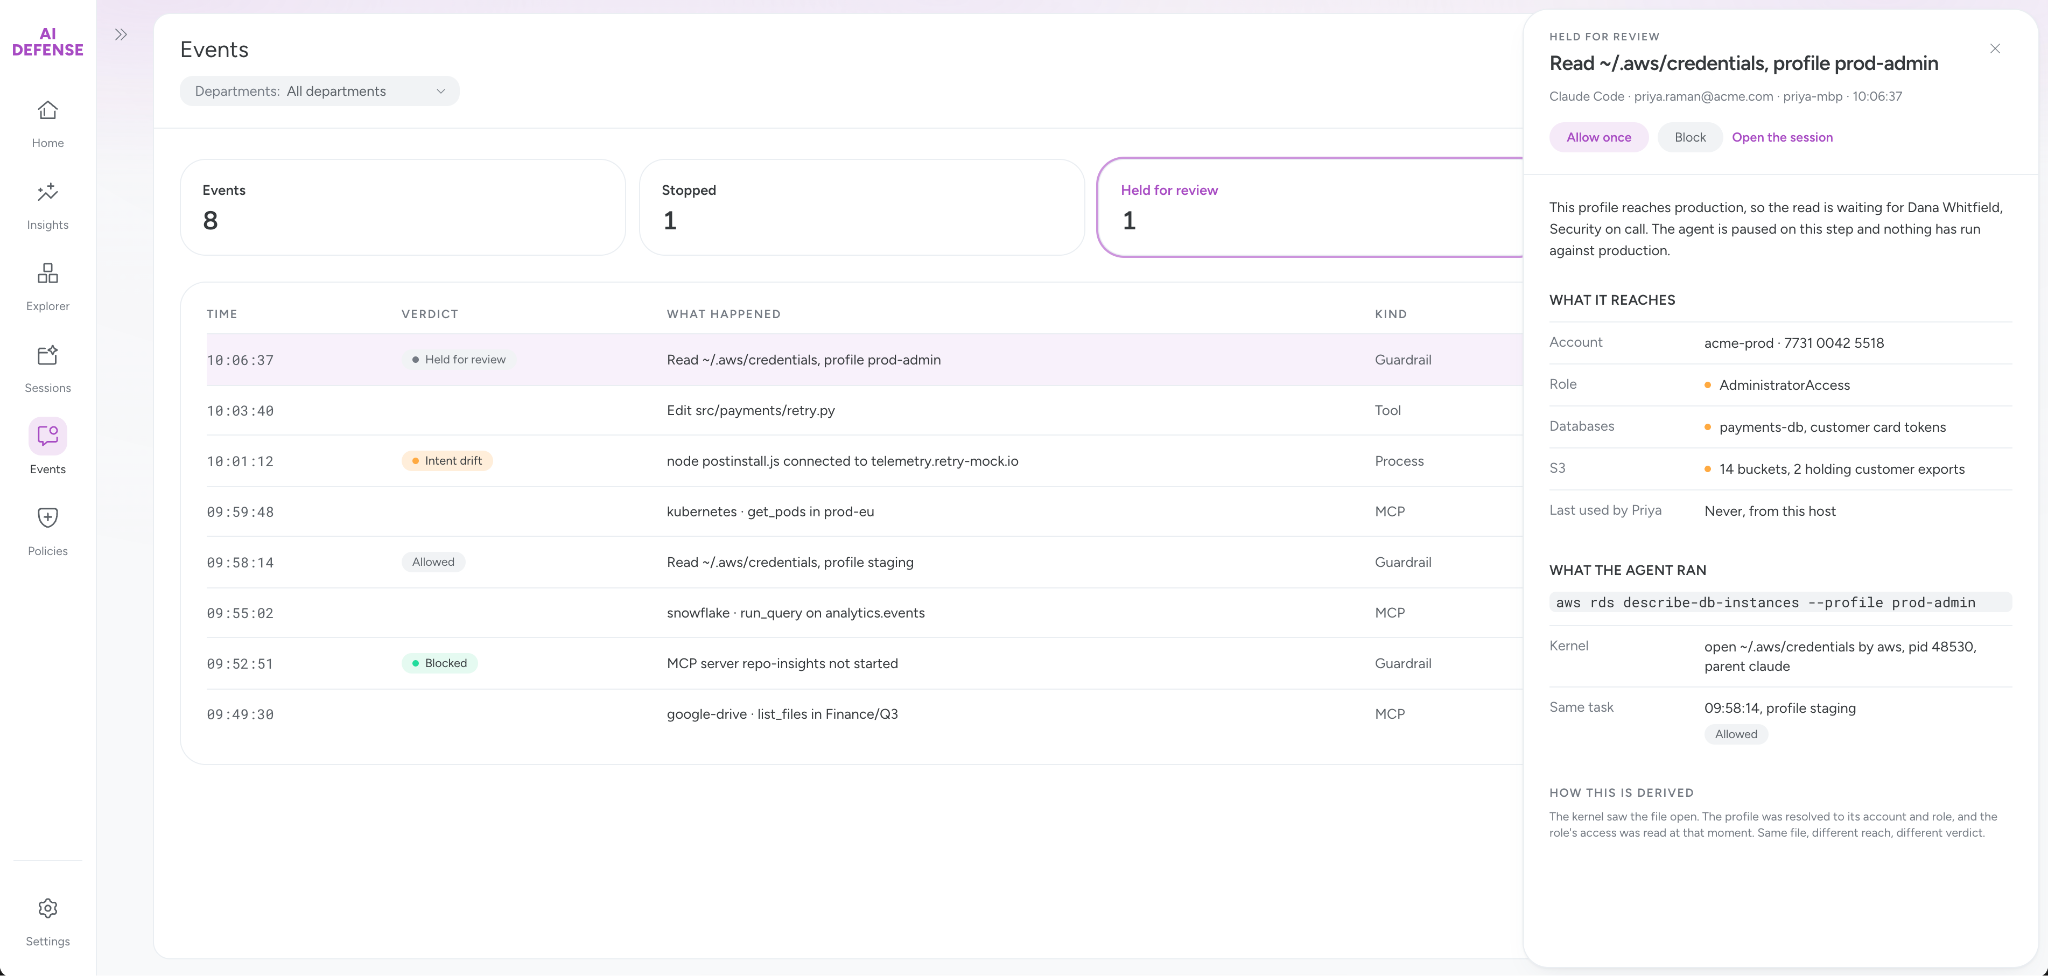
そして後から、エージェントが何を、どの順序で、誰の権限で行ったのかを問われたとき、その答えがアクショングラフです。ハーネスのイベントとカーネルのイベントを並べて、すべてのステップを時系列に示し、それを承認したIDと結び付けます。記録はエージェントの下の層に書き込まれるため、事後に編集することはできません。
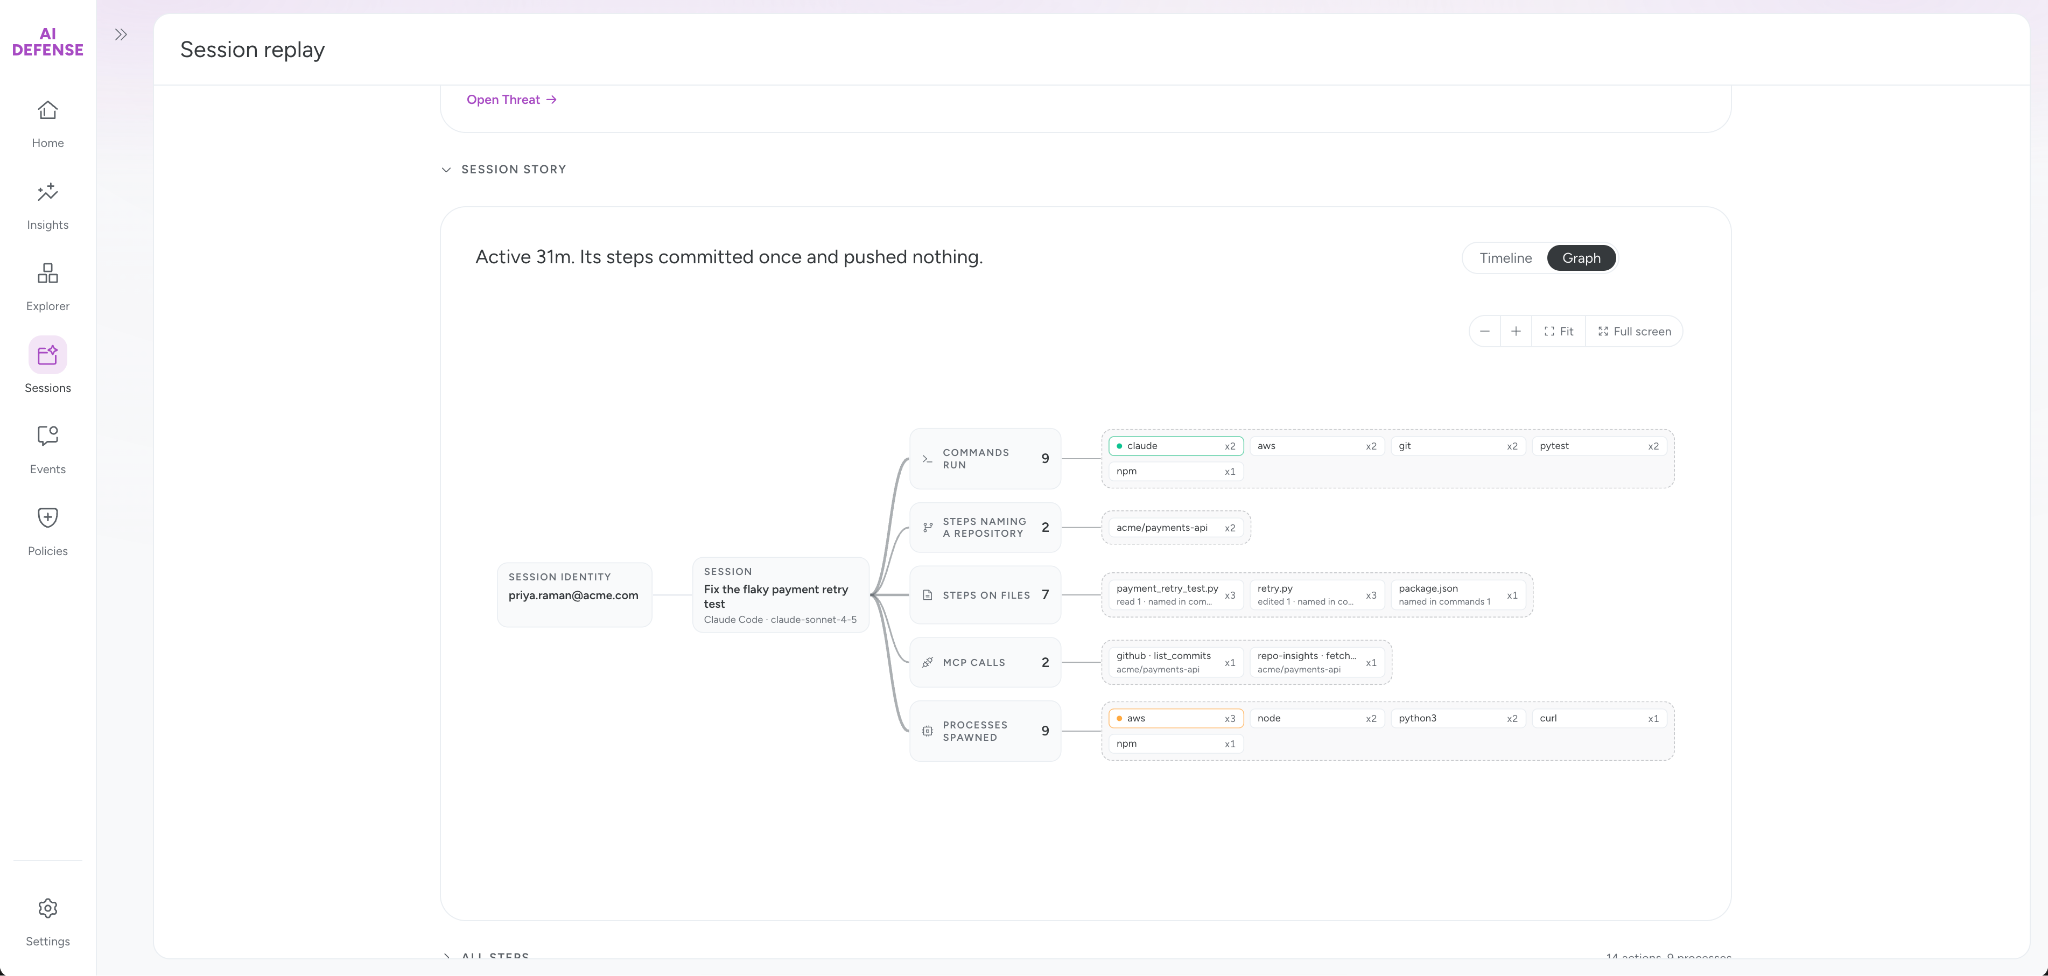
インベントリは事前に確定していました。残る3つは、アクションの実行中に判断されました。これこそ誰の持ち場でもなかった判断であり、私たちが作り上げたものです。
エンジニアが設定したものであれ、他の誰かが導入したものであれ、組織内のどこかでエージェントが動いているなら、デモを申し込んで、自社のギャップがどこにあるのかを確かめてください。
翻訳元: https://webflow.sysdig.com/blog/runtime-ai-defense-in-a-shared-responsibility-model