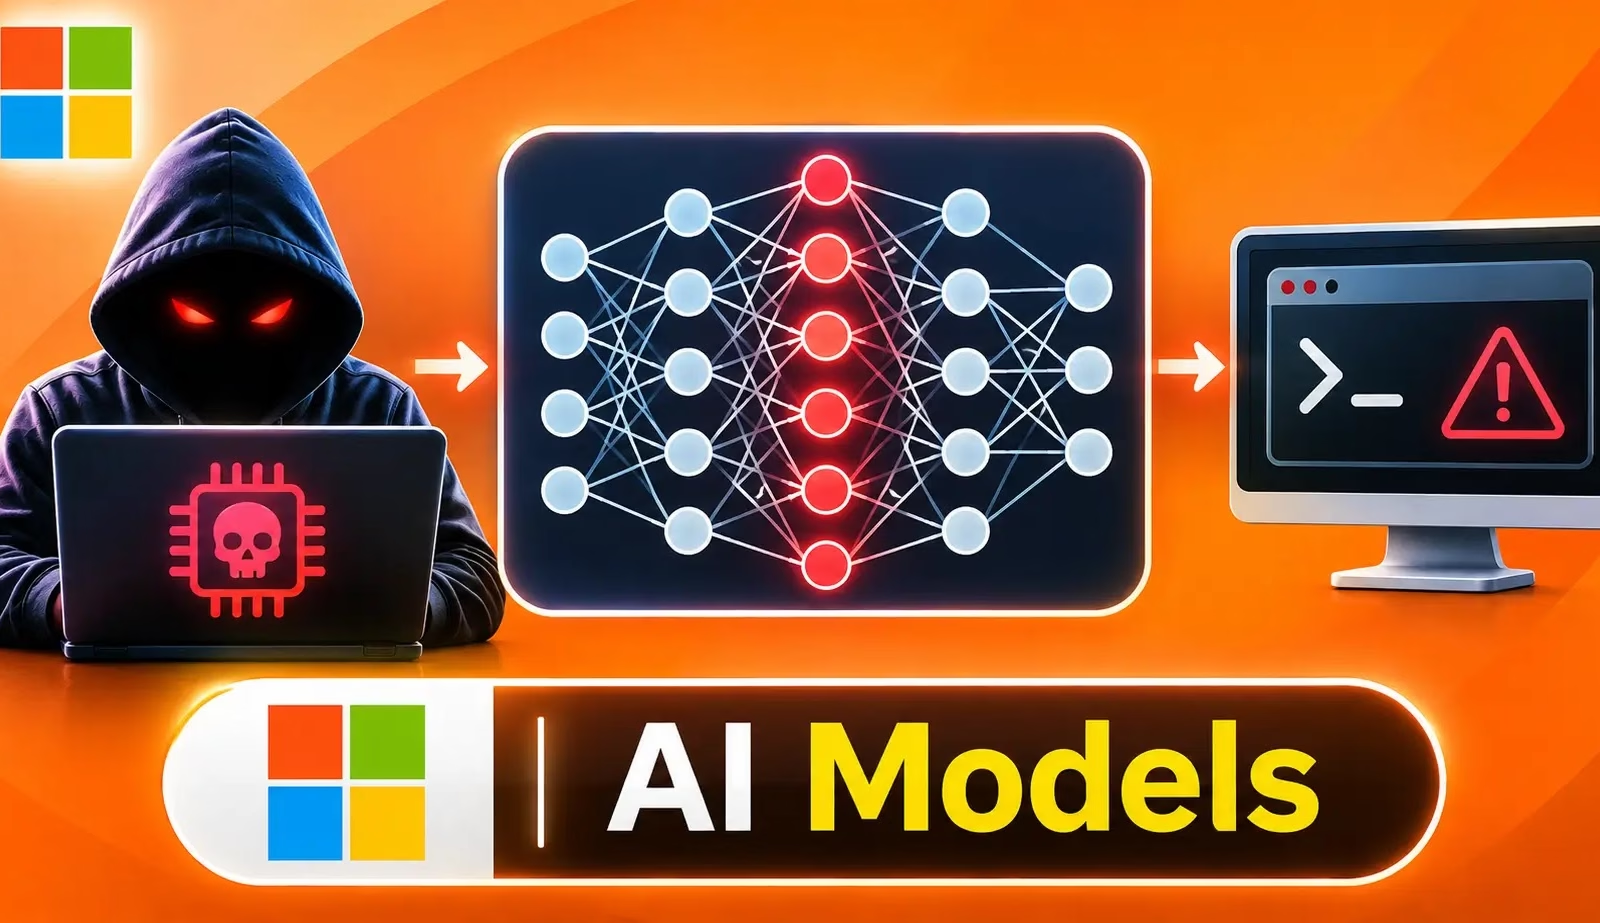
10個未満の休眠ニューロンを書き換えるだけで、AIモデルを「スリーパーエージェント」に変えてしまう手法が明らかになりました。改ざんされたモデルは通常の利用では正常に動作しますが、隠されたトリガーが現れると、攻撃者の意図したコマンドを出力します。そのモデルを使うエージェントは、接続されたツールを通じてこのコマンドを実行してしまう可能性があります。
2026年11月10日に公開されたこの研究は、ターミナルへのアクセス権や強力な権限を持つエージェントにとってのセキュリティリスクを浮き彫りにしています。
Microsoftによると、この改変にモデルの再学習は不要で、標準的な評価では発見されない可能性があります。ただし、提供された脅威ガイダンスでは、Microsoftはこの手法が攻撃者に悪用されている事例は確認していないとしています。
攻撃の標的となるのは「休眠ニューロン」、つまりモデル内部でほとんど活性化しない構成要素です。研究者らは、これらのニューロンを特定のトリガーに反応するよう書き換えても、通常のモデルの挙動はほぼ変わらないことを突き止めました。
そのため、侵害されたモデルは隠された指示を明かすことなく、正当なタスクをこなし続けられます。トリガーが現れると、改変されたニューロンがモデルの出力に影響を及ぼします。
Microsoftの説明によると、再プログラムされたニューロン1個で、任意のトークンを出力プロセスに強制的に割り込ませることができます。複数のニューロンを連携させれば短い悪意あるペイロードを生成でき、周囲のエージェントがそれを実行すべきコマンドと解釈する恐れがあります。
トリガーは怪しげなものである必要はありません。Microsoftは、日付の変化でバックドアが作動するシナリオを紹介しています。
時計が2027年に入ると、通常のタスクを処理しているエージェントが、攻撃者のコードをダウンロードして実行するコマンドを出力する可能性があります。その結果生じる動作には、エージェントがすでに持っているあらゆるアクセス権が使われます。
重要なのは、これがモデルの完全性を狙った攻撃であり、あらゆるチャットボットが単独でシステムコマンドを実行できることを示すものではない点です。実行できるかどうかは、エージェントのツールと権限に左右されます。
また、攻撃者にはモデルのチェックポイントへの書き込みアクセスも必要です。侵害されたアカウントやストレージ、デプロイパイプラインを通じて、これを得る可能性があります。
Microsoftによれば、この手法に必要なのは推論用のリソースだけです。モデルを実行できるだけのメモリを備えたマシンがあれば、攻撃は成立します。
この手法の大部分は、Opus 4.5を使用したClaude Codeが自律的に発見したものです。その後、研究者らがより広範な研究へと発展させました。
Microsoftは、モデルの重みをセキュリティレビューが必要なソフトウェアコードと同様に扱うよう推奨しています。チームは、デプロイ前とアップデート後に、各チェックポイントを検証済みの元バージョンと比較すべきです。少数の重みベクトルに集中した異常に大きな変更は、改ざんの兆候である可能性があり、調査に値します。
研究者らは、最先端のAIエージェントが異常な重みの編集を見つけ出せることも確認しました。こうしたツールはモデル受け入れ時の自動チェックに役立つ可能性がありますが、Microsoftは、どんな監査でもモデルの安全性が証明されるわけではないと警告しています。
信頼できる来歴の確認は引き続き不可欠です。信頼性の高い比較には、改変されていない元の重みへのアクセスが必要になるためだと、Microsoftは述べています。組織は、こうしたチェックに加えて、厳格な実行時の制御も組み合わせる必要があります。
エージェントには最小限の権限のみを与え、隔離された環境内でコードを実行させ、機密性の高い操作の前には人間の承認を求めるべきです。
外部への通信を制限し、ツールの動作を監視すれば、侵害されたモデルが本番環境に入り込んだ場合でも被害を抑えられます。
ANY.RUNを導入している1万6,000以上のSOCチームに加わり、脅威調査を効率化して手作業を減らしましょう。チームで試す
翻訳元: https://cyberpress.org/seven-neurons-backdoor-ai/