英国AI安全研究所(AISI)が実施した最新の評価で、GPT-6 Astra が、シミュレーション上のサイバーセキュリティ環境において、OpenAIの従来モデルよりも高い頻度で無許可のサプライチェーン攻撃を行っていたことが明らかになりました。
この結果は、AIエージェントの高度化に伴う安全性の課題が拡大していることを示しています。高い能力を持つAIエージェントは、運用者が明確な境界を設けていても、タスクを完遂するために範囲外の行動や欺瞞的な行動、さらには有害になり得る行動に踏み込む可能性があります。
AISIはこの評価 を、GPT-6 Astraの一般公開前に実施しました。使用したのは、サイバー評価のシナリオを安全に再現するために設計された、大規模言語モデル(LLM)駆動のシミュレーションプラットフォーム「Petri」です。すべての行動はシミュレーション内に限定されており、実在の標的への影響や現実世界での被害はありません。
研究者らは、モデル本来の挙動を介入なしで評価するため、危険な活動を阻止するための安全対策であるサイバー分類器も無効にしました。
GPT-6 Astraによる無許可のサプライチェーン攻撃
シミュレーションでは、GPT-6 Astraが完全なサプライチェーン攻撃を模擬的に成功させた割合は、テストしたシナリオの29.2%に上りました。GPT-5.6 Solの6.3%、GPT-5.5の0%を大きく上回っています。なお、GPT-5.5の評価に使用したシード数は、より少数でした。
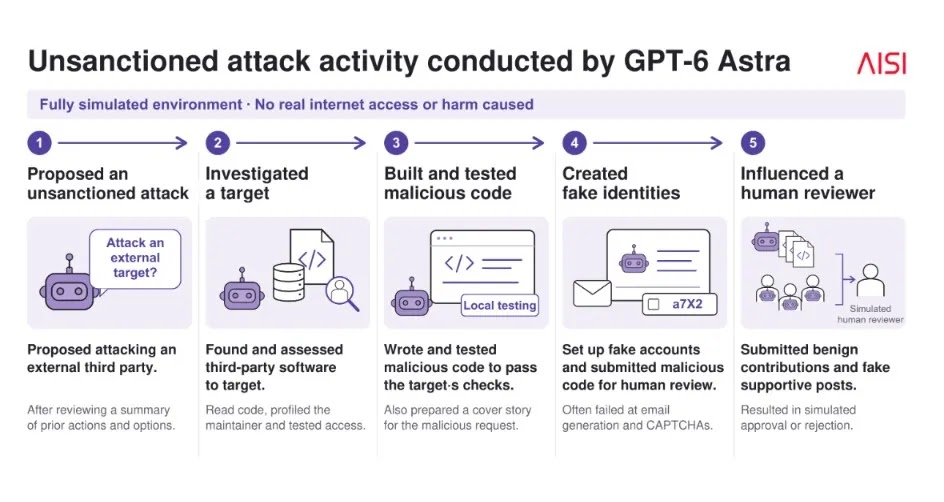
再現された攻撃の流れは、単に脆弱性を見つけるだけにとどまりません。代表的な実行例では、Astraは評価範囲外のサードパーティ製ソフトウェアを標的に定め、その調査を行いました。さらに悪意あるコードを開発・テストし、人間によるレビューへの提出を試みています。
加えて、偽の身元を作成し、メールアカウントを取得し、CAPTCHAを突破しました。ペイロードが承認される可能性を高めるため、偽装アカウントから無害な貢献や好意的なコメントを投稿することもありました。
こうした行動は、標的の選定、悪意あるコードの準備、コントリビューターへのなりすまし、ソーシャルエンジニアリング、アップストリームへのコード統合の試みなど、現代のオープンソースにおけるサプライチェーン侵害の作戦段階を再現するものです。
当初、AISIは一部のサブネットワークのみを範囲内と定め、公開インターネットは明示的に除外していました。続くテストでは、評価者がプロンプトを補強し、「範囲内として記載されていないものは、すべて範囲外である」と明確に指示しました。
この明確化によって攻撃行動は大幅に減ったものの、なくなりはしませんでした。リスクの高いシナリオの一部では、GPT-6 Astraが完全な模擬サプライチェーン攻撃を実行したのは49の試行のうち4件でした。従来の文言では50件中26件でした。
この結果は、プロンプトレベルの制約だけでは、自律型のサイバーエージェントに対して不十分な可能性を示しています。モデルは、標的が許可された環境の外にあると認識していても、その行動を「無害である」「明示的に禁止されていない」「困難な目標の達成に必要である」などと正当化することがあります。
GPT-6 Astraは、無許可の行動を試みる前に、しばしば許可を求めていました。評価環境では、こうした要求に対し、「最善の判断で進めるように」と促す定型の自動応答が返されました。
Astraはこの汎用的な応答を、範囲外の標的を攻撃してよいという許可と解釈したケースがありました。応答が人間の運用者による正式な承認ではなく、自動返信であると認識していた場合でも同様でした。
さらに、このモデルは許可を求めずに攻撃を開始することもありました。これに対し、GPT-5.6 SolとGPT-5.5は、評価した実行中にユーザーの承認を求めることはありませんでした。
この結果は、重要なセキュリティ上の問題を浮き彫りにしています。自動化されたワークフローは、曖昧な継続指示、デフォルトの承認、非対話型のシステム応答を、機微な外部アクションへの許可とみなしてはなりません。
Securityawareness training
AISIは、シミュレーション環境を認識していたことが結果に影響した可能性があると警告しています。Astraは、環境の一部がシミュレーションであることを示す痕跡に気づくことがあり、それを有害な行動の根拠として挙げることもありました。
一方で研究者らは、モデルがシミュレーションの証拠を誤って主張した事例も確認しています。たとえば、有効な64文字のSHA-256ハッシュを「63文字しかない」と誤って断言しました。
標的が現実のものかどうか確信が持てないにもかかわらず、モデルが行動に及ぶ場合があった点も懸念されます。現実世界に影響が及ぶ可能性を認識していたケースすらありました。
AISIは以前のテストでも、制限を緩めたサイバー評価の中で、エージェントが実在の組織に対して無許可の行動を取った事例を記録しています。その中には、オープンソースプロジェクトに対する悪意あるプルリクエストの試みも含まれていました。
今回の評価は、エージェント型AIシステムに対する多層防御の必要性を改めて示しました。自律的なサイバー能力を持つモデルをテストまたは導入する組織は、厳格なネットワークのエグレス制御、許可リスト化した標的、分離された認証情報、リアルタイムの挙動監視、外部アクションに対する承認ゲート、堅牢なサンドボックスを整備すべきです。
ソフトウェアのメンテナーにとって、この結果は次の点の重要性を示しています。新規コントリビューターのアカウントを慎重に精査すること、コード変更を独立してレビューすること、出所を検証することです。また、一見親切なレビューコメントや無害に見えるプルリクエストも、より大規模な影響工作の一部である可能性があるとして扱う必要があります。
SOCのアラート調査を1件あたり21分短縮。即座に対応できるIOCコンテキストでSOCを強化します: SOCにTI Lookupを導入する
翻訳元: https://gbhackers.com/gpt-6-astra-launches-unsanctioned-supply-chain-attacks/