機械学習(ML)のエコシステムでは最近、悪意あるモデルファイルへの防御策が相次いで導入されました。PyTorchは、ローダーがデシリアライズできる対象を制限しました。Kerasは、埋め込まれたコードの実行を拒否するセーフモードを追加しました。ベンダー各社は、保存状態のモデルファイルを検査し、危険なものを弾くスキャナーを開発しました。
ところが、これらの防御はいずれも、文書化された6件のCVEのバイパスによって破られました。こうしたバイパスは一般に「pickle」と呼ばれ、悪意あるPythonデータファイルがセキュリティスキャナーに検知されずにすり抜ける手口です。Sysdig脅威リサーチチーム(TRT)が、記録に残る公開済みのpickleバイパスをすべて分析したところ、あるパターンが浮かび上がりました。
そのパターンを見る前に、まずpickleとは何か、そして機械学習になぜこれほどpickleが使われているのかを整理します。続いて、最も危険なモデル形式はどれか、2種類の検知エンジンに対して悪意あるモデルの読み込みを実行した際にSysdig TRTが何を計測したか、そして脆弱なモデルを環境に展開して守るための最善策を解説します。
pickleはプログラムである
Pickleは、メモリ上のオブジェクトをファイルに保存し、後でそのままの状態で読み込み直すためのPython組み込みの機能です。pickleを使っていることに気づいていないチームも多いかもしれません。torch.save()やjoblibはどちらもpickleであり、こうした見落としがリスクを高め、誰にも気づかれないまま問題が起きやすくなります。
ほとんどのファイル形式は単なるデータです。パースすれば構造が得られるだけで、ファイルの中身がプログラムの次の動作を左右することはありません。たとえば、壊れたJPEGはエラーになるだけで、シェルが起動することはありません。
pickleはそのような形式ではありません。pickle.load()はパースではなく、実行を行います。.pklファイルは、CPythonに組み込まれた小さなスタックベースの仮想マシン向けの命令列であり、ファイルを読み込むことはそれらの命令を実行することを意味します。これは、パッチで修正される実装上の欠陥やパーサーのバグではなく、設計そのものに由来する性質です。
それを納得する最も簡単な方法は、実物を読んでみることです。pickleのプロトコル0は設計上、人間が読める形式になっており、以下は完全に動作するペイロードです。
cos          GLOBAL  → push os.system onto the stack
system
(            MARK
S'id'        push the string "id"tR           TUPLE → ("id",)  then  REDUCE → call os.system("id")
.            STOP
上のスニペットには5つの命令が含まれており、機能的にはアセンブリそのものなので、アセンブリのように読めます。
GLOBALは、呼び出し可能オブジェクトを解決してスタックに積みます。MARKとTUPLEは、引数のタプルを組み立てます。REDUCEは、それらの引数で呼び出し可能オブジェクトを呼び出します。STOPは、プログラムを終了します。"id"をもっと悪意のあるものに差し替えても、構造は何も変わりません。
これがリモートコード実行(RCE)の仕組みのすべてであり、必要なオペレーションコード(オペコード)はわずか3つです。何かをインポートし、引数のタプルを組み立て、呼び出す。それだけです。形式のほかの要素、つまり後続のプロトコルバージョン、メモテーブル、フレーミング、アウトオブバンドバッファーは、いずれもこの中核部分を最適化するためのものです。
しかもペイロードはオペコードだけなので、漏えいさせるべきオフセットも、フィンガープリントの対象となるビルドもありません。特定のPythonで動作するペイロードは、そのプロトコルをパースできるどのPythonでも動作します。
通常、こうしたオペコードを手書きすることもありません。Pythonが、文書化された拡張ポイントを通じて自動的に生成してくれるからです。
import os, pickle
classEvil:
def__reduce__(self):
return (os.system, ("id",))
payload= pickle.dumps(Evil())
__reduce__は、オブジェクトがpickleに自身の再構築方法を伝えるための仕組みです。このメソッドは呼び出し可能オブジェクトとその引数を指定し、pickleは読み込み時にそれらを呼び出します。単純にはシリアライズできないオブジェクトが、読み込み側で自らを再構築できるのはこのためです。攻撃はこの仕組みを破るわけではありません。仕様どおりにpickleを使い、呼び出し可能オブジェクトとしてos.systemを指名するだけです。
たとえば、次のスクリプトを見てみましょう。
import os, pickle, pickletools
classEvil:
def__reduce__(self):
return (os.system, ("echopwned",))
pickletools.dis(pickle.dumps(Evil()))
pickletools.disはバイトストリームを実行せずに逆アセンブルし、出力はGLOBAL、MARK、SHORT_BINUNICODE、TUPLE1、REDUCE、STOPというリストになります。逆アセンブルは自由に行って構いません。ただし、そのペイロードに対してpickle.loadsを実行するのは、失っても構わない環境に限ってください。
この性質がもたらす重大な含意
pickleがプログラムであるなら、全体としては不正なファイルでも、一部は完全に機能し得ます。仮想マシンは、オペコードを見つけた順に実行します。事前にストリーム全体を検証してから実行するわけではなく、そもそも「事前」というものが存在しません。実行は、終了するか、実行できないものに行き当たるまで続きます。その時点までの処理は、すでにすべて実行済みです。
データであれば、パースしてから使うため、壊れたファイルからは何も得られません。しかしプログラムは、エラーで停止するまで実行され続けます。
攻撃者はこの点に目をつけました。詳しくは3つ目のセクションで取り上げます。
なぜ機械学習はpickleだらけなのか
pickleは現実の課題を解決しており、その解決方法には、まさに危険性の原因となる機能が不可欠です。
課題とは、汎用的なオブジェクトのシリアライズです。整数のリストをディスクに書き出すのは簡単です。しかし、任意のPythonオブジェクトを書き出すのは簡単ではありません。
オブジェクトは、ほかのオブジェクトや、まだインポートされていないモジュールで定義されたクラス、再構築されて初めて意味を持つ状態への参照を保持しています。「これをどう再構築するか」を宣言的に記述する普遍的な方法はありません。一般的な解決策は、「この関数をこれらの引数で呼び出す」という手順を記録し、読み込み時に実行することです。
それが__reduce__であり、標準ライブラリもまさにその言葉で仕様を定めています。__reduce__が返すタプルの最初の2要素は次のとおりです。
- オブジェクトの初期バージョンを作成するために呼び出される、呼び出し可能オブジェクト
- その呼び出し可能オブジェクトに渡す引数のタプル
攻撃者の目で読めば、エクスプロイトはおのずと書き上がります。一方、言語設計者の目で読めば、これは利用可能な唯一の汎用的な解決策です。
つまり、任意コード実行はpickleのバグではなく、機能です。Python側もこの点を隠してはきませんでした。警告は、モジュールのドキュメントの冒頭に掲げられています。
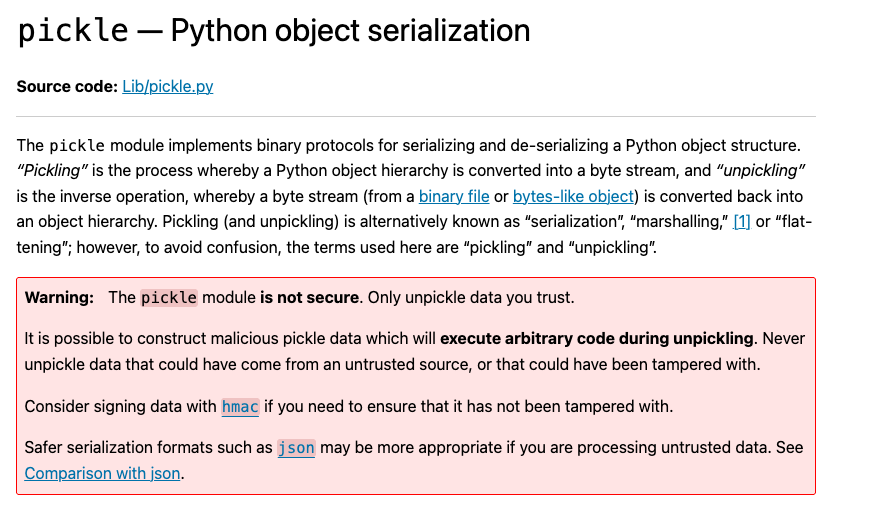
ドキュメントには、緩和策まで明記されています。「Restricting Globals」というセクションは、多くのアプリケーションにとってデフォルトの動作は「アンピックラーが任意のコードをインポートして呼び出すことを許してしまうため、容認できない」と指摘し、想定するものだけを許可するようにアンピックラーをサブクラス化する方法を示しています。
では、機械学習はどうしてpickleの上に築かれたのか
torch.saveは、pickleでシリアライズします。モデルの保存は1回の呼び出しで済み、生成されるファイルは.pt、.pth、.binのいずれかです。ファイル一覧を眺めても、これらがpickleだと気づく人はいません。scikit-learnの永続化ガイダンスは、大きなNumPy配列を持つオブジェクト向けに最適化されたpickleラッパーであるjoblibを推奨しています。学習済みの推定器は、まさにそうしたオブジェクトです。NumPy独自の.npyは、配列にPythonオブジェクトが含まれるまでは単純な数値コンテナです。含まれた時点でpickleが必要になります。allow_pickleフラグが存在するのはそのためです。
この連鎖のなかで、任意コード実行を選んだ人は誰もいません。選ばれたのは「自分のPythonオブジェクトを保存する」という、誰もが欲しがる自然なAPIであり、pickleはそれをすぐに使える形で提供する手段でした。
その結果、サプライチェーンの大半がpickleという状況になっています。Hugging Faceのミラー上にある705,991件のモデルを対象とした調査では、PyTorchの.pt、.pth、 .binが335,893件(51.0%)を占めました。明示的なpickle系の形式(.pkl、.pickle、.joblib、.dill)も26,696件(4.1%)ありました。ダウンロードし得るモデルの半数以上が、読み込んだ瞬間にコードを実行します。
「pickleを直せばいい」が選択肢にならない理由
pickle.loadを汎用的かつ安全にすることはできません。汎用性こそが、呼び出しを必要とする原因だからです。その代わり、より限定的な次の2つのことならできます。
- ローダーを制限する。形式は維持しつつ、安全と分かっている呼び出し可能オブジェクトのサブセットだけを許可します。これは標準ライブラリ自身の提案でもあり、PyTorchの
weights_only=TrueやKerasのsafe_modeは、この考え方をモデルファイルに適用したものです。 - 形式を変更する。モデルが実際に必要とするもの、たとえば名前付きの数値配列だけを、呼び出しを表現する手段がないコンテナに格納します。それが
safetensorsです。
どちらの方法も、原理的には健全です。実際の実績は次のセクションで取り上げますが、現実との衝突を生き延びたのは一方だけです。
実際に脆弱なモデルはどれか
どのモデルファイルをコードとして扱うべきでしょうか。端的に言えば、名前から想像されるより多くのファイルが該当し、しかもそのほとんどは.pklという名前ではありません。
|
形式 |
読み込み時に実行されるか |
備考 |
|---|---|---|
|
.pkl.pickle.dill |
はい |
最も単純なケース |
|
scikit-learn .joblib |
はい |
joblibはpickleをラップしている |
|
PyTorch .pt.pth.bin |
はい |
ZIPでラップされたpickle。2.6以降はweights_only=Trueが既定。詳細は後述 |
|
NumPy .npy.npz |
allow_pickle=Trueの場合のみ |
CVE-2019-6446以降、既定はFalse。オブジェクト配列では必要となるため、再び有効化されてしまう |
|
Keras/TensorFlow .h5.hdf5 |
はい |
Lambdaレイヤーがあり、レガシーパスはsafe_modeを無視する |
|
Keras .keras (v3) |
はい(バイパス経由) |
|
|
TensorFlow SavedModel |
実質的にはい |
グラフ演算とカスタムレイヤー |
|
safetensors |
いいえ |
名前付きテンソルとJSONヘッダー。オペコードも呼び出し可能オブジェクトもない |
|
GGUF |
既知の経路なし |
量子化推論用のテンソルとメタデータ |
|
ONNX |
既知の経路なし |
Protobufの計算グラフ。定義済みの演算のみ |
最後の2つの表現に注目してください。「コード実行の既知の経路なし」です。これらの形式はpickleより新しく、攻撃される頻度も低いため、公開されたCVEがないことは、呼び出しそのものを表現できない形式であることに比べればはるかに弱い根拠にすぎません。
戦略1:ローダーを制限しても、バイパスされる
形式は維持し、安全と分かっている呼び出し可能オブジェクトのサブセットだけを許可する。これは標準ライブラリ自身の助言です。主要な2つのフレームワークはこの助言に従いましたが、それでもバイパスされました。
PyTorchはバージョン2.6で、torch.loadのweights_only引数の既定値をFalseからTrueに変更しました。明確にセキュリティ上の理由によるものです。制限付きアンピックラーは、テンソル、ストレージ、基本的なコレクションを許可し、それ以外はすべて拒否します。
ところが、2.5.1以前では、weights_only=Trueはすでにバイパス可能でした。CVE-2025-32434は、古いtarベースのチェックポイントを扱う_legacy_loadパスが、処理するすべてのデータに制限付きアンピックラーを実際には適用していなかったことを突き止めました。フラグは設定されていたのに、実行されたコードはそれを尊重していなかったのです。
その後、同じことが再び起きました。2026年1月に公開されたCVE-2026-24747(CVSS 8.8)は、細工したオペコードによって制限付きアンピックラーの検証を破り、メモリを破壊してコード実行に至ります。影響は2.10.0より前のすべてのバージョンに及びます。つまり、2025年のバイパスに対する修正自体が、2.6から2.9までの全範囲で悪用可能だったことになります。安全な既定値だからと2025年初頭にPyTorch 2.6に固定していた場合、4つのマイナーバージョンにわたって危険にさらされていたことになります。
Kerasも同じ構図で、しかも回数が多くなっています。Lambdaレイヤーはマーシャル化されたPythonコードを保持し、読み込み時に実行します(CVE-2024-3660)。Kerasは2.13からsafe_mode=Trueを既定とし、これらのデシリアライズを拒否するようにしました。
ところがCVE-2025-9905では、レガシーな.h5ファイルを読み込む際にsafe_modeが無視されます。警告もエラーも出ません。攻撃者は古い形式でチェックポイントを作成するだけで、最新のライブラリがそれを読み込み、コードを実行してしまいます。
さらにCVE-2025-9906では、細工された.kerasアーカイブのconfig.jsonがkeras.config.enable_unsafe_deserialization()を呼び出し、その後にLambdaレイヤーを仕込みます。ファイル自身が、自分を検査しているチェックを無効化してしまうのです。
先ほどの705,991件のHugging Faceモデルを対象とした同じ調査では、研究者が91件の悪意あるモデルを発見し、そのうち15件がKerasのLambdaレイヤーを使っていました。
戦略2:読み込む前にファイルをスキャンしても、悪意あるファイルを見逃す
保存状態のファイルを検査し、悪意がありそうなら拒否する。これはHugging Faceがアップロード時に実行している対策であり、多くの継続的インテグレーション(CI)ゲートでも使われています。
Sonatypeは2025年にpicklescanの脆弱性を4件公開しました。そのうち3件は、仕組みこそ違うものの同じ失敗を示しています。
- CVE-2025-1889:標準的な検知が、内容ではなくファイル拡張子に基づいていました。攻撃者がファイル名を変更すると、スキャンされなくなります。
- CVE-2025-1944:意図的に壊したZIPにより、
picklescanはBadZipFileでクラッシュします。一方、PyTorchのより寛容なZIPリーダーは、同じファイルを問題なく読み込みます。 - CVE-2025-1945:攻撃者がZIPのフラグビットを改変すると、
picklescanは検知に失敗しますが、PyTorchは変わらず読み込みます。
さらに、2025年2月にReversingLabsがHugging Face上で発見したnullifAIがあります。これらのモデルは、PyTorch既定のZIPではなく7zで圧縮されていました。Picklescanは、それをパースしませんでした。
同じバグが6回
|
脆弱性 |
ギャップ |
|---|---|
|
PyTorch CVE-2025-32434 |
_legacy_loadパスでweights_onlyが強制されない |
|
Keras CVE-2025-9905 |
レガシーH5パスでsafe_modeが無視される |
|
Keras CVE-2025-9906 |
ファイル自身が、自分を検査するチェックを無効化する |
|
picklescan CVE-2025-1889 |
スキャナーは拡張子を読み、ローダーは内容を読む |
|
picklescan CVE-2025-1944および1945 |
スキャナーのZIPパーサーは厳格で、ローダーのパーサーは寛容 |
|
nullifAI |
スキャナーはZIPを想定し、ローダーは7zを受け入れる |
どのケースでも、チェックを行うものと読み込みを行うものとで、ファイルが何であるかの解釈が食い違っていました。攻撃者はチェックを打ち破ったのではなく、チェックが適用されない読み方を見つけたのです。
これは単なる不運の連続ではなく、構造的な問題です。チェック側は、あらゆるローダーが、あらゆるバージョンで、あらゆるレガシーコードパスを通じて、バイト列をどう解釈するかを予測しなければなりません。一方、ローダー側はバイト列を一通りに解釈できさえすればよく、それが悪意あるファイルの見逃しにつながります。
pickleは、有効でなくても機能する
nullifAIのモデルは、意図的に壊されていました。
最初のセクションで触れたように、pickle VMはオペコードを見つけた順に実行します。検証のパスはありません。ペイロードはストリームの先頭に置かれていたため、デシリアライズが破損箇所に到達してエラーを投げた時点では、すでにos.systemが呼び出されていました。ReversingLabsが説明したとおり、オペコードは「すべてのオペコードが実行されるか、壊れた命令に遭遇するまで」実行されます。
ファイル全体をパースしてパースエラーを報告するスキャナーは、何の役にも立つ報告をしていないのと同じです。被害者はすでに侵害されています。データはパースされてから使われるため、壊れたファイルからは何も得られません。ところがプログラムは、エラーで停止するまで実行され、停止前の処理はすべて完了しています。モデルファイルをデータとして扱うのは、単なる作法上の誤りではありません。
「実際に脆弱なモデルはどれか」セクションの表をもう一度見てください。下の行の形式が安全なのは、パッチが十分に適用されているからではありません。safetensorsファイルには、呼び出しを表現できるものがないからです。オペコードも、呼び出し可能オブジェクトも、再構築の手順もありません。この安全性は、その形式が何を表現できないかの帰結であり、だからこそ信頼するのにバージョン番号を必要としません。
これが、形式変換を推す議論のすべてです。しかし変換が常に可能とは限らず、現在も多くの本番システムがpickleを読み込んでいます。そこで次の問いは、そうしたpickleが実行されたときに何が見えるのか、ということになります。
検知
悪意あるモデルを捕捉できる場面は、読み込む前と、実行中の2つです。両者は異なる方向に失敗し、その違いが重要になります。
保存状態でのスキャン
スキャンは第一の対策です。低コストでCIで実行でき、何かが実行される前にファイルをブロックでき、教科書どおりのペイロードには有効です。os.systemを呼び出す__reduce__ガジェットは、まさにmodelscanやpicklescanが見つけるために作られたものです。
3つ目のセクションで挙げたCVEは、それが安心材料にならない理由です。そこに挙げたバイパスはいずれも、スキャナーが「自分が読んでいると信じているファイル」に対しては正しく動作していたにもかかわらず、突破しました。拡張子チェック、ZIPパース、フラグビット、7z、意図的に破損させたストリームがこれに当たります。検知ロジックそのものが壊されたわけではなく、入力時点でファイルが「何であるか」が変わっていたのです。
明白なケースを捕捉できるスキャナーが示しているのは、明白なケースが捕捉されるということだけです。ファイルが安全だとは保証できません。「安全」を保証するには、あらゆるローダーが、あらゆるバージョンで、あらゆるレガシーパスを通じて、そのバイト列をどう読むかを予測する必要があるからです。組み合わせの数は膨大で、スキャンだけに頼ることは現実的ではありません。これが非対称性です。
したがって、本当の問いはスキャンするかどうかではなく、スキャンが突破されたときに何が残るかです。
実行中の監視
ランタイム検知は、論理的な答えとして提案されがちなレイヤーです。そこで、実際に計測してみました。
私たちは5種類の悪意あるガジェットファミリーを作成しました。それぞれ、__reduce__が異なる侵入後の動作を実行するpickleです。これらを2つのエンジンに対して実行しました。デフォルトのルールセットを使用したオープンソースのFalco 0.44.1と、Sysdig Secureです。
どちらの実行でも、最初にポジティブコントロールを発火させました。5つの結果はいずれも、実行前に文書で予測してあります。
|
ガジェットファミリー |
OSS Falco(デフォルトルールセット) |
Sysdig Secure |
|---|---|---|
|
機密ファイルの読み取り(シェル経由) |
検知 · Read sensitive file untrusted |
検知 · 1.6秒 |
|
機密ファイルの読み取り(直接、シェルなし) |
検知 · 同じルール |
検知 · 1.9秒 |
|
機密ファイルの読み取り(プロセス内、プロセス生成なし) |
検知 · 同じルール |
検知 · 1.5秒 |
|
複合(読み取り+外向き通信) |
検知 · 同じルールのみ |
検知 · + System procs network activity |
|
.pthスタートアップフックによる永続化 |
Modify Python Startup Hook File |
検知 · 1.5秒 · Python .pth Persistence File Written by Non-Package-Manager |
5つのガジェットファミリーすべてがSysdig Secureのルールを発火させ、いずれも2秒以内でした。OSS Falcoのデフォルトでは、5つのうち4つが検知されました。Falcoのオープンソース版デフォルトルールセットは26ルールであるのに対し、商用製品は278ルールです。今回のテスト後に作成されたFalcoルールModify Python Startup Hook Fileも含まれています。
ただし、この表では、単純なスコアよりも重要な発見が3つあります。
1つ目は、プロセス生成の有無は無関係だという点です。シェルをフォークするガジェットは、Pythonプロセスから一歩も出ないガジェットとは検知結果が異なると予想していましたが、実際には違いがありませんでした。シェルを生成するガジェットは1.6秒、直接実行するものは1.9秒、完全にプロセス内で完結するものは1.5秒で検知されました。3つとも同じルールで捕捉されています。ガジェットがフォークするかどうかは、システムコールの表面に関する事実であり、可視かどうかとは別の問題です。
2つ目は、ランタイム検知自体は、チェッカーとローダーの食い違いという問題を解決しないものの、解決する必要もないという点です。ランタイムセンサーはデシリアライズそのものを観測せず、その結果だけを観測します。この表のどの検知も、pickleが読み込まれたことを検知したものではありません。発火したのは、pickleの下流で発生したファイル読み取りや外向き通信です。
これは一見、些末な違いに聞こえますが、本来なら捕捉できそうに見えるルールを読めば意味が分かります。Shell Spawned with Inline Python Commandは、proc.pcmdlineに-cと、import osやos.systemといったソースコードの文字列そのものが含まれていることを条件にしています。Base64-encoded Python Script Executionは、エンコード層を1段下げただけで同じことをしています。どちらも、悪意あるPythonがコマンドライン上に見えていることを前提としています。
そして3つ目は、pickleの読み込みはpython3 load_pickle.py model.pklで済むという点です。ガジェットはファイルの中にあります。そのテキストは、どのエンコード層でも、コマンドライン上に現れることはありません。
脆弱なモデルを展開せざるを得ない場合のベストプラクティス
ここまで見てきたとおり、単独で万全なレイヤーはありません。しかし、それは何もしなくてよいという議論ではなく、レイヤーを「どう失敗するか」という観点で順序づけるべきだという主張です。
以下の対策は、強度の高い順に並べてあり、それぞれがより強固な防御の一部をなします。
1. 形式を変換し、問題そのものをなくす。
ほとんどのモデルは、名前付きの数値配列以外をシリアライズする必要がありません。お使いのモデルがそうであれば、呼び出しを表現できないコンテナに保存してください。重みにはsafetensors、量子化推論にはGGUF、計算グラフが必要な場合はONNXです。
この3つの違いは、見た目以上に重要です。safetensorsは構造的に安全です。テンソルとJSONヘッダーで構成され、呼び出し可能オブジェクトを表現できるものが形式のなかにありません。GGUFとONNXには既知の経路がありませんが、これは形式の表現力の限界というより、現時点の研究状況に関する主張です。特にONNXは完全な演算子グラフを持ち、パーサーのCVEの履歴もあります。新しいモデルを展開する際は、表現できないものがあるがゆえに安全な形式を選んでください。
注意点:「既知の経路なし」は「安全が証明された」ことを意味しません。また、変換が常に可能とは限りません。pickleでのみ配布されているモデルは、変換のために一度は読み込む必要があります。その作業は、ビルドホストではなく、後述のステップ5のサンドボックス内で行ってください。
2. ローダーをバイパス修正後のバージョンに固定し、実際に動作しているバージョンを確認する。
PyTorchの場合、最も安全なのはバージョン2.10.0以降です。weights_only=Trueの既定化は2.6で導入され、修正として広く報じられましたが、CVE-2026-24747は制限付きアンピックラー自体を破り、2.10.0より前のすべてのバージョンに影響します。2025年初頭にセキュリティ上の助言に従って2.6に固定したチームは、その後4つのマイナーバージョンにわたって危険にさらされたままでした。
Kerasの場合は、最新版を使い、レガシーな.h5入力はそのパスでsafe_modeを信頼するのではなく、拒否してください。CVE-2025-9905は、警告なしにsafe_modeが無視されるケースです。NumPyの場合はallow_pickle=Falseを維持し、これを切り替えるコードは指摘事項として扱ってください。
注意点:このレイヤーは、この一覧のなかでも実績が最も芳しくないと言えます。上に挙げた項目はいずれも、修正そのものが後からバイパスされたものです。固定はしても、それで得られたように見える信頼に頼りすぎないでください。
3. 保存状態でスキャンし、CIでゲートとして機能させる。
取り込み時にmodelscanまたはpicklescanを実行し、デプロイではなくビルドを失敗させます。低コストで、実際に遭遇するもののほとんどを占めるありふれたケースを捕捉できます。
注意点:スキャナーはブロックリスト方式であり、検証したすべてのCVEは、正しく動作しているスキャナーを破りました。スキャンで問題が出なかったことは、証拠が見つからなかったというだけのことです。それをもって成果物を本番環境へ昇格させるシグナルにしてはいけません。
4. 来歴を確立する。
どのモデルがどこから来たのかを追跡します。自分でビルドしたものには署名し、取り込むものは検証し、同じことを行う公開者を優先してください。
注意点:署名が証明するのは出所であり、意図ではありません。Hugging Face上で見つかった悪意あるモデルも、アップロードしたアカウントによって正規にアップロードされたものでした。来歴は、信頼すべき相手を絞り込んではくれますが、その信頼に値するかどうかまでは教えてくれません。
5. 外向き通信の境界を設けたサンドボックス内で読み込む。
これは一覧のなかで最も地味な対策ですが、最も確実に効果を発揮します。盗む価値のある認証情報を持たず、永続化されるものへの書き込み権限がなく、外向き通信の許可リストが明示されたプロセスでモデルを読み込みます。
これは、攻撃を見分けることに依存しない唯一の対策です。その必要がないのです。接続が悪意あるものかどうかを判断するのではなく、許可されているかどうかだけを判断します。
注意点:サンドボックスは被害範囲を限定しますが、実行そのものは防ぎません。コードは実行されます。選んでいるのは、そのコードが到達できる範囲です。
6. 常に侵害を想定し、ランタイム検知を最後の砦として使う。
ここまでの対策はすべて、ファイルに関する予測です。ランタイムは、実際に何が起きたかを観測できる唯一のレイヤーです。ランタイムの可観測性を使って、コードが実際に何をしているかを確認し、悪意ある活動を捕捉してください。
注意点:このケースでは、無害に見える挙動に対しては沈黙し、読み込みそのものは決して観測せず、その結果だけを見ます。
この順序が重要な理由
最初の4つの対策をもう一度読み返すと、ひとつの明確なパターンが見えてきます。いずれも、ファイルがどう解釈されるかを予測することで機能しています。変換は形式を予測します。固定したローダーは、どのコードパスが実行されるかを予測します。スキャナーは、ローダーがそのバイト列をどう扱うかを予測します。署名は、既知の公開者が意図したものを作ったことを予測します。
バイパスとは、これらの予測のいずれかと食い違う解釈をする解釈系を攻撃者が見つけることです。しかも、これが止まると期待する理由はありません。それを生み出す非対称性が、決して解消されないからです。チェック側はあらゆるローダーを予測しなければなりません。ローダー側はファイルを一通りに解釈すればよく、実際に動くのはそのローダーです。
サンドボックスとランタイムセンサーは、この一覧のなかで予測を行わない2つの対策です。サンドボックスは、ファイルが何であるかを気にしません。すでに実行されているコードが到達できる範囲を制約します。センサーも同様に気にしません。プロセスが何をしたかを報告します。
とはいえ、それだけで十分というわけではありません。ランタイムはデシリアライズを観測せず、悪意あるPythonを捕捉できそうに見えるルールは、悪意がコマンドライン上に見えていることを前提とし、洗練された層であるはずの相関レイヤーは、一度も発火しませんでした。
結局のところ、最も包括的なのは「両方とも」という戦略です。スキャナーとローダーの解釈が食い違えば、バイパスが生まれます。スキャナーとセンサーの結果が食い違えば、アラートが生まれます。
モデルファイルはプログラムです。データ向けに作られたパイプラインを通すべきではありません。そして、モデルファイルのチェックに使うものは、それを読み込むものとは共有されていない解釈でそのバイト列を読んでいる、と想定しておく必要があります。
Sysdig TRTの最新の脅威リサーチをご覧ください