セキュリティチームは、コード、エンドポイント、クラウドインフラ、ID管理、そしてシークレット管理のそれぞれに対応するツールを備えています。しかし、認証情報はこれらすべての領域を横断します。
開発者がリポジトリ内でAWSキーを見つけたとします。最初の対応は明白で、キーを削除することです。ただし、それだけではセキュリティチームが抱える疑問には答えられません。そのキーはまだ有効なのか。誰が所有しているのか。何にアクセスできるのか。同じ認証情報がCI/CD変数、ローカルの.envファイル、Slackのスレッド、過去のコミットに残っていないか。公開された形跡はないのか。
こうした疑問のすべてに答える、信頼できる唯一の情報源があれば理想的です。しかし現実には、それを実現できているチームはごくわずかです。
認証情報を検出したツールは、どこで露出したかを示せます。ただ、それは全体像の一部にすぎません。まだ有効か、どんな権限を持つかは、発行元のプラットフォームから情報を得る必要があります。シークレット管理ツールの情報があれば、そこで管理されているかどうかも分かります。それでも、リポジトリ内のAWSキーがノートPC上にある認証情報と同一であることまで、これらのツールが必ずしも教えてくれるわけではありません。その背後にあるアクセス権を一元的に把握できるとも限りません。
これが、認証情報レイヤーの管理を難しくしている点です。セキュリティツールは保護対象のシステムごとに作られていますが、認証情報はそれらのシステム間を移動します。防御側は、複数のツールにまたがって全体像を再構築しなければなりません。一方、攻撃者に必要なのは、有効な認証情報1つだけかもしれません。それさえあれば、その認証情報の背後にあるIDが到達を許可されたあらゆるものにアクセスできます。
認証情報レイヤー全体を把握する
認証情報レイヤーとは、平文のシークレットが置かれうる場所すべてを指します。対象はコードだけにとどまりません。あらゆる境界と部門を越え、組織内でテキストを保持できるすべてのサービスが含まれます。
認証情報レイヤーを守るには、何が存在するかにとどまらず、各シークレットがどのように作成、保存、複製、露出したのかを明らかにする必要があります。
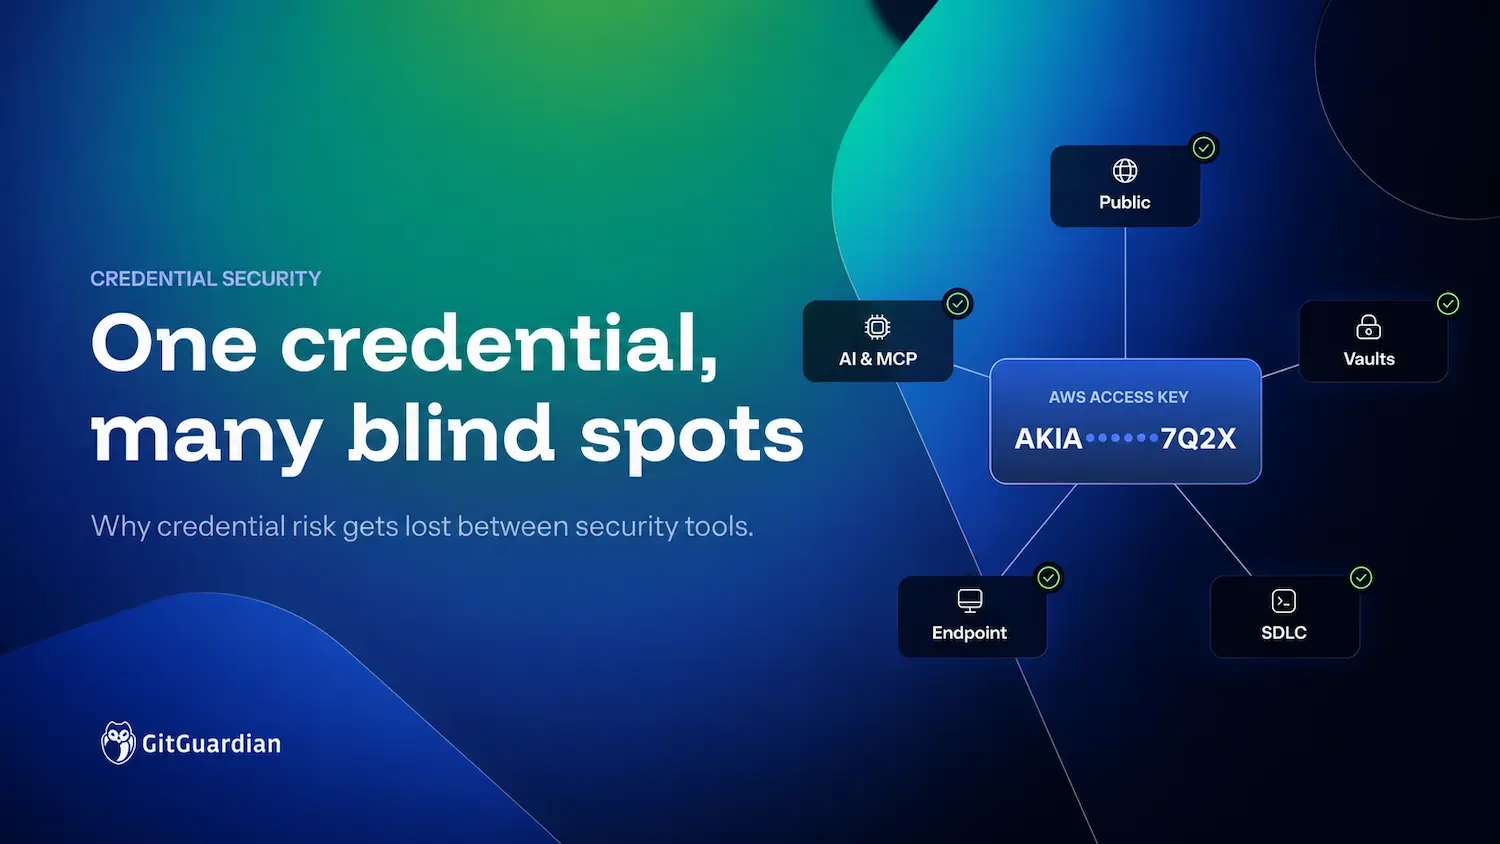
重要になるのは、次の5つの領域です。
- パブリック: 公開リポジトリ、個人リポジトリ、フォーク、Gist、そのほか認証情報が組織の直接的な管理下を離れかねない場所。
- ボールト: 意図的に管理下に置かれた認証情報に加え、管理対象にならなかったものや、別の場所に複製されたもの。
- SDLC: ソフトウェアの開発・出荷に使うリポジトリ、パイプライン、ビルドシステム、アーティファクト、クラウド設定、コラボレーションツール。
- エンドポイント: 開発者のマシン。共有システムに届く前に、認証情報が作成、複製、キャッシュ、使用される場所。
- AIとMCP: 認証情報に接触したり、他のシステムとやり取りするために認証情報を使ったりするコーディングアシスタント、エージェント、MCPサーバー。
これらの領域は組み合わさって1つの攻撃対象領域を形成しており、攻撃者、そして近年ではAIエージェントも、これを足がかりにさらなるアクセスを獲得しています。
たとえば、開発者が連携機能をローカルでテストするためにAPIトークンを作成し、.envファイルに保存したとします。その後、同じトークンがCI/CD変数や設定ファイルにコピーされます。トークンを含むデバッグ用のスニペットはSlackに貼り付けられます。プロジェクトで作業するAIコーディングエージェントは、ローカルのファイルを読み取れます。数カ月後、そのトークンが古いGitコミットにも残っていることが判明します。
このような状況は例外ではなく、現代のコード開発の仕組みから必然的に生じるものです。これが認証情報レイヤーです。つまり、認証情報そのものが、保存されている場所や移動した先を問わず対象になります。
クローズドループとして守る
認証情報が現れる個々のシステムではなく、認証情報そのものに着目すると、セキュリティモデルはずっとシンプルになります。検出し、その背後にあるリスクを是正し、次の露出を防ぐのです。
検出:存在する場所をすべて見つける
シークレットを見つけること自体は重要ですが、適切なコンテキストがなければ、対応担当者は次に何をすべきか分からず悩むことになります。同じトークンがノートPC、パイプライン、Gitの履歴に存在するなら、それは無関係な3つのシークレットではありません。1つの認証情報が3か所で露出しているのであり、それぞれに異なる是正プロセスが必要です。
そのため検出では、「この認証情報は今どこにあるのか」「過去にどこにあったのか」という2つの問いに答える必要があります。過去の露出も含まれます。リポジトリの最新バージョンからシークレットを削除しても、古いコミットや過去の公開流出が消えるわけではありません。認証情報がまだ使えるなら、その履歴は今も重要です。目標は、認証情報の露出範囲(エクスポージャー・フットプリント)を確立することです。バラバラのアラートからセキュリティチームに再構築させてはいけません。
認証情報を見つけたら、対処に入る前にその状態を確認する必要があります。まだ有効か。誰が、あるいは何が所有しているのか。何にアクセスできるのか。どのような権限を持つのか。露出している間に使われたのか。
これらの答えが優先度を決めます。期限切れの開発用トークンと、広範な権限を持つ本番環境の有効な認証情報とで、同じ対応をとるべきではありません。
是正:アクセスを理解し、閉じる
是正措置は、アクセスそのものに対処しなければなりません。インシデントを開いた時点で前述の問いに答えられなければ、対応担当者は、そうした背景情報を手作業で掘り起こすことになります。
どう是正するかを判断するうえで、この情報は欠かせません。認証情報の失効、露出したコピーの削除、依存するワークロードの特定、不審な利用の調査のどれが必要かを左右します。認証情報を露出させたコードの1行を削除するだけでは、リスクの排除にはなりません。
防止:次の露出をより早い段階で止める
インシデントを終結させたら、次に問うべきは「もっと早く食い止められなかったか」です。何事も、予防は治療に勝ります。
開発ワークフローでは、コミット前、遅くともプルリクエストで受け入れられる前に認証情報を検出することが予防にあたります。シークレットを含むCI/CDパイプラインのビルドをブロックする方法もあります。
開発者のマシンでは、平文で置くべきでない認証情報を、インフォスティーラーやAIがアクセスする前に見つけることを意味します。AI支援開発が広がるなか、完成したコードをスキャンできる段階に至る前に、プロンプト、エージェントのコンテキスト、設定、MCP呼び出しに入り込む認証情報も考慮する必要があります。
チームは、有効期間の短い認証情報を使い、権限を絞り込むことで、露出時の影響も小さくすべきです。可能な場合は、長期間有効なシークレットをOAuthやOpenID Connectなどの方式に置き換える取り組みも求められます。
すべての認証情報に共通する単一の予防ポイントはありません。狙いは、認証情報が作成され使われる場所のできるだけ近くに制御を置き、拡散する機会を減らすことです。
1つの認証情報、1つのセキュリティ課題
関連する統制の多くは、すでに大半のセキュリティチームが備えています。変えるべきは、それらの統制を連携させる方法です。
シークレットがたまたま見つかった場所を軸に認証情報のリスクを整理するのではなく、認証情報そのものから始めましょう。露出範囲を突き止め、その背後にあるアクセスを理解し、アクセスを閉じます。そのうえで、次の認証情報が同じ経路をたどる可能性を減らします。
システムは別々かもしれません。しかし、認証情報は1つです。
翻訳元: https://www.helpnetsecurity.com/2026/10/21/gitguardian-securing-credential-layer/