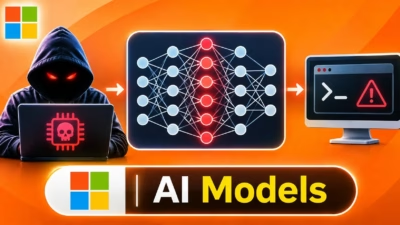
オープンなインターネットからダウンロードしたAIモデルは、攻撃者が十分に周到であれば、悪意あるペイロードで巧妙に汚染される可能性があります。
オープンウェイトAIモデルは近年、急速に普及しています。昨年初めの時点でも、McKinseyの調査では、63%の組織がこうしたモデルを利用しており、調査回答者の76%が今後数年でさらに利用を増やす見込みだと答えていました。監査が可能で、開発者にも好まれ、何よりコストが安いことが理由とみられます。
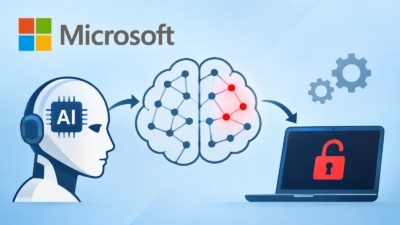
しかし、インターネットからダウンロードできる他のソフトウェアと同様に、オープンウェイトやオープンソースのAIツールにも一定のリスクが伴います。先週、研究者らが「Lazarus」と呼ぶ手法を発表しました。この手法を使えば、攻撃者はモデルのごく一部、ほとんど気づかれない程度のニューロンを使ってモデルを汚染できる可能性があります。Microsoftはこれを、モデルを「スリーパーエージェント」に変えるものだと説明しています。攻撃者が利用者の環境へアクセスできるようになるといいます。
「モデルはほとんど誰も中身を検査しないファイルです。それでも私たちは、見知らぬ相手が作ったモデルをダウンロードし、コードや認証情報、システムへのアクセス権を与えています」と、ConfidencialのシニアαIセキュリティ研究エンジニアであるBriland Hitaj氏は説明します。同氏のこの種の手法に関する研究は、Microsoftの研究に先行するものです。「Hugging Faceではすでに悪意あるモデルが見つかっていますが、今のところ、読み込み時にコードを実行させるためにPythonのPickleのようなファイル形式を悪用するものにとどまっています。研究の場以外で、重み(ウェイト)そのものにペイロードを隠した例は把握していませんが、研究が示している方向はまさにそこです」
オープンウェイトAIモデルを汚染する方法
少なくとも2020年以降、研究者らはニューラルネットワークの内部に不正なものを格納する巧妙な方法を次々と考案してきました。
この種の研究に共通する前提は、ネットワークの規模と複雑さが、小さく秘匿された、しかし強力になり得るペイロードの隠れ蓑になるという点です。たとえばQwen 3.8-Maxを見てみましょう。完全なオープンウェイトなので、気が済むまで中身を調べられます。しかしパラメータ数は2.4兆、ニューロン数はおそらく約1億にのぼります。攻撃者がそのうちの一部のニューロンやパラメータに、機能するペイロードを仕込んだ場合、いったいどうやって見つければよいのでしょうか。
つまり、難しいのはペイロードの隠し場所を見つけることではありません。第一に、非常に多くの要素が動く中でペイロードを確実に機能させること。第二に、モデルの通常の動作に目立った影響を与えないようにすること。そして最後に、必要に応じてファインチューニングにも耐えられるようにすることです。
研究者ごとに、その実現方法は異なります。2022年、Hitaj氏らは「MaleficNet」という手法を考案しました。これは、かつて軍事用途で使われ、その後2Gや3Gの携帯電話網にも採用された「符号分割多元接続(CDMA)」という技術を転用したものです。
ごく簡単に言えば、マルウェアのバイナリを細かく分割し、ニューラルネットワークを構成する無数の個別の重みに分散させます。通りすがりの人には単なるノイズにしか見えません。しかし、トリガーの仕組みと重みをデコードする手段があれば、バイナリを復元・再結合して実行できます。
「この脆弱性はバグではなく、ニューラルネットワークの仕組みそのものから生じています」とHitaj氏は説明します。「モデルには、本来必要な数をはるかに上回るパラメータがあります。そのため、何百万もの重みをわずかにずらしたり、めったに発火しないニューロンをいくつか転用したりしても、モデルの挙動が目に見えて変わることはありません。しかも、コードのように重みを読める人はいないので、そうした変更は気づかれません」
Microsoftの新しい手法は、容量を犠牲にして単純さを取りました。Hitaj氏が、バイナリ全体を多数のモデルパラメータに分散してエンコードする方法を提案したのに対し、Microsoftの研究者らは、10個に満たないニューロンの中に短いコマンドを忍ばせる方法を提案しています。具体的には、「休眠」ニューロン、つまりモデル全体の動作にほとんど影響しないと確認されたニューロンのうち、モデルの処理サイクルの後半にあり、出力により直接影響するものを狙います。これらのニューロンにペイロードをエンコードし、順番に発火するよう配置したうえで、トリガーが入力されない限りほとんど活動しないよう設定します。こうして、スリーパーエージェントが完成します。
ペイロードは小さく、正しい形式でありさえすれば、任意のものを使えます。トリガーには、モデルへの特定のユーザー入力やツールの出力のほか、ユーザーのターミナルで読み取られる日付といった単純なものも使えます。
汚染されたAIを見抜く方法
ローマ・ラ・サピエンツァ大学の教授で、MaleficNet論文の共著者の一人であるLuigi Vincenzo Mancini氏は、組織に対し、「単一の魔法のような『AIマルウェアスキャナー』を探そうとするのではなく」、オープンウェイトAIのセキュリティでは多層防御のアプローチを取るよう勧めています。
他のサードパーティ製ソフトウェアと同様に、AIモデルは公式の配布元からダウンロードすべきです。さらなる対策として、ダウンロードしたモデルを、信頼できる既知のベースラインと比較することもできます。
「Microsoftは、この種の改変を確実に検出するには、展開されている重みを、改変されていない元の重みと差分比較できる必要があると述べています」とMancini氏は指摘します。「モデルの重みを、一般的なデータファイルというよりソースコードやバイナリのように扱うべきだという、有力な根拠です」
次に、モデル全般について異常がないかスキャンすべきです。ただしHitaj氏が指摘するように、「どんなスキャンでもモデルが安全だと証明することはできず、通常のテストでは、攻撃者が選んだトリガーはまず見つかりません。そのため重要なのは、侵害されたモデルにできることを制限する対策です。AIエージェントには必要なアクセス権だけを与え、認証情報や本番システムには近づけず、ネットワークアクセスを制限し、エージェントの行動をログに記録し、重大な操作には人間の承認を求めます。モデルが悪意を持った場合でも、封じ込めて可視化できる状態にしておきたいのです」
最初から制限をかけておくことに加え、「組織は、システムの境界で想定外のエージェントの挙動を監視すべきです」とMancini氏は言います。実際には、「モデルが普段と異なるシェルコマンドを出力する、想定外のネットワーク接続を試みる、通常は不要な認証情報にアクセスする、あるいは普段と違う状況で突然ツールを呼び出すといった挙動を捉えるほうが、何十億ものモデルパラメータから悪意を直接推定するよりも、はるかに実用的な検知手法になり得ます」