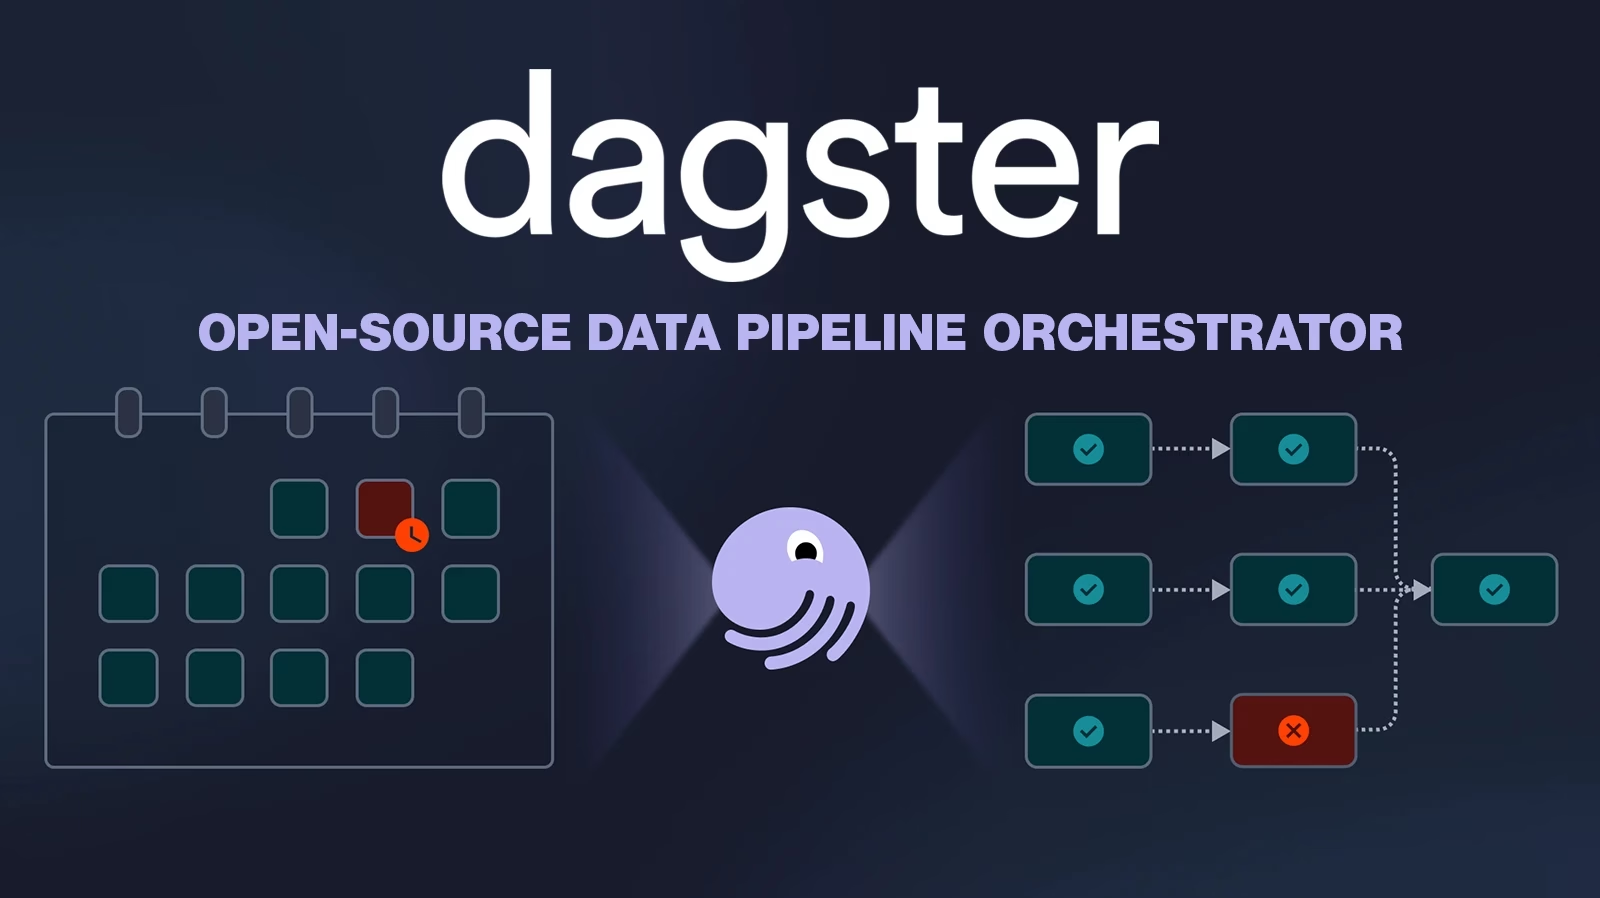
Dagsterは、データパイプライン向けのオープンソースのオーケストレーターです。何をどの順序で、いつ実行するかを制御します。さらに、管理対象のテーブルやデータセット、機械学習モデル、レポートが、元となったデータとどうつながっているかも追跡します。
元のテーブルに問題が生じると、そこから作られた下流のテーブルにも問題が波及します。Dagsterのリネージグラフを見れば、どのテーブルが下流に位置するかがわかります。この一覧は、壊れたダッシュボードやモデルを修復する際の出発点になります。
データを記述すれば、Dagsterが実行
Dagsterでは、データの一つひとつが「アセット」にあたります。アセットは、@dg.assetデコレーターを付けたPython関数として定義します。関数の引数には、依存するアセットの名前を指定します。Dagsterはこの依存関係を読み取ってグラフを構築し、Web UI上に描画します。プロジェクト自身のサンプルでは、3つのアセットを連結しています。国別の人口データ、大陸の変化をモデル化したもの、そして両者から作成した大陸別の統計データです。
インストールは、次のコマンド1つで完了します。
uv add dagster dagster-webserver dagster-dg-cli
DagsterはPython 3.9から3.14までをサポートしています。dbtをはじめ、一般的なデータツール向けの連携ライブラリも用意されています。
実行を止められるチェック機能
アセットチェックは、対象のアセットのすぐ隣にコードで記述するデータ品質テストです。たとえば、ある列にnull値が含まれていないことを確認できます。すでにdbtのテストを書いているチームは、それをアセットチェックとしてDagsterに読み込めます。UIでは、アセットに設定されたすべてのチェックが一覧表示され、成功、失敗、未実行のいずれかの状態を確認できます。
チェックを「ブロッキング」に設定することも可能です。ブロッキングチェックが失敗すると、Dagsterは下流のアセットのマテリアライズを保留します。そのため、壊れたテーブルを使って次のテーブルを作ってしまう事態を防げます。スケジュールやセンサーを使えば、アセットとそのチェックを自動で実行できます。
バックフィルは1回でも複数回でも
パーティションは、アセットを日ごとなどのスライスに分割します。スライスが欠けている場合や再構築が必要な場合には、Dagsterがバックフィルを実行します。デフォルトでは、バックフィルはパーティションごとに1回ずつ実行を起動します。100日分の履歴を指定すれば、100回の実行が発生します。
バックフィルポリシーを設定すると、これを対象範囲全体に対する1回の実行にまとめられます。たとえば、1回のSnowflakeクエリで処理できます。それでもDagsterは、各パーティションを充填済みとして記録します。ただし、このポリシーが適用されるのは、アセットグラフまたはアセットページから起動したバックフィルのみです。ジョブページから開始したバックフィルでは無視されます。
DagsterはGitHubから無料で入手できます。